아무것도 바꾸지 않은 A/B 테스트가 4번에 1번 '성공'했습니다: 『A/B 테스트』 따라 해 본 서평
이 글과 연결된 글 보기
드래그로 이동 · 휠/두 손가락으로 확대 · 방향키로 글 선택 · 0으로 맞춤. 실선: 본문 링크, 점선: 시리즈·주제의 대표 연결.표시된 글 20편 목록
같은 고객을 무작위로 반씩 나눠 아무것도 바꾸지 않은 실험(A/A 테스트)을 2,000번 돌리고, 결과를 매일 열어 보다가 p<0.05가 나오면 멈췄더니 24.8%가 “유의미한 차이”로 끝났습니다. 28일째에 한 번만 확인하면 그 비율은 5.5%입니다. 론 코하비(Ron Kohavi) 외 두 저자의 『A/B 테스트』는 이렇게 실험 결과가 믿을 만한지 먼저 확인하는 방법을 다루는 책입니다. 제가 읽고 데이터 직군 취준생에게 권하는 책이라, 책이 강조하는 신뢰 점검 세 가지(A/A 테스트, 결과 엿보기, 샘플 비율 불일치)를 공개 온라인몰 데이터로 직접 돌려 봤습니다.
이 책은 어떤 책인가요
원서는 『Trustworthy Online Controlled Experiments: A Practical Guide to A/B Testing』입니다. 첫 저자 론 코하비는 마이크로소프트의 기술 펠로우로 일하던 시기에 이 책을 썼고, 그전에는 아마존에서 데이터 마이닝과 개인화를 맡았습니다(예스24 저자 소개 기준). 출판사 소개에 따르면 구글, 링크드인, 마이크로소프트에서 실행한 실험의 노하우를 담았고, 기획자, PO, 데이터 과학자를 독자로 잡습니다.
| 구분 | 종이책 | 전자책 |
|---|---|---|
| 제목 | A/B 테스트: 신뢰할 수 있는 온라인 종합 대조 실험 | 같음 |
| 지은이 / 옮긴이 | 론 코하비, 다이앤 탕, 야 쉬 / 이기홍, 김기영 | 같음 |
| 출판사 | 에이콘출판 (에이콘 검색마케팅 웹 분석 시리즈) | 에이콘출판 |
| 출간 | 2022-06-30, 378쪽 | 2023-04-24, PDF |
| 정가 | 30,000원 | 24,000원 |
| ISBN | 9791161755700 | 9791161757544 |
| 판매 상태 | 예스24·교보·알라딘 판매 중 | 예스24·교보·알라딘 판매 중 |
2026년 11월 22일에 서점 페이지에서 확인한 정보입니다. 알라딘에서는 종이책 부제가 “신뢰도 높은 온라인 통제 실험”으로 등록되어 있어서, 검색이 안 되면 부제를 빼고 찾으면 됩니다.
시리즈 1편인 『고객 리텐션의 전략』 서평이 “어떤 고객이 떠나는지”를 측정하는 책이었다면, 이 책은 “바꾼 것이 정말 효과가 있었는지”를 측정하는 책입니다. 리텐션 분석에서 찾은 위험 고객에게 쿠폰을 보낼 때, 그 쿠폰이 효과가 있었는지 확인하는 단계가 이 책의 영역입니다.
5부 23장 중 앞의 1부만은 누구나 읽게 썼습니다
목차는 5부 23장입니다. 출판사 소개에 따르면 1부는 배경과 상관없이 누구나 읽도록 설계했습니다.
이번 글의 실험은 대부분 5부에서 가져왔습니다. 19장이 “A/A 테스트”, 21장이 “샘플 비율 불일치 및 기타 신뢰 관련 가드레일 지표”, 18장이 “분산 추정 및 민감도 개선: 함정 및 해결책”입니다. 3장 제목에 나오는 트위먼의 법칙은 “흥미롭거나 남달라 보이는 숫자는 대개 틀렸다”는 경험칙입니다.
따라 한 데이터: 영국 온라인몰 고객 4,342명
1편과 같은 UCI Online Retail II를 썼습니다. 중복 행, 고객 ID가 없는 행, 취소 송장, 수량·가격이 0 이하인 행을 뺀 뒤, 2010년까지 한 번이라도 주문한 고객 4,342명을 실험 대상으로 정했습니다. 실험 기간은 2011년 3월 1일부터 28일까지 4주이고, 지표는 두 가지입니다.
- 구매 전환율: 4주 안에 한 번이라도 주문한 고객 비율. 15.5%입니다.
- 1인당 매출: 4주 동안 쓴 금액을 고객 수로 나눈 값. 안 산 고객은 0원으로 넣었고 평균 £97.34입니다.
진짜 실험이 아니므로 두 그룹 사이에 어떤 차이도 없습니다. 검정 결과가 “유의미”로 나오면 모두 오탐(거짓 양성)입니다.
실험 1: A/A 테스트로 “아무 차이 없음”의 크기를 먼저 봅니다
A/A 테스트는 두 그룹에 똑같은 화면을 보여 주는 실험입니다. 저는 고객을 무작위로 반씩 나누는 일을 2,000번 반복하고, 매번 전환율은 카이제곱 검정, 1인당 매출은 Welch t-검정으로 비교했습니다.
| 지표 | p<0.05가 나온 비율 | 기대값 |
|---|---|---|
| 구매 전환율 | 5.0% | 5% |
| 1인당 매출 | 5.2% | 5% |
| 1인당 매출(상위 1% 값에서 자름) | 4.95% | 5% |
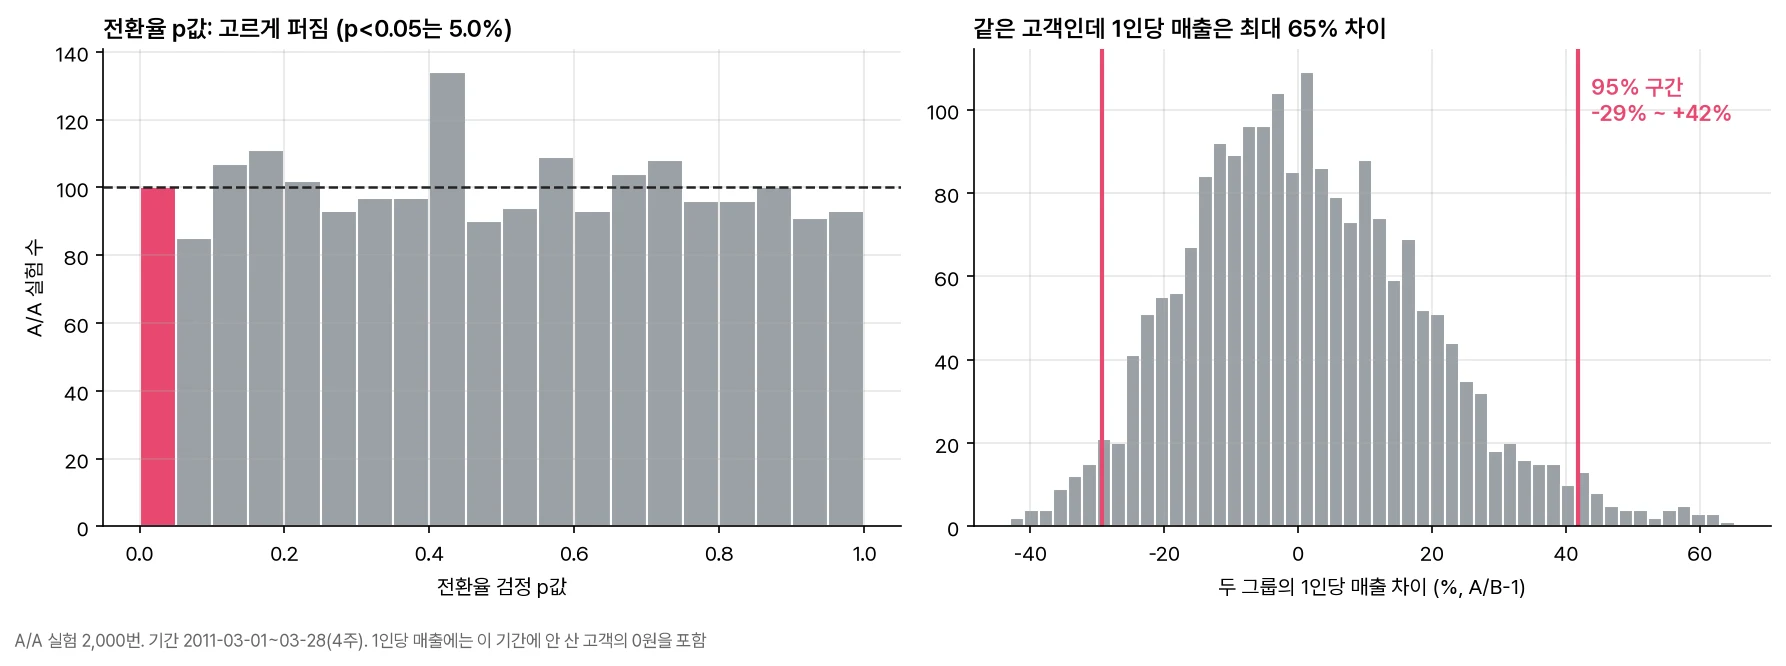
오탐 비율이 5% 근처이고 p값이 0~1에 고르게 퍼졌으니 검정 자체는 정상입니다. 19장 제목이 A/A 테스트인 이유가 여기 있습니다. 실험 시스템이나 검정 코드가 틀렸으면 이 분포부터 기울어집니다.
눈여겨볼 숫자는 오른쪽 그래프입니다. 같은 고객을 나눴을 뿐인데 두 그룹의 1인당 매출 차이는 95% 구간이 -29%에서 +42%였고, 가장 크게 벌어진 분할은 65% 차이였습니다. 이 4주 동안 상위 1% 고객 43명이 전체 매출의 40.5%를 냈고, 한 고객이 £16,727을 썼습니다. 큰손 몇 명이 어느 그룹에 들어가느냐에 따라 평균이 크게 흔들립니다.
이 흔들림이 크면 작은 효과는 우연에 묻힙니다. 그룹당 2,171명, 유의수준 5%, 검정력 80%로 계산하면 결과는 이렇습니다.
| 지표 | 잡아낼 수 있는 최소 상대 효과 |
|---|---|
| 1인당 매출 | 48.8% |
| 1인당 매출(상위 1%인 £1,333에서 자름) | 25.7% |
| 구매 전환율 | 19.8% |
이 규모의 쇼핑몰에서 4주짜리 실험으로 1인당 매출 10% 개선을 확인하겠다는 계획은 처음부터 불가능합니다. 극단값을 자르기만 해도 필요한 효과 크기가 절반 가까이 줄어드는데, 18장이 바로 분산을 줄여 민감도를 높이는 주제를 다룹니다.
실험 2: 결과를 매일 열어 보면 오탐이 5배로 늘어납니다
실무에서는 실험을 걸어 두고 대시보드를 매일 확인합니다. 그러다 p값이 0.05 아래로 내려간 날 “이겼다”며 실험을 멈추고 싶어집니다. 같은 A/A 실험 2,000번을 실제 날짜순으로 하루씩 누적해 매일 검정하고, 한 번이라도 p<0.05가 나오면 멈추는 규칙을 적용했습니다.
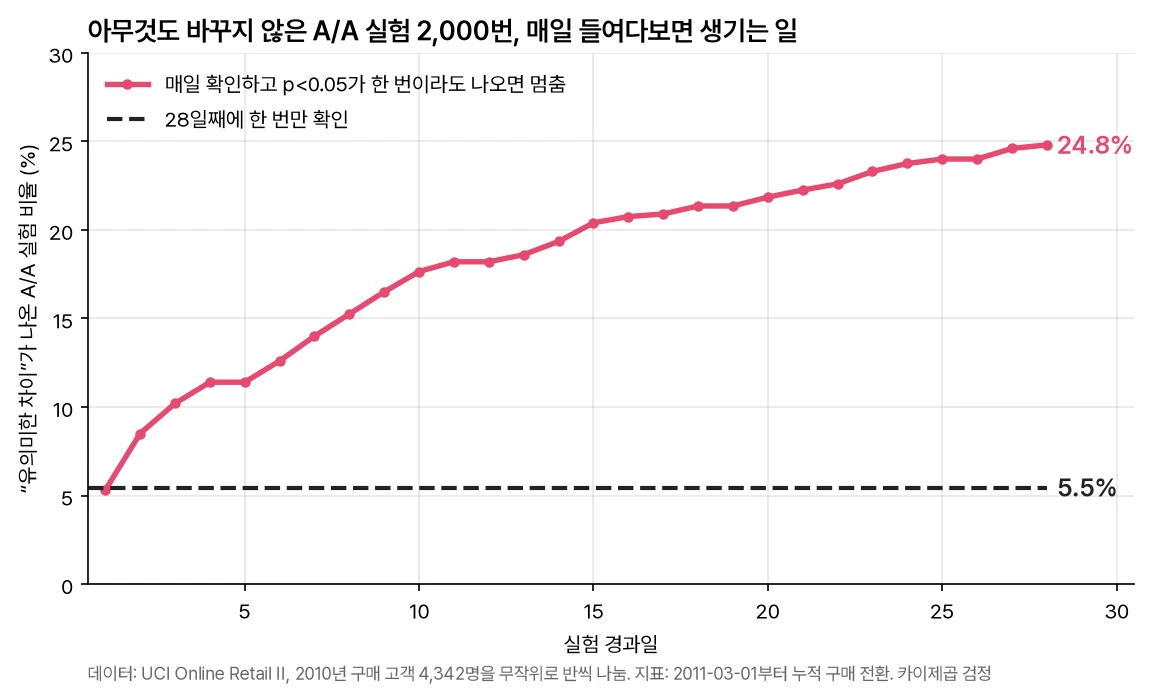
| 확인 방식 | “유의미한 차이”로 끝난 비율 |
|---|---|
| 28일째에 한 번만 확인 | 5.5% |
| 7일 동안 매일 확인 | 14.0% |
| 14일 동안 매일 확인 | 19.4% |
| 28일 동안 매일 확인 | 24.8% |
28일 내내 매일 확인하면 아무것도 바꾸지 않은 실험 4개 중 1개가 “성공”합니다. 매일의 p값은 그날 하루만 보면 맞는 계산입니다. 문제는 28번의 기회 중 한 번만 우연히 넘어도 멈추는 규칙에 있습니다. 실험 기간과 확인 시점은 실험을 시작하기 전에 정하고, 중간에 볼 일이 있다면 그만큼 기준을 엄격하게 잡아야 합니다.
실험 3: 기록이 한쪽에서만 빠지면 SRM 검사가 먼저 울립니다
샘플 비율 불일치(SRM, Sample Ratio Mismatch)는 50:50으로 나눈 실험에서 실제 인원이 50:50에서 벗어난 상태입니다. 21장이 이 문제를 신뢰 가드레일로 다룹니다. 비율이 어긋났다는 건 배정이나 기록 단계에 버그가 있다는 신호라서, 효과를 계산하기 전에 실험 자체를 의심해야 합니다.
일부러 버그를 만들어 봤습니다. 처치군에서만 구매하지 않은 고객의 기록이 일정 비율 빠지는 상황입니다. 새 화면에서 로그가 늦게 쌓여 바로 이탈한 고객이 누락되는 경우와 비슷합니다. 실제 효과는 0인데, 분모에서 안 산 사람이 빠지니 처치군 전환율이 올라갑니다. 누락 비율별로 무작위 분할 2,000번을 돌리고, SRM 검사는 카이제곱 적합도 검정 p<0.001을 경보 기준으로 잡았습니다.
| 처치군 미구매 기록 누락 | 처치군 인원 비율 | 가짜 전환율 개선(평균) | “처치군 승리” 판정 | SRM 경보 |
|---|---|---|---|---|
| 0% (정상) | 50.0% | +0.5% | 3.0% | 0.0% |
| 5% | 48.9% | +4.8% | 9.7% | 3.1% |
| 10% | 47.8% | +9.4% | 23.4% | 32.9% |
| 20% | 45.3% | +20.4% | 74.5% | 99.6% |
누락이 20%면 효과 없는 변경이 전환율 20% 개선으로 보이고, 실험 4개 중 3개가 “처치군 승리”로 끝납니다. 같은 상황에서 SRM 검사는 99.6% 경보를 울렸습니다. 처치군 인원이 45.3%로 줄어든 숫자 하나가 버그를 알려 준 셈입니다.
누락이 10%일 때는 SRM 경보가 32.9%에 그쳤습니다. 그룹당 2천 명 규모에서는 비율 차이가 작으면 우연과 구분이 잘 안 됩니다. SRM 검사를 통과했다고 버그가 없다는 뜻은 아니고, 걸리면 결과를 쓰지 말아야 한다는 뜻으로 읽어야 합니다.
읽고 따라 하기 전에 알아 둘 것
좋았던 점은 실험을 “돌리는 법”보다 “믿어도 되는지 확인하는 법”에 쪽수를 많이 쓴다는 점입니다. A/A 테스트, SRM, 분산 추정이 각각 한 장씩입니다. 이번 실험처럼 검정 코드는 정상이어도 엿보기 습관이나 기록 누락 하나로 결론이 뒤집히는데, 이런 함정을 장 제목 수준에서 짚어 줍니다. 1부를 누구나 읽게 쓴 점도 좋습니다. 같은 팀의 기획자나 PO와 함께 읽고 용어를 맞추기 좋습니다.
따라 할 때 막히는 지점은 다음과 같습니다.
- 5부는 통계 배경이 필요합니다. 17장 “온라인 종합 대조 실험에 사용되는 통계 이론”부터는 분산, 검정력 같은 개념을 알고 읽는 편이 수월합니다.
- 4부는 플랫폼을 만드는 사람의 이야기입니다. 클라이언트 측 실험, 계측, 랜덤화 단위 선택은 실험 플랫폼을 직접 만들거나 운영할 때 필요한 주제라, 분석만 하는 취준생이라면 처음 읽을 때 건너뛰어도 됩니다.
- 사례의 규모가 큽니다. 출판사 소개대로 사례가 구글, 링크드인, 마이크로소프트의 실험에서 왔습니다. 실험 1처럼 수천 명 규모에서는 잡아낼 수 있는 최소 효과가 훨씬 커지니, 내 데이터의 표본 크기로 다시 계산해 봐야 합니다.
취준생이라면 이 순서로 읽고 따라 해 보세요
1부(14장)를 먼저 읽고, 바로 19장 A/A 테스트와 21장 SRM으로 넘어가기를 권합니다. 두 장을 읽은 날 공개 데이터 하나로 A/A 테스트와 SRM 검사를 돌려 보면, 이 글의 실험 1·3과 같은 결과표가 손에 남습니다. 그다음 2부의 지표 장(67장)을 읽으면 “무엇을 지표로 삼을지”까지 설명하게 됩니다.
포트폴리오에 A/B 테스트 분석을 넣는다면 효과 크기와 p값 옆에 세 줄을 함께 적어 두세요. 실험 전에 정한 기간과 확인 시점, SRM 검사 결과, 그 표본으로 잡아낼 수 있는 최소 효과 크기입니다. 면접관이 “그 결과를 어떻게 믿었냐”고 물으면 이 세 줄이 답입니다.
이 글의 전체 재현 코드 (pandas, SciPy)
# 데이터: https://archive.ics.uci.edu/dataset/502/online+retail+ii 의 online_retail_II.xlsx
import pandas as pd, numpy as np
from scipy import stats

raw = pd.concat(pd.read_excel('online_retail_II.xlsx', sheet_name=None).values(), ignore_index=True)
df = raw.drop_duplicates()
df = df[df['Customer ID'].notna() & ~df['Invoice'].astype(str).str.startswith('C')]
df = df[(df.Quantity > 0) & (df.Price > 0)].assign(amount=lambda d: d.Quantity * d.Price)
c = 'Customer ID'

# 실험 대상: 2010년까지 한 번이라도 산 고객. 실험 기간: 2011-03-01 ~ 03-28 (4주)
pop = np.sort(df.loc[df.InvoiceDate < '2011-01-01', c].unique())
w = df[(df.InvoiceDate >= '2011-03-01') & (df.InvoiceDate < '2011-03-29') & df[c].isin(pop)]
rev = w.groupby(c).amount.sum().reindex(pop, fill_value=0.0)   # 안 산 고객은 0원
conv = (rev > 0).astype(int)
cap = rev.clip(upper=rev.quantile(0.99))                         # 상위 1% 값으로 자르기
print('고객', len(pop), '전환율', round(conv.mean(), 4), '1인당 매출', round(rev.mean(), 2))
top = rev.sort_values(ascending=False)
print('상위 1% 매출 비중', round(top.head(int(len(rev) * 0.01)).sum() / rev.sum(), 3))

def chi2_p(x, a):
    t = np.array([[x[a].sum(), a.sum() - x[a].sum()], [x[~a].sum(), (~a).sum() - x[~a].sum()]])
    return stats.chi2_contingency(t, correction=False)[1]

# 실험 1: A/A 테스트 2,000번
rng = np.random.default_rng(42); R = 2000
rv, cv, kv = rev.values, conv.values, cap.values
p_rev, p_conv, p_cap, diffs = [], [], [], []
for _ in range(R):
    a = rng.random(len(pop)) < 0.5
    p_rev.append(stats.ttest_ind(rv[a], rv[~a], equal_var=False).pvalue)
    p_cap.append(stats.ttest_ind(kv[a], kv[~a], equal_var=False).pvalue)
    p_conv.append(chi2_p(cv, a))
    diffs.append(rv[a].mean() / rv[~a].mean() - 1)
print('A/A p<0.05 비율: 매출', np.mean(np.array(p_rev) < .05), '전환', np.mean(np.array(p_conv) < .05),
      '자른 매출', np.mean(np.array(p_cap) < .05))
print('A/A 매출 차이 95% 구간', np.percentile(diffs, [2.5, 97.5]).round(3), '최대', np.abs(diffs).max().round(3))
n = len(pop) / 2
mde = lambda x: 2.8 * np.sqrt(2 * x.var(ddof=1) / n) / x.mean()   # 유의수준 5%, 검정력 80%
print('최소 검출 효과(상대): 매출', mde(rev).round(3), '자른 매출', mde(cap).round(3), '전환', mde(conv.astype(float)).round(3))

# 실험 2: 같은 A/A를 매일 확인하기 (엿보기)
days = pd.date_range('2011-03-01', periods=28)
first = w.assign(d=w.InvoiceDate.dt.normalize()).groupby(c).d.min().reindex(pop)
dayidx = np.nan_to_num((first - days[0]).dt.days.values, nan=99)
cum = np.array([(dayidx <= k).astype(int) for k in range(28)])   # k일째까지 누적 전환
ever, final = 0, 0
for _ in range(R):
    a = rng.random(len(pop)) < 0.5
    ps = np.array([chi2_p(cum[k], a) if cum[k].sum() else 1.0 for k in range(28)])
    ever += (ps < .05).any(); final += ps[-1] < .05
print('매일 확인 후 한 번이라도 p<0.05', ever / R, '28일째만 확인', final / R)

# 실험 3: 처치군에서 미구매 고객 기록이 빠지는 버그와 SRM 검사
rng = np.random.default_rng(7)
for drop in [0.0, 0.05, 0.10, 0.20]:
    win = srm = 0; lifts = []; ratios = []
    for _ in range(R):
        a = rng.random(len(pop)) < 0.5
        keep = np.ones(len(pop), bool)
        idx = np.where(a & (cv == 0))[0]
        keep[rng.choice(idx, int(len(idx) * drop), replace=False)] = False
        A, B = a & keep, ~a & keep
        t = np.array([[cv[A].sum(), A.sum() - cv[A].sum()], [cv[B].sum(), B.sum() - cv[B].sum()]])
        win += stats.chi2_contingency(t, correction=False)[1] < 0.05 and cv[A].mean() > cv[B].mean()
        srm += stats.chisquare([A.sum(), B.sum()]).pvalue < 0.001
        lifts.append(cv[A].mean() / cv[B].mean() - 1); ratios.append(A.sum() / (A.sum() + B.sum()))
    print(f'누락 {drop:.0%}: 처치군 비율 {np.mean(ratios):.3f}, 가짜 개선 {np.mean(lifts):+.1%}, '
          f'"처치군 승리" {win / R:.1%}, SRM 경보 {srm / R:.1%}')