
교육 효과를 만족도 대신 향상도로 재는 5단계 — 사전·사후 퀴즈 설계와 결과 취합 스크립트
이 글과 연결된 글 보기
드래그로 이동 · 휠/두 손가락으로 확대 · 방향키로 글 선택 · 0으로 맞춤. 실선: 본문 링크, 점선: 시리즈·주제의 대표 연결.표시된 글 15편 목록
교육 효과는 같은 문항을 수업 전후에 풀게 해서 오른 점수(향상도) 로 보고합니다. 로그인도 서버도 없이, 수강생이 결과를 한 줄로 복사해 제출하면 담당자가 스크립트 하나로 취합합니다. 실제 강의에 붙여 쓰는 방식을 5단계로 정리했습니다.
교육이 끝나면 담당자에게서 오는 질문은 "만족도 어땠나요"가 아니라 "이걸 뭐라고 보고하죠"입니다. 다음 분기 예산을 다시 받으려면 근거가 필요한데, 만족도 점수는 그날의 경험을 잴 뿐 교육으로 무엇이 달라졌는지는 말해주지 않습니다. 그래서 모든 강의 끝에 사전·사후 평가를 붙이기로 했습니다.
이 글은 이런 분께 필요합니다
- 사내 AI 교육이 끝난 뒤 효과를 숫자로 보고해야 하는 HR·교육 담당자
- "교육 효과가 있었나요"에 만족도 말고 다른 답을 주고 싶은 강사
- 평가 도구를 붙이고 싶지만 로그인·계정 세팅으로 수업 시간을 쓰기 싫은 분
준비물은 이렇습니다.
- 수강생이 링크로 여는 평가 페이지. Google Forms 퀴즈 모드도 되고, 웹 교안에 직접 넣은 퀴즈 페이지도 됩니다.
- 결과를 붙여넣을 채널(메신저 채널, 공유 문서, 폼 중 하나)
- Step 5를 따라 하려면 Python 3. Mac은 터미널에서
python3 --version으로 확인합니다. 추가 패키지는 없습니다.
Step 1. 향상도용 핵심 10문항을 따로 정합니다
문항을 많이 넣으면 측정이 정밀해질 것 같지만, 6회차 과정용으로 문항을 크게 늘렸을 때 한 페이지에 수십 문항이 나열되자 수강생들이 스크롤하다 멈췄습니다. 측정 도구의 가장 큰 위험은 부정확이 아니라 미응답이었습니다.
그래서 둘로 나눕니다.
- 핵심 평가 10문항: 사전과 사후에 똑같이 풉니다. 향상도는 이 세트로만 계산합니다.
- 회차별 복습 세트: 해당 회차가 끝난 뒤 풉니다. 향상도에는 넣지 않습니다.
실제 강의에서 쓰는 설정 파일의 앞부분입니다. 강의마다 이 파일만 새로 씁니다.
window.QUIZ_META = {
  id: 'claudecode-common',   // 강의별 고유값 — 브라우저 저장 키가 겹치지 않게
  title: 'Claude Code 업무 활용 · AI 리터러시 평가',
  sets: [
    { key: 'core', label: '핵심 평가', type: 'assessment',
      desc: '사전·사후 비교용 필수 10문항. 향상도(Δ)는 이 세트로만 계산합니다.' },
    { key: 's1', label: '1회차 복습 · 셋업과 기본 조작', type: 'review' },
    // …회차별 복습 세트
  ],
};
id를 강의마다 다르게 두는 이유가 있습니다. 점수를 브라우저(localStorage)에 저장하기 때문에, 같은 브라우저로 두 교육을 연달아 들은 사람은 키가 겹치면 이전 강의 점수가 덮어써집니다.
Step 2. 사전 평가에서는 정답을 보여주지 않습니다
처음 만든 버전은 문제를 풀면 바로 정답과 해설을 보여줬습니다. 학습 도구로는 당연하지만, 사전 평가에서 정답을 보여주면 수강생은 그걸 기억한 채 수업을 듣고 사후 점수가 부풀려집니다. 재려던 향상도가 "정답을 얼마나 잘 외웠나"로 바뀝니다.
그래서 규칙을 이렇게 정했습니다.
| 단계 | 보여주는 것 |
|---|---|
| 사전 평가 | 점수만 |
| 사후 평가 | 점수, 정답, 해설, 사전 대비 오른 점수 |
| 복습 세트 | 제출 즉시 문항별 해설 |
Google Forms 퀴즈로 만든다면 사전용 폼과 사후용 폼을 따로 만들고, 사전용 폼의 설정 → 응답자 설정에서 틀린 문제와 정답을 보지 못하게 끕니다. 응답자가 볼 항목(틀린 문제, 정답, 점수)은 이 설정에서 고를 수 있습니다.
같은 이유로 4지선다의 정답 위치를 고르게 나눕니다. 정답이 2번에 몰려 있으면 사후에는 찍어도 맞습니다.
Step 3. 주관식 정답은 표기 변형을 넉넉히, 채점은 엄격하게 합니다
주관식은 정답 목록과 키워드로 채점합니다.
{
  set: 'core',
  type: 'short',
  q: '프로젝트의 규칙·맥락·입력 금지 기준을 적어두면 매번 반복 설명하지 않아도 되는 파일의 이름은? (파일명)',
  answers: ['CLAUDE.md', 'claude.md', 'claudemd', 'claude md'],
  explain: 'CLAUDE.md에 규칙을 적어두면 Claude Code가 매 대화에서 그 맥락을 자동으로 참고합니다.',
}
대소문자나 띄어쓰기 때문에 오답 처리되면 향상도가 잘못 기록되니, answers에 표기 변형을 넉넉히 넣습니다.
이 글을 정리하면서 채점 함수를 다시 테스트했다가 반대 방향의 함정을 찾았습니다. "입력이 정답에 포함되기만 해도 정답"으로 처리하는 느슨한 비교를 쓰면, c 한 글자도 claudemd 안에 들어 있으니 정답이 됩니다. 사전 평가에서 아무렇게나 쓴 답이 맞으면 향상도가 줄어 보입니다. 아래는 두 방식을 비교한 테스트 코드입니다.
function normalize(s) {
  return (s || '').toString().trim().toLowerCase().replace(/\s+/g, '').replace(/[.·・]/g, '');
}
// 느슨한 버전: 입력이 정답에 포함되기만 해도 정답
function gradeLoose(input, answers) {
  const v = normalize(input);
  if (!v) return false;
  return (answers || []).some((a) => { const n = normalize(a); return v === n || v.includes(n) || n.includes(v); });
}
// 엄격한 버전: 입력 안에 정답 표기가 통째로 들어 있어야 정답
function gradeStrict(input, answers) {
  const v = normalize(input);
  if (!v) return false;
  return (answers || []).some((a) => { const n = normalize(a); return v === n || v.includes(n); });
}
const answers = ['CLAUDE.md', 'claude.md', 'claudemd', 'claude md'];
for (const input of ['CLAUDE.md', 'Claude MD', '정답은 claude.md 입니다', 'claude', 'c', 'README.md']) {
  console.log(JSON.stringify(input).padEnd(24), 'loose:', String(gradeLoose(input, answers)).padEnd(5), 'strict:', gradeStrict(input, answers));
}
node grade_test.js로 실행한 결과입니다.
"CLAUDE.md"              loose: true  strict: true
"Claude MD"              loose: true  strict: true
"정답은 claude.md 입니다"      loose: true  strict: true
"claude"                 loose: true  strict: false
"c"                      loose: true  strict: false
"README.md"              loose: false strict: false
엄격한 버전은 표기 변형과 문장 속 정답은 그대로 맞히고, claude나 c 같은 일부 입력만 오답으로 바꿉니다. 주관식 채점은 엄격한 버전을 씁니다. Google Forms로 받았다면 응답 → 질문 화면에서 단답형 응답을 한 번 훑고, 표기 차이로 틀린 답만 정답으로 표시로 바꿉니다.
Step 4. 결과는 "한 줄 복사"로 받습니다
서버 없이 점수를 모으려면 수강생이 결과를 보내줘야 합니다. 평가 페이지에 결과 한 줄 복사 버튼을 두고, 사후 평가를 마친 수강생이 그 줄을 정해진 채널에 붙여넣게 합니다. 실제 강의에서 쓰는 형식은 이렇습니다.
[AI리터러시평가] 김하늘 / 사전 4/10 / 사후 8/10 / 향상 +4점 / 복습 3/6세트 / 2026-10-07
원시적으로 보여도 현장에서 가장 잘 굴러간 방식입니다. 수강생은 "버튼 누르고 붙여넣기" 두 동작이면 끝나고, 수강생 응답이 외부 서버로 가지 않으니 사내 검토 대상도 줄어듭니다.
하나 더 있습니다. 사전 평가는 수업 시간에 풀게 합니다. 사후 평가는 마지막 챕터에 링크가 있어서 대부분 풀지만, 사전 평가는 수업 전에 안내만 하면 많이 건너뜁니다. 지금은 1회차 시작 10분을 사전 평가 시간으로 아예 배정합니다.
Step 5. 붙여넣은 줄을 모아 향상도를 계산합니다
채널에 모인 메시지를 통째로 복사해 results.txt로 저장합니다. 인사말이 섞여 있어도 괜찮습니다. [AI리터러시평가]로 시작하는 줄만 읽습니다.
import re, sys, statistics as st

# 수강생이 붙여넣은 "결과 한 줄"을 모은 텍스트 파일을 읽습니다.
LINE = re.compile(r"\[AI리터러시평가\]\s*(?P<name>.+?)\s*/\s*사전\s*(?P<pre>\d+/\d+|-)\s*/\s*사후\s*(?P<post>\d+/\d+|-)")

def score(s):
    if s == "-":
        return None
    a, b = map(int, s.split("/"))
    return a / b * 100  # 100점 만점으로 환산

people = {}
for raw in open(sys.argv[1], encoding="utf-8"):
    m = LINE.search(raw)
    if m:  # 같은 사람이 두 번 붙여넣으면 마지막 줄을 씁니다
        people[m["name"]] = (score(m["pre"]), score(m["post"]))

pairs = [(a, b) for a, b in people.values() if a is not None and b is not None]
no_pre = sum(1 for a, b in people.values() if a is None)
no_post = sum(1 for a, b in people.values() if b is None)
deltas = [b - a for a, b in pairs]

print(f"제출 {len(people)}명 · 사전·사후 모두 있음 {len(pairs)}명 (사전 없음 {no_pre}, 사후 없음 {no_post})")
if pairs:
    print(f"사전 평균 {st.mean(a for a, _ in pairs):.1f}점 → 사후 평균 {st.mean(b for _, b in pairs):.1f}점")
    print(f"향상도(Δ) 평균 {st.mean(deltas):+.1f}점 · 중앙값 {st.median(deltas):+.1f}점")
    up = sum(d > 0 for d in deltas); same = sum(d == 0 for d in deltas); down = sum(d < 0 for d in deltas)
    print(f"오른 사람 {up}명({up/len(pairs):.0%}) · 같음 {same}명 · 내린 사람 {down}명")
python3 aggregate.py results.txt
지어낸 결과 9줄(7명, 한 명은 두 번 붙여넣음, 한 명은 사전 미응시, 인사말 한 줄 포함)로 실행한 실제 출력입니다.
제출 7명 · 사전·사후 모두 있음 6명 (사전 없음 1, 사후 없음 0)
사전 평균 55.0점 → 사후 평균 73.3점
향상도(Δ) 평균 +18.3점 · 중앙값 +20.0점
오른 사람 4명(67%) · 같음 1명 · 내린 사람 1명
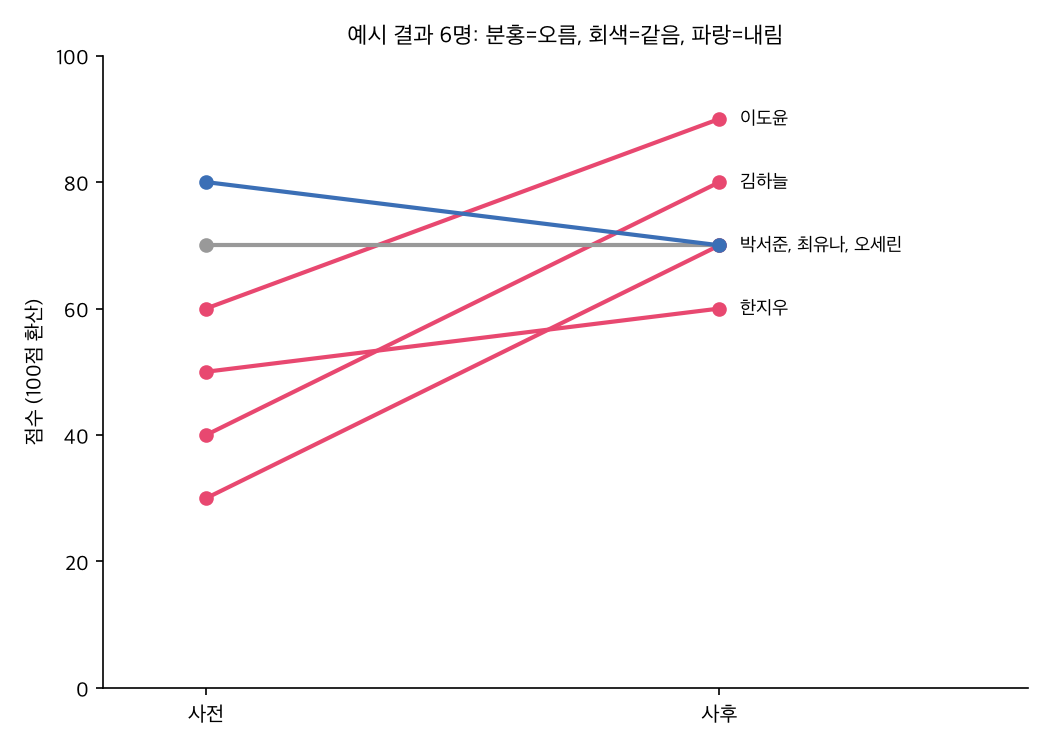
담당자에게는 개인 점수가 아니라 이 네 줄을 넘깁니다. 평균만 보내지 말고 사전·사후가 모두 있는 인원과 내린 사람 수를 같이 적습니다. 사전을 건너뛴 사람은 향상도 표본에서 빠지기 때문에, 몇 명 기준의 숫자인지가 없으면 숫자가 과장돼 보입니다.
오류가 나면 여기부터 확인하세요
| 증상 | 원인과 해결 |
|---|---|
제출 0명으로 나옴 | 붙여넣은 줄의 머리말이 [AI리터러시평가]와 다릅니다. 평가 페이지의 복사 형식과 스크립트의 LINE 정규식 머리말을 맞춥니다 |
| 한 사람이 두 번 집계됨 | 이름 표기가 다릅니다(예: "김하늘", "김하늘 대리"). 평가 시작 때 이름 입력 형식을 정해 줍니다 |
| 사전 점수가 사라졌다는 문의 | 브라우저 데이터를 지우거나 다른 기기·시크릿 창으로 사후를 풀면 사전 기록이 없습니다. 같은 기기·같은 브라우저로 풀도록 안내합니다 |
| 이전 강의 점수가 보임 | 설정 파일의 id가 이전 강의와 같습니다. 강의마다 고유값으로 바꿉니다 |
| 사후 점수가 사전보다 지나치게 높음 | 사전 평가에서 정답이 노출됐는지 확인합니다(Step 2) |
| 짧은 엉터리 답이 정답 처리됨 | 주관식 채점이 느슨한 비교입니다. Step 3의 엄격한 버전으로 바꿉니다 |
정리
- 만족도는 그날의 경험을, 향상도는 교육의 효과를 잽니다. 예산 근거로 쓸 수 있는 건 향상도입니다.
- 핵심 10문항만 사전·사후로 풀고, 사전에는 점수만 보여줍니다.
- 주관식은 표기 변형은 넉넉히 받되, 일부만 맞는 입력은 오답으로 채점합니다.
- 결과는 한 줄로 모아 스크립트로 계산하고, 몇 명 기준인지 함께 보고합니다.
한계도 같이 설명해야 합니다. 퀴즈를 잘 푸는 것과 업무에 실제로 쓰는 것은 다릅니다. 이 숫자는 "교육 내용이 전달됐는가"의 지표이지 "업무가 바뀌었는가"의 지표가 아닙니다. 담당자에게도 그렇게 전합니다.
평가 문항을 쓰다 보면 덤으로 커리큘럼 점검도 됩니다. 몇몇 회차는 복습 문항이 나오지 않았는데, 설명은 많고 확인할 수 있는 것이 없는 회차였습니다. 결국 그 회차의 구성을 바꿨습니다.