1년 생존율은 내리고 5년은 올랐다? 신생기업 생존율을 '같은 해 신생 집단'으로 다시 읽는 7단계
이 글과 연결된 글 보기
드래그로 이동 · 휠/두 손가락으로 확대 · 방향키로 글 선택 · 0으로 맞춤. 실선: 본문 링크, 점선: 시리즈·주제의 대표 연결.표시된 글 27편 목록
국가데이터처가 10월 22일 발표한 통계에서 신생기업의 1년 생존율은 63.9%로 전년보다 0.5%p 내렸고, 5년 생존율은 36.5%로 0.1%p 올랐습니다. 한쪽은 내리고 한쪽은 올랐으니 "새로 생긴 기업은 버티기 힘들어졌지만 오래 버틴 기업은 더 잘 살아남았다"처럼 읽고 싶어집니다. 하지만 1년 생존율은 2023년에 생긴 기업, 5년 생존율은 2019년에 생긴 기업의 비율입니다. 처음부터 같은 집단이 아닙니다. 이 글은 보도자료 표 하나를 CSV로 옮기고, 숫자마다 '언제 생긴 기업인지'를 붙여서 다시 읽는 과정을 7단계로 정리했습니다. 노트북과 데이터를 함께 공개합니다.
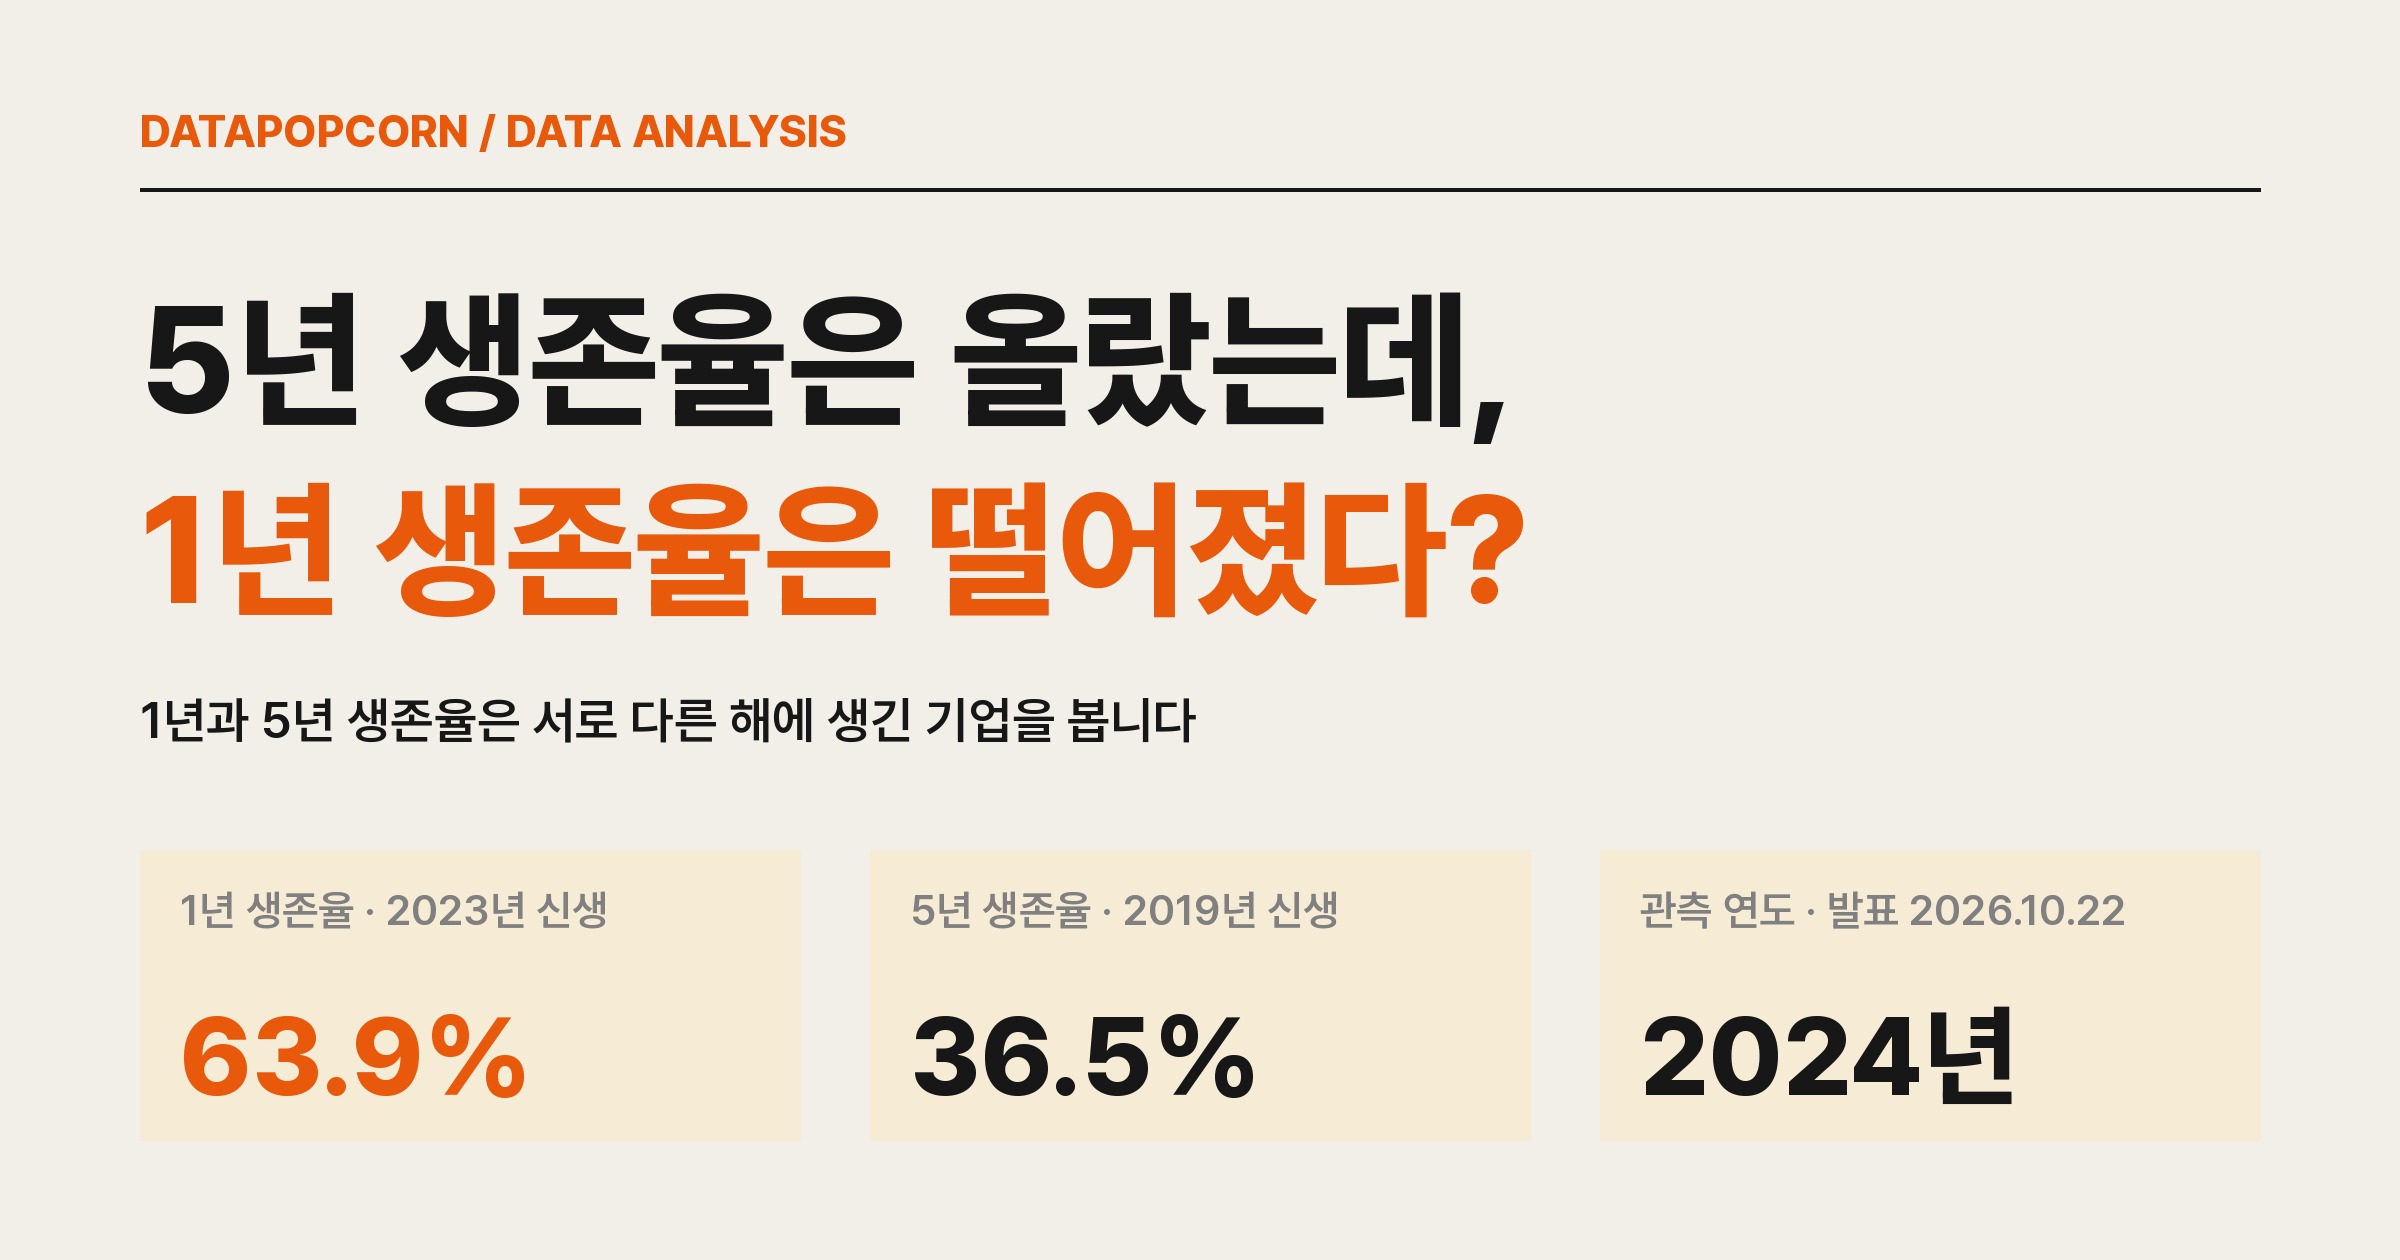
- 두 숫자는 다른 집단입니다. 2024년에 관측한 1년 생존율 63.9%는 2023년 신생기업, 5년 생존율 36.5%는 2019년 신생기업의 비율입니다. 전년 값과 비교하면 1년은 2022년 신생(64.4%)에서 2023년 신생(63.9%)으로, 5년은 2018년 신생(36.4%)에서 2019년 신생(36.5%)으로 비교 대상 자체가 바뀝니다.
- 한 해의 1~7년 생존율은 한 집단을 따라간 곡선이 아닙니다. 2024년 행의 63.9%, 53.5%, … 28.5%는 2023년부터 2017년까지 서로 다른 해에 생긴 7개 집단의 비율입니다.
- 같은 집단을 따라가려면 대각선으로 읽습니다. 2019년 신생기업은 2년 54.2%, 3년 46.9%, 4년 41.0%, 5년 36.5%였습니다(이번 발표본 표19 기준).
- 36.5 ÷ 63.9의 결과를 조건부 생존확률로 읽으면 틀립니다. 분자와 분모가 다른 해에 생긴 집단이라, '1년 버틴 기업이 5년까지 갈 확률'이 아닙니다.
- 부동산업을 빼도 방향은 같습니다. 1년은 0.3%p 하락, 5년은 0.7%p 상승입니다. 폭이 왜 다른지, 변화의 원인이 무엇인지는 이 표만으로 알 수 없습니다.
이 글은 이런 분께 필요합니다
생존율 기사는 매년 나오고, 숫자 두 개가 반대로 움직이면 해석이 붙기 쉽습니다. 이 글은 그 해석을 하기 전에 '이 숫자의 분모가 누구인가'를 확인하는 방법을 보여 드립니다.
- 창업·폐업 통계 기사를 읽고 보고서나 발표 자료에 인용해야 하는 분
- 코호트(같은 시기에 출발한 집단) 개념을 실제 공식 통계로 연습해 보고 싶은 데이터 분석 입문자
- 소상공인·스타트업 지원 업무에서 생존율 숫자를 자주 보는 분
코드를 직접 짤 필요는 없습니다. 아래 버튼으로 노트북을 열고 런타임 → 모두 실행을 누르면 표19를 CSV로 바꾸고, 이 글의 숫자와 차트 4개를 다시 만듭니다. API 키는 필요 없습니다.

원문은 국가데이터처 「2025년 기업생멸행정통계(잠정) 결과」 보도자료의 PDF입니다. 10월 22일 연합뉴스와 아주경제 등이 이 발표를 보도했습니다.
Step 1. 단어와 연도부터 정리합니다
먼저 이 통계에서 쓰는 말을 정확히 짚겠습니다. 기사에서는 '창업 기업'이라고 많이 쓰지만, 이 글에서 '창업'은 설명을 위한 말이고 통계의 공식 단위는 신생기업입니다.
- 신생기업: 그해 새로 경제활동을 시작해 매출액 또는 상용근로자가 생긴 영리기업입니다. 원문 용어 설명(PDF 81쪽)에 따르면 기존 기업이라도 대표자, 주소, 산업(중분류) 중 2개 이상이 동시에 바뀌면 신생기업으로 분류합니다. 그래서 '새로 사업자등록을 한 가게'와 정확히 같지는 않습니다.
- 생존: 신생 이후 관측 연도까지 소멸되지 않고 지속적으로 존속한 경우입니다(PDF 82쪽). 소멸은 매출액과 상용근로자가 없는 상태가 1년 이상인 경우로, 폐업 신고를 안 했어도 소멸로 봅니다. 생존이 '이익을 냈다'거나 '성공했다'는 뜻은 아닙니다.
- n년 생존율: 원문 정의는 이렇습니다.
n년 생존율 = (t-n년 신생기업 중 t년까지 생존 기업 수 / t-n년 신생기업 수) × 100
여기서 t가 관측 연도, t-n이 그 기업들이 생긴 신생 연도입니다. 이 글은 같은 해에 생긴 기업 묶음을 코호트라고 부릅니다. '2019년 신생 코호트'는 2019년에 신생기업으로 잡힌 기업 전체입니다.
63.9%는 비율입니다. "100곳 중 63.9곳이 살아남았다"는 말은 비율을 풀어 쓴 설명일 뿐, 누가 실제로 100곳을 센 것이 아닙니다. 이 표에는 기업 수가 없어서 이 글도 기업 수를 만들어 내지 않습니다.
다음은 연도입니다. 이번 발표에는 연도가 세 가지 나옵니다.
| 연도 | 무엇 | 예 |
|---|---|---|
| 2026년 | 발표 시점 | 2026년 10월 22일 보도 |
| 2025년 | 통계 제목의 기준 연도 | 「2025년 기업생멸행정통계」 |
| 2024년 | 생존율의 최신 관측 연도 | 2024년까지 살아남았는지 |
제목은 2025년인데 생존율은 왜 2024년까지일까요? 원문 일러두기(PDF 2쪽)에 이유가 있습니다. 어떤 기업이 소멸했는지는 다음 해 자료와 비교해야 확인할 수 있어서, 소멸률과 생존율은 2024년까지만 작성했다고 적혀 있습니다. 2024년 값은 2026년 9월까지 들어온 행정자료로 만든 잠정치(표에서 'p' 표시)라 확정 때 바뀔 수 있습니다.
Step 2. 표19를 긴 표(CSV)로 바꿉니다
생존율 표는 PDF 27쪽(인쇄 쪽 번호 21)의 표19 「연도별 신생기업 생존율」입니다. 가로는 생존 기간 1년~7년, 세로는 관측 연도 2021~2024년이고, 위 블록은 전체 산업, 아래 블록은 부동산업 제외입니다. 원문 PDF에서 표 영역의 텍스트를 줄 단위로 뽑으면 첫 데이터 줄은 이렇게 생겼습니다.
2021년 64.1 54.2 46.4 38.9 34.3 30.4 26.0
이 줄을 숫자 7개로 쪼개고, 각 칸에 신생 연도 = 관측 연도 - 생존 기간을 붙입니다. 노트북 Step 2의 실제 코드 일부입니다.
NUM7 = '((?:-?\\d+\\.\\d\\s+){6}-?\\d+\\.\\d)'
ROW_RE = re.compile(r'^(?:(부동산업\s*제외)\s+)?(\d{4})년(p?)\s+' + NUM7 + r'\s*$')

for h, v in enumerate(m.group(4).split(), 1):
    rates.append({'scope': scope, 'observation_year': year, 'horizon_years': h,
                  'birth_year': year - h, 'rate_pct': float(v), 'pdf_page': pdf_page})
결과는 2개 범위 × 관측 4개 연도 × 7개 기간 = 56행의 survival_rates.csv입니다. 열은 scope, observation_year, horizon_years, birth_year, rate_pct, pdf_page 여섯 개입니다. 표의 첫 블록에는 라벨이 없는데, 같은 보도자료 표20·표21의 '전 산 업' 행과 값이 같아서 전체로 표기했습니다.
옮긴 숫자가 맞는지는 표 스스로가 확인해 줍니다. 표19에는 '증감' 줄이 있습니다. 2024년 값에서 2023년 값을 뺀 결과가 증감 줄 14칸과 모두 같은지 assert로 확인했고, 같은 PDF의 표20(1년), 표21(5년), 8쪽 요약표와도 대조했습니다. 다른 PDF 텍스트 추출 도구 두 가지(pdftotext, pypdf)로 27쪽을 다시 읽어도 숫자는 같았습니다.
한 가지 함정이 있었습니다. 잠정 표시 'p'는 작은 위첨자라서, 추출 도구에 따라 2024년이 아니라 2023년 줄에 붙어 나오기도 했습니다. 그래서 잠정 연도는 'p'가 붙은 줄이 아니라 8쪽·28쪽 표 머리글의 '2024p'와 그림 제목 '2024년p'로 확인했고, CSV 대조에는 숫자만 썼습니다.
Step 3. 최신 1년·5년 생존율에 신생 연도를 붙입니다
이제 뉴스에 나온 두 숫자를 신생 연도와 함께 놓습니다. 노트북은 이렇게 출력합니다.
1년 생존율: 2023년 관측 64.4% (2022년 신생) -> 2024년 관측 63.9% (2023년 신생), 변화 -0.5%p
5년 생존율: 2023년 관측 36.4% (2018년 신생) -> 2024년 관측 36.5% (2019년 신생), 변화 +0.1%p
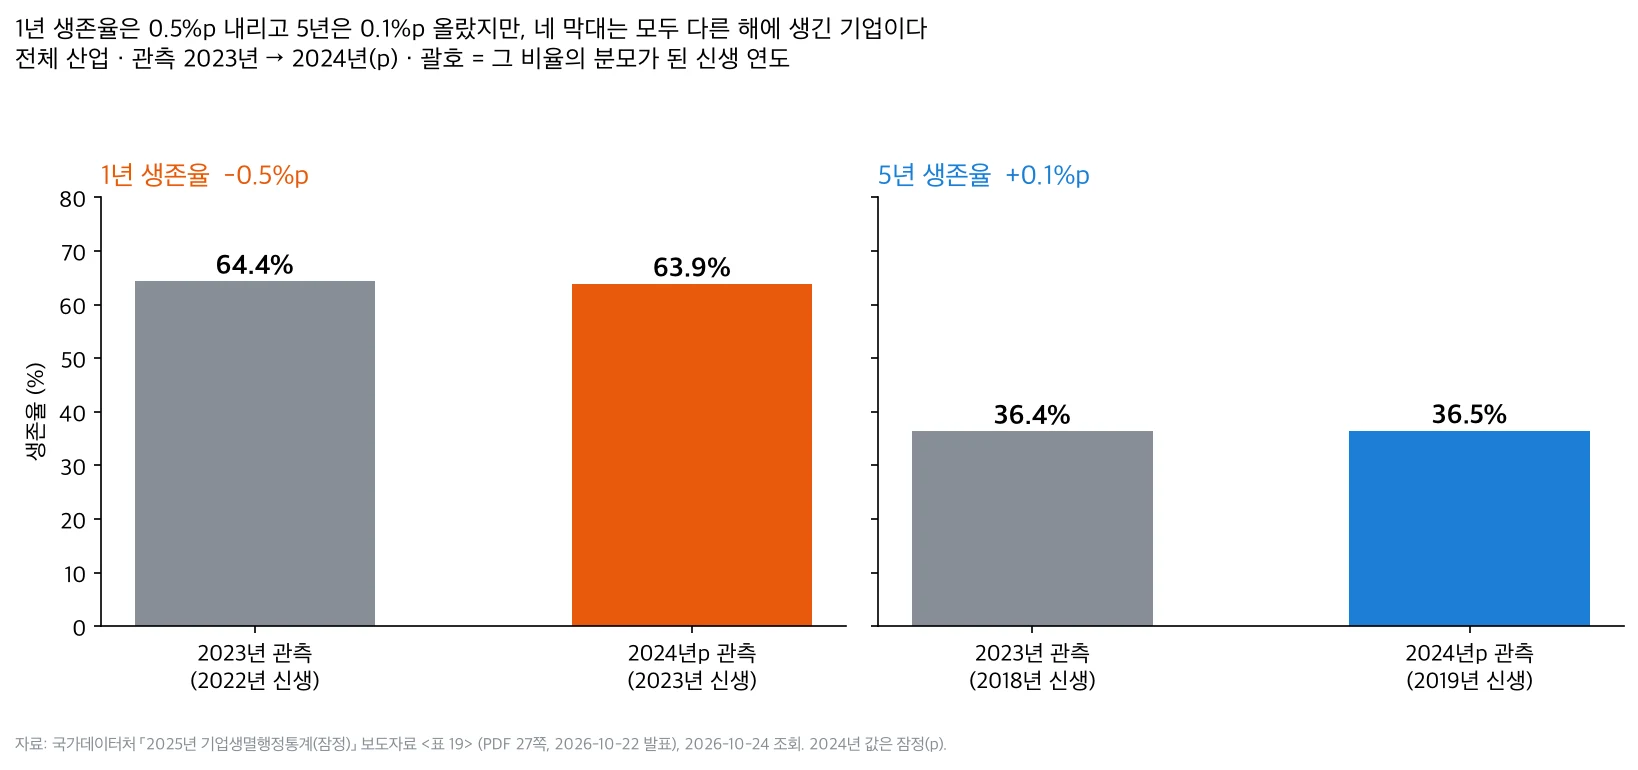
막대 네 개가 모두 다른 해에 생긴 기업입니다. 특히 "1년 생존율이 64.4%에서 63.9%로 내렸다"는 문장에서 비교 대상 자체가 2022년 신생기업에서 2023년 신생기업으로 바뀌었습니다. 같은 기업들이 작년보다 덜 살아남았다는 뜻이 아니라, 2024년에 1년 차를 맞은 새 집단이 2023년의 1년 차 집단보다 조금 낮았다는 뜻입니다.
5년 쪽의 +0.1%p도 같은 방식으로 읽습니다. 그리고 표가 소수 첫째 자리까지만 나오므로 0.1%p는 반올림 단위와 같은 크기입니다. "상승"이라는 단어보다 "거의 같은 수준"이 더 정확한 표현입니다.
Step 4. 한 해의 1~7년 생존율은 '한 집단의 곡선'이 아닙니다
표19의 2024년 행을 그대로 막대로 그리면 1년부터 7년까지 계단처럼 내려갑니다. 많은 사람이 이것을 "창업하면 시간이 갈수록 이렇게 줄어든다"는 한 집단의 생존 곡선으로 읽습니다.
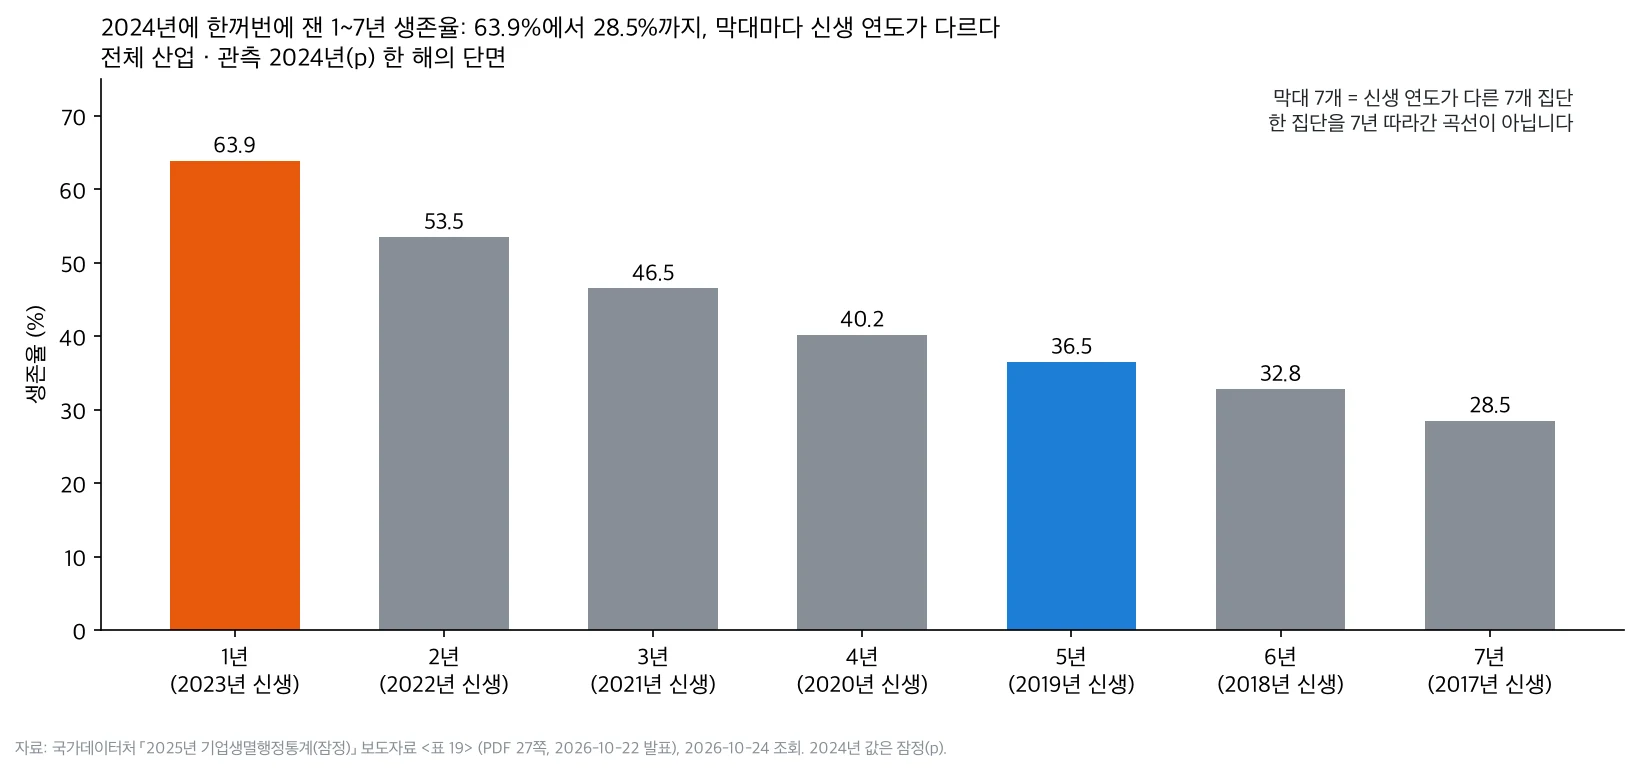
하지만 막대 밑의 신생 연도를 보면 7개가 모두 다른 집단입니다. 1년 막대는 2023년 신생, 7년 막대는 2017년 신생입니다. 이렇게 한 시점에 여러 집단을 동시에 잰 것을 단면이라고 합니다. 단면도 쓸모가 있습니다. "해당 관측연도에 생긴 지 n년 된 기업들이 어느 정도 남아 있나"를 한눈에 보여 줍니다. 다만 2017년 신생기업과 2023년 신생기업은 출발한 경기 환경도, 업종 구성도 다를 수 있으니 이 막대들을 한 집단의 시간 순서로 이어 읽으면 안 됩니다.
Step 5. 같은 2019년 신생기업만 대각선으로 따라갑니다
한 집단을 따라가려면 표를 대각선으로 읽어야 합니다. 관측 연도가 1년 늘면 생존 기간도 1년 늘어나는 칸을 고르면 신생 연도가 고정됩니다. 노트북 Step 5의 코드입니다.
def cohort_path(rates, birth_year=2019, scope='전체', horizons=(2, 3, 4, 5)):
    p = rates[(rates.scope == scope) & (rates.birth_year == birth_year) & rates.horizon_years.isin(horizons)]
    return p.sort_values('observation_year').reset_index(drop=True)
| 관측 연도 | 생존 기간 | 신생 연도 | 생존율 |
|---|---|---|---|
| 2021 | 2년 | 2019 | 54.2% |
| 2022 | 3년 | 2019 | 46.9% |
| 2023 | 4년 | 2019 | 41.0% |
| 2024(잠정) | 5년 | 2019 | 36.5% |
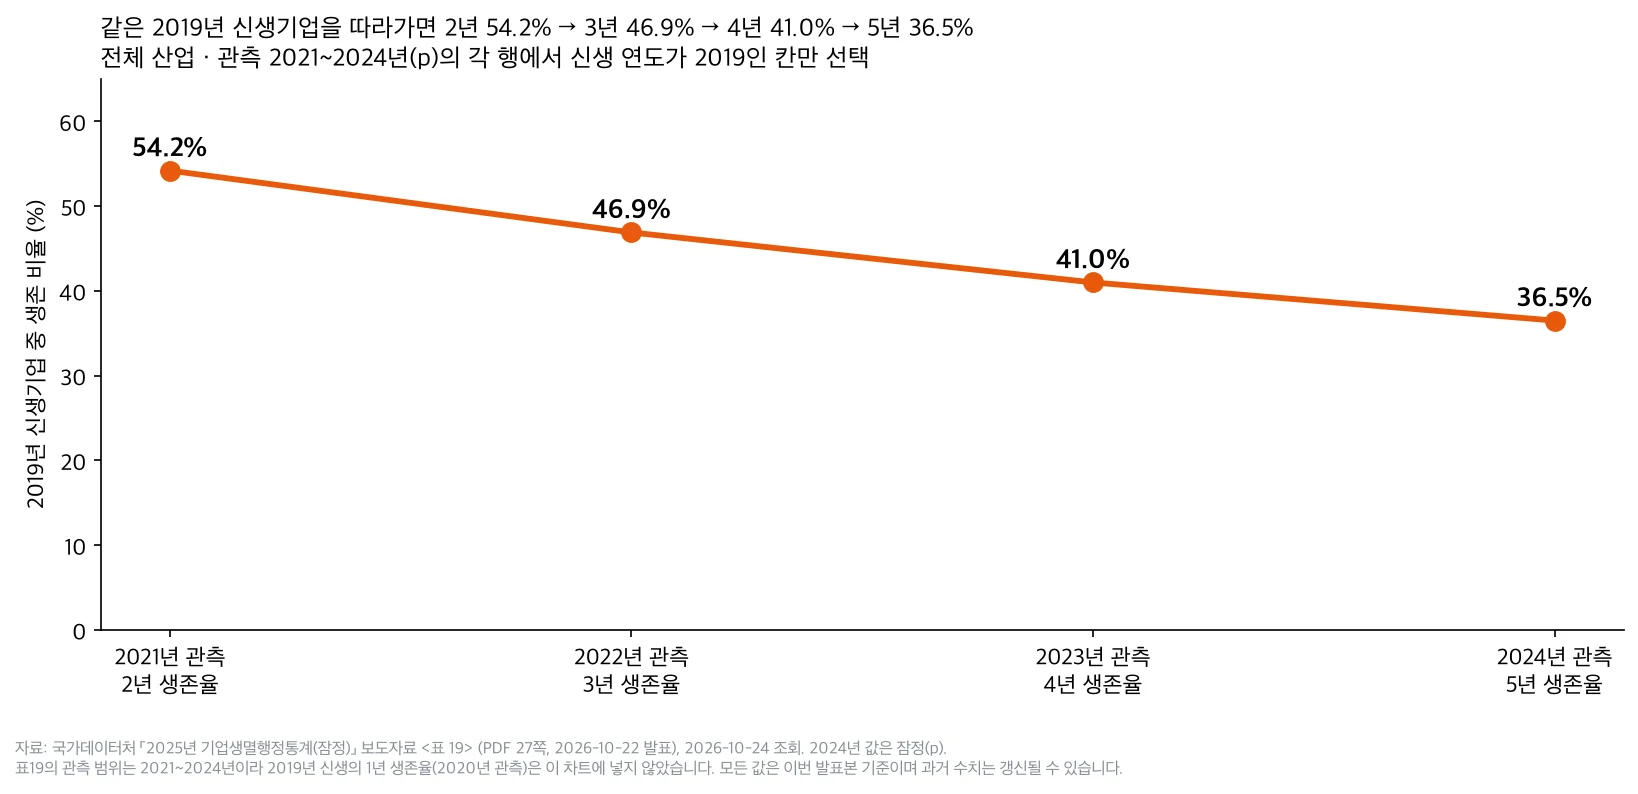
이 네 값은 모두 '2019년에 생긴 기업 전체'를 분모로 합니다. 그래서 이 선이야말로 한 집단이 시간에 따라 줄어드는 모양입니다. 표19의 관측 범위가 2021~2024년이라 2019년 신생의 1년 생존율(2020년 관측)은 이번 분석에 넣지 않았습니다. 네 값은 모두 이번 발표본 표19의 값입니다. 원문 유의사항(PDF 83쪽)대로 과거 수치는 산업분류 갱신 등으로 바뀔 수 있고, 2023년부터는 법인세 자료 구축 방법이 바뀌어 그전까지 일부 빠졌던 금융·보험업 기업이 추가됐습니다. 연도 간 비교는 이 점을 감안해야 합니다.
여기서 자주 나오는 계산 하나를 짚겠습니다. 2024년 행의 5년 값을 1년 값으로 나누면 이렇게 나옵니다.
잘못된 계산 예시: 36.5 / 63.9 = 57.1% <- 2019년 신생(분자)과 2023년 신생(분모)을 섞은 값, 조건부 생존확률 아님
이 57.1%를 "1년을 버틴 기업이 5년까지 살아남을 확률"(조건부 생존확률)이라고 부르면 틀립니다. 36.5%는 2019년 신생기업 기준이고 63.9%는 2023년 신생기업 기준이라, 두 비율의 분모가 다른 집단입니다. 조건부 생존을 보려면 같은 코호트의 1년 값과 5년 값이 필요합니다.
Step 6. 부동산업을 빼고 같은 비교를 다시 합니다
보도자료는 전체 산업과 함께 '부동산업 제외' 생존율도 따로 냅니다. 결론이 특정 업종을 넣고 빼는 데 따라 달라지는지 보는 것을 민감도 점검이라고 합니다.
전체: 1년 -0.5%p, 5년 +0.1%p
부동산업 제외: 1년 -0.3%p, 5년 +0.7%p
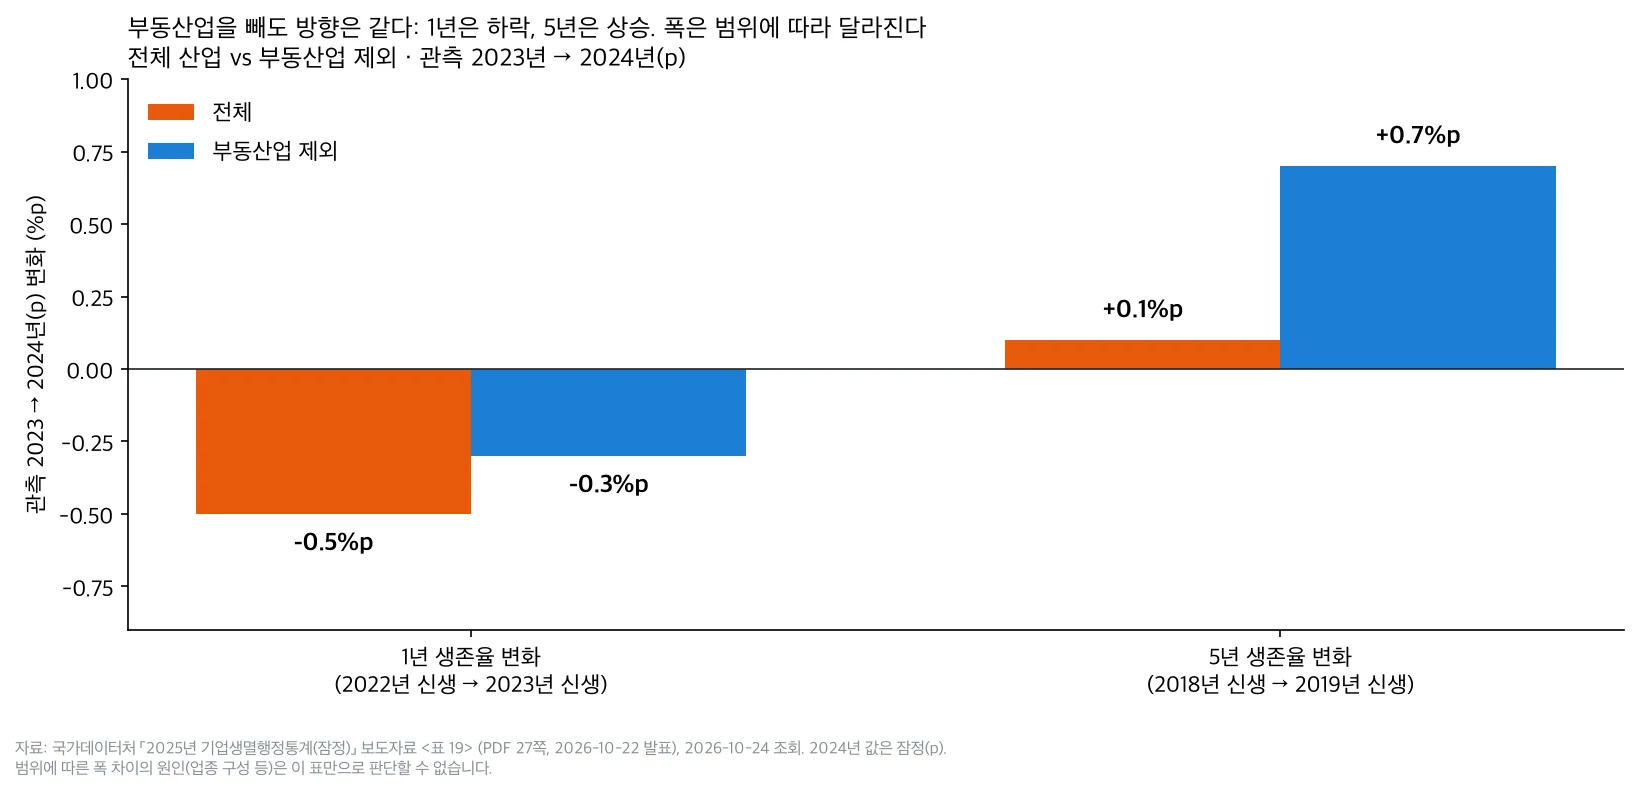
방향은 두 범위에서 같습니다. 1년은 내리고 5년은 플러스입니다. 전체의 +0.1%p는 거의 보합이고, 부동산업 제외는 +0.7%p입니다. 폭은 다릅니다. 특히 5년 생존율 변화는 전체에서 +0.1%p, 부동산업 제외에서 +0.7%p입니다. 이것을 "부동산업이 5년 생존율을 끌어내렸다"처럼 산업 구성의 효과로 단정하지는 않겠습니다. 이 표에는 업종별 기업 수가 없어서 구성 변화와 업종 안의 생존율 변화를 나눌 수 없습니다. 이 표로 말할 수 있는 것은 "범위를 바꿔도 방향은 유지되고 크기는 달라진다"까지입니다.
Step 7. 결론을 쓰기 전에 함정을 점검합니다
표 하나짜리 분석이라도 해석에서 걸리는 곳이 많습니다. 공통 함정 10개를 하나씩 확인했습니다.
| # | 함정 | 판정 | 확인 방법과 조치 |
|---|---|---|---|
| 1 | 기준 기간 | 걸림 | 비교는 관측 2023→2024 한 번뿐이고 표의 관측 범위도 2021~2024년. 1년치 변화를 '매년' 추세로 일반화하지 않음 |
| 2 | 절대 vs 변화율 | 걸림 | 변화는 %p. 표가 소수 첫째 자리 반올림이라 +0.1%p는 반올림 단위 크기 → '거의 같은 수준'으로 서술 |
| 3 | 표본 크기 | 확인함 | 표본조사가 아닌 행정자료 집계. 누락·분류·개정 오류는 별도로 주의하며, 표에 없는 기업 수를 만들지 않음 |
| 4 | 평균의 함정 | 걸림 | 전체 생존율은 업종을 합친 값 → 부동산업 제외 범위로 민감도 점검(Step 6) |
| 5 | 상관 ≠ 인과 | 걸림 | 개입도 대조군도 없음. 경기·금리·정책 등 원인을 이 표로 단정하지 않음 |
| 6 | 단위 정의 | 걸림 | 신생기업은 '창업'과 같지 않음. 대표자·주소·산업 중 2개 이상 동시 변경도 신생(PDF 81쪽) |
| 7 | 지표 대리 오류 | 걸림 | 생존 = 지속 존속(PDF 82쪽). 이익·성공·폐업 신고율이 아님 |
| 8 | 소스 편향·개정 | 걸림 | 2024년은 잠정. 과거 수치는 갱신될 수 있고 2023년부터 금융·보험업 자료 추가(PDF 83쪽) → 코호트 경로도 이번 발표본 기준으로 한정 |
| 9 | 데이터 범위 | 걸림 | 생존율은 2024 관측까지만 작성(PDF 2쪽). 표19 범위라 2019년 신생 경로는 2~5년만 |
| 10 | 구조(분모) 보정 | 걸림 | 같은 해의 1~7년 값은 신생 연도가 다른 집단 → 신생 연도 열 추가, 36.5 ÷ 63.9를 조건부확률로 해석하지 않음 |
검색량·SNS·지명 데이터를 다룰 때 쓰는 트렌드 전용 함정(동음이의어, 언급량, 저볼륨 노이즈, 상시 이벤트, 매체 편향, 팬데믹 기준연도)은 이번에는 해당이 없습니다. 검색지수나 매체 데이터가 아니라 공식 행정통계의 비율 하나를 다뤘고, 2020~2022년을 기준으로 증가율을 계산하지도 않았기 때문입니다. 다만 2019년 신생 코호트가 그 시기를 지나왔다는 점은 함정 1의 한계로 남겨 둡니다.
그래서, 1년은 내리고 5년은 오른 건 어떻게 읽어야 할까
- 두 숫자는 다른 해에 생긴 기업입니다. 1년 생존율 63.9%는 2023년 신생, 5년 생존율 36.5%는 2019년 신생 기업의 비율입니다. 두 지표가 반대로 움직인 것을 한 집단의 이야기로 묶을 수 없습니다.
- 전년 비교도 대상이 바뀐 비교입니다. 1년 생존율 64.4% → 63.9%는 2022년 신생 집단과 2023년 신생 집단을 비교한 값입니다.
- 한 집단을 보려면 대각선으로 읽습니다. 2019년 신생기업은 이번 발표본 기준으로 2년 54.2%에서 5년 36.5%가 됐습니다.
- 범위를 바꿔도 방향은 같습니다. 부동산업을 빼면 1년 -0.3%p, 5년 +0.7%p입니다.
이 표가 말하지 못하는 것도 분명히 적어 둡니다. 생존율이 왜 움직였는지(경기, 금리, 정책, 업종 구성)는 이 표로 알 수 없습니다. 2024년 값은 잠정이고, 과거 값도 다음 발표에서 갱신될 수 있습니다. 내년 발표에서 2020년 신생기업의 5년 생존율이 나오면, 같은 방법으로 신생 연도를 붙여 다시 비교해 볼 수 있습니다.
자주 막히는 곳
| 증상 | 원인 | 해결 |
|---|---|---|
| 2025년 통계인데 생존율이 2024년까지만 있음 | 소멸 여부는 다음 해 자료와 비교해야 확정됨(PDF 2쪽) | 발표 연도, 통계 제목 연도, 관측 연도를 따로 적기 |
| 잠정 'p'가 엉뚱한 연도 줄에 붙어 나옴 | 위첨자라 PDF 추출 도구마다 위치가 다름 | 숫자만 대조하고, 잠정 연도는 표 머리글·그림 제목으로 확인 |
| '부동산업제외'처럼 띄어쓰기가 사라짐 | 추출 도구 차이(pypdf) | 정규식에서 \s*로 띄어쓰기를 허용 |
| 1~7년 생존율을 곡선으로 그리고 싶어짐 | 한 행이 한 집단처럼 보임 | 신생 연도 열을 붙이고, 한 집단은 대각선(신생 연도 고정)으로 고르기 |
| 5년 값 ÷ 1년 값을 확률로 쓰고 싶어짐 | 같은 행이라 같은 분모처럼 보임 | 분자·분모의 신생 연도가 같은지 먼저 확인 |
| Colab 차트의 한글이 네모로 나옴 | 기본 폰트에 한글이 없음 | 노트북 첫 셀이 나눔고딕을 설치하고 폰트를 지정함 |
표 텍스트, CSV, 노트북, 재현 스크립트는 team-datapopcorn/datapopcorn-assets/business-survival-cohorts에 있습니다. 원문 PDF는 저장소에 다시 올리지 않고, 주소와 SHA-256 해시를 공개했습니다. 노트북 부록의 RUN_COLLECT = True로 바꾸면 원문 PDF를 직접 내려받아 해시를 확인하고 27쪽을 다시 읽어 같은 CSV가 나오는지 볼 수 있습니다.