뉴욕 택시 1월 데이터, 음수 요금이 6년 새 45배가 됐습니다: 『데이터 품질의 비밀』 따라 해 본 서평
이 글과 연결된 글 보기
드래그로 이동 · 휠/두 손가락으로 확대 · 방향키로 글 선택 · 0으로 맞춤. 실선: 본문 링크, 점선: 시리즈·주제의 대표 연결.표시된 글 23편 목록
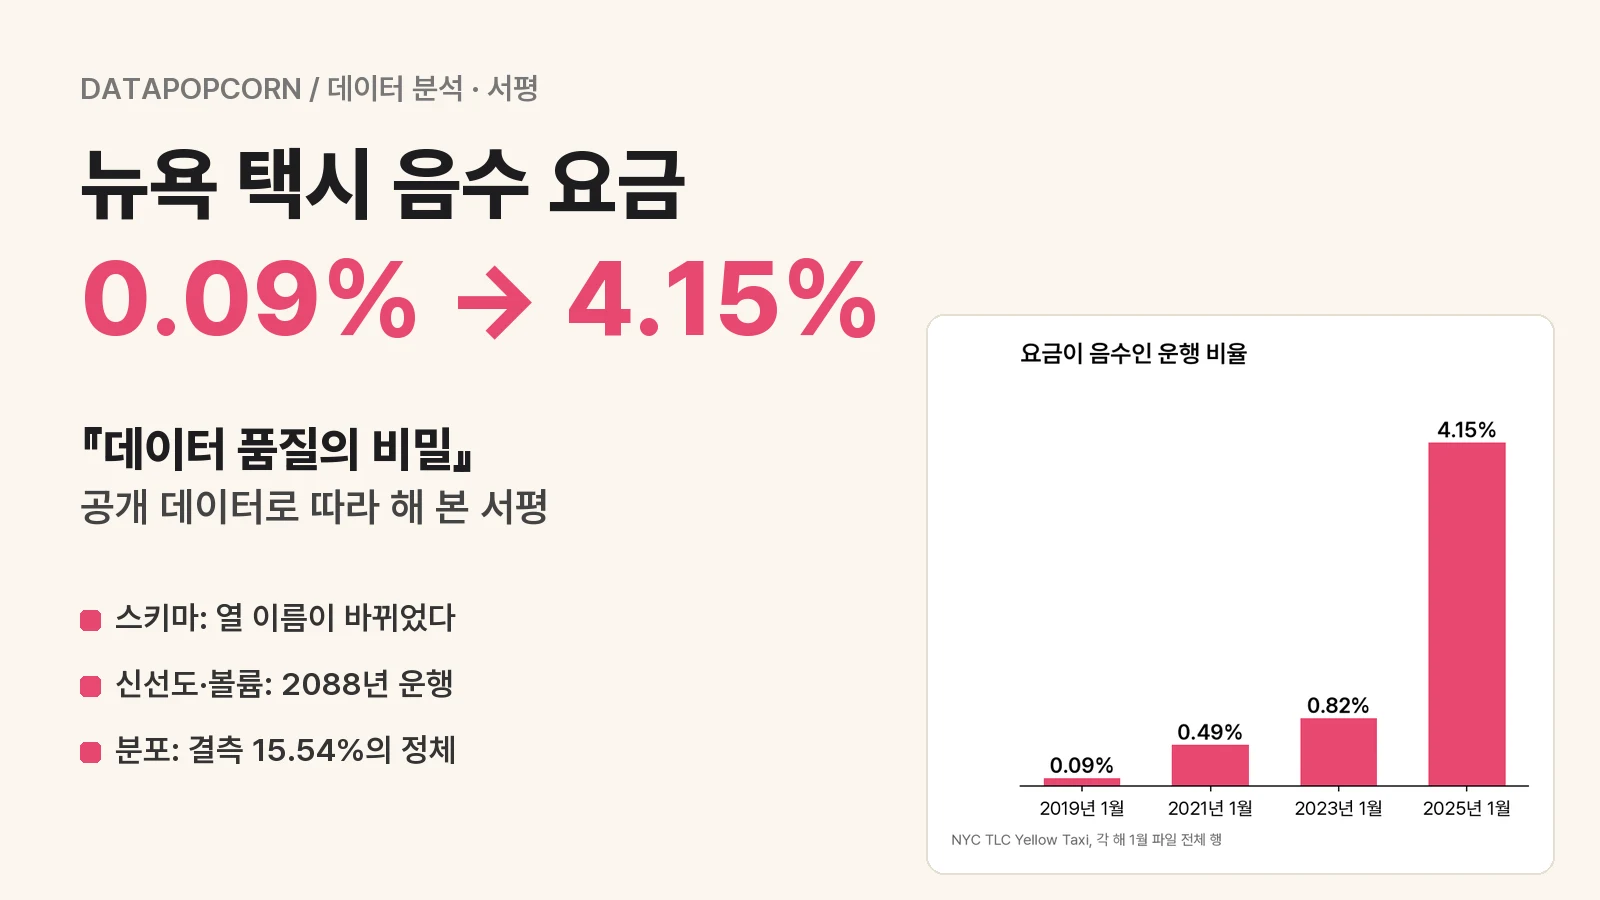
뉴욕 택시 공개 데이터의 2019·2021·2023·2025년 1월 파일을 나란히 놓고 보니, 요금이 음수인 운행 비율이 0.09%에서 4.15%로 약 45배가 됐습니다. 같은 출처, 같은 달인데도 공항 요금 열 이름은 airport_fee에서 Airport_fee로 바뀌어 그냥 합치면 2025년 공항 요금이 전부 비고, 2025년 승객 수 결측 15.54%는 결제 코드가 0인 운행과 한 행도 어긋나지 않고 겹쳤습니다. 『데이터 품질의 비밀』은 이런 문제를 신선도, 볼륨, 분포, 스키마, 계보 다섯 가지 기준으로 나눠 찾게 해 주는 책입니다. 제가 읽고 데이터 취준생에게 권하는 책이라 시리즈 네 번째로 골랐고, 이 글에서는 책의 구성과 직접 돌려 본 결과, 따라 할 때 막히는 지점을 정리합니다.
이 책은 어떤 책인가요
원서는 오라일리의 『Data Quality Fundamentals』이고, 바 모세스(Barr Moses), 라이어 개비쉬(Lior Gavish), 몰리 보르웨르크(Molly Vorwerck)가 함께 썼습니다. 한국어판은 커뮤니티 데이터야놀자가 옮겼습니다.
| 구분 | 내용 |
|---|---|
| 제목 | 데이터 품질의 비밀: 데이터 신뢰를 쌓는 데이터옵스의 핵심과 엔드 투 엔드 단계별 가이드 |
| 종이책 | 디코딩, 2023-04-10, 376쪽, 정가 28,000원, ISBN 9791198140814 |
| 전자책 | 한빛+ 표기 브랜드 한빛미디어, 2023-05-01, 22,400원, ISBN 9791198140807 |
| 지금 구하는 법 | 예스24 종이책 판매중(2026년 11월 22일 확인), 전자책은 한빛+와 예스24 |
종이책은 서점에서 출판사가 디코딩으로, 한빛+ 전자책 페이지에서는 브랜드가 한빛미디어로 나옵니다. 같은 책이니 어느 쪽으로 검색해도 됩니다. 한빛+ 소개 기준 레벨은 초중급입니다.
다섯 가지 기준이 책 전체를 꿰는 뼈대입니다
출판사 소개의 장별 설명을 따라가면 책은 “왜 지금 품질인가”에서 출발해 파이프라인 단계, 모니터링, 아키텍처, 사고 대응, 조직 문화 순서로 넓어집니다.
1장은 데이터 다운타임이라는 개념을 소개합니다. 서비스가 멈추는 시간을 재듯, 데이터가 틀렸거나 비었거나 늦은 시간을 재자는 생각입니다. 사이트 신뢰성 엔지니어링(SRE)의 데브옵스 원칙을 데이터 엔지니어링에 옮기면서 책이 시작합니다.
5장에서 데이터 품질을 최적화하는 기준으로 신선도, 볼륨, 분포, 스키마, 계보 다섯 가지를 정리합니다. 출판사 소개에는 분포가 “배포”로 적혀 있는데, 원문의 distribution, 즉 값이 퍼져 있는 모양을 뜻합니다. 4장은 거주 가능한 외계 행성에 관한 모의 천문 데이터로 이상 탐지 모니터를 만들고, 7장은 오픈 소스 도구로 필드 단위 계보를 만드는 과정과 폭스(Fox) 사례를 다룹니다. 10장은 신뢰할 수 없는 데이터가 비즈니스에 주는 재정적 영향을 계산하는 공식을 다룹니다.
따라 한 데이터: 뉴욕 택시 1월 파일 4개, 약 1,560만 건
책의 4장 예제는 모의 데이터라서, 저는 실제로 해마다 쌓이는 공개 데이터에 다섯 기준을 걸어 봤습니다. 뉴욕시 택시·리무진 위원회(TLC)가 매달 올리는 옐로 택시 운행 기록입니다. 2019·2021·2023·2025년 1월 parquet 파일 4개를 받아 모든 행을 읽었습니다.
| 파일 | 행 수 | 파일 크기 |
|---|---|---|
| 2019년 1월 | 7,696,617 | 약 110MB |
| 2021년 1월 | 1,369,769 | 약 22MB |
| 2023년 1월 | 3,066,766 | 약 48MB |
| 2025년 1월 | 3,475,226 | 약 59MB |
열의 뜻은 TLC의 옐로 택시 데이터 사전(2025년 3월 18일판)을 기준으로 삼았습니다. 같은 데이터의 2019년 1월 표본 1만 건에 Great Expectations 규칙 12개를 걸어 본 결과는 이전 글에 있습니다. 그 글이 파일 하나 안의 규칙 검사였다면, 이번에는 파일과 파일 사이의 변화를 봅니다.
실험 1: 스키마, 열 이름 대소문자 하나로 공항 요금이 통째로 빕니다
먼저 네 파일의 열 이름과 타입만 꺼내 비교했습니다. 데이터를 한 줄도 읽지 않고 메타데이터만 보는 점검이라 몇 초면 끝납니다.
import pyarrow.parquet as pq
schemas = {ym: {f.name: str(f.type) for f in pq.read_schema(f'yellow_tripdata_{ym}.parquet')}
           for ym in ['2019-01', '2021-01', '2023-01', '2025-01']}
18개 열은 네 해 모두 이름이 같았지만, 바뀐 곳이 다섯 군데 나왔습니다.
| 열 | 2019년 1월 | 2021·2023년 1월 | 2025년 1월 |
|---|---|---|---|
| 공항 요금 | airport_fee, 타입 null(값 전부 비어 있음) | airport_fee, double | Airport_fee, double |
cbd_congestion_fee | 없음 | 없음 | 새로 생김 |
passenger_count | double | double | int64 |
RatecodeID | double | double | int64 |
VendorID, PULocationID, DOLocationID | int64 | int64 | int32 |
가장 위험한 변화는 대소문자 한 글자입니다. 데이터 사전은 여전히 airport_fee(소문자)로 적는데, 2025년 1월 파일의 열 이름은 Airport_fee입니다. 2023년과 2025년 파일을 pd.concat으로 그냥 이어 붙이면 열이 둘로 갈라집니다.
| 원본 파일 | airport_fee 결측률 | Airport_fee 결측률 |
|---|---|---|
| 2023년 1월 | 2.3% | 100% |
| 2025년 1월 | 100% | 15.5% |
에러는 나지 않습니다. airport_fee로 공항 요금을 집계하면 2025년 1월 공항 요금 매출이 0으로 나오고, 그 숫자를 본 사람은 “공항 매출이 사라졌다”고 보고하게 됩니다. 승객 수 타입이 double에서 int64로 바뀐 부분도 결측을 NaN으로 처리하던 코드가 연도마다 다르게 동작하게 만듭니다. 책이 스키마를 별도 기준으로 두는 이유가 여기 있습니다.
실험 2: 신선도와 볼륨, “이상하다”와 “틀렸다”는 다릅니다
파일의 달 밖에 찍힌 승차 시각
1월 파일이면 승차 시각이 모두 1월이어야 합니다. 시각이 그 달 밖에 있는 행을 세었습니다.
| 파일 | 달 밖 승차 시각 | 가장 이른 시각 | 가장 늦은 시각 |
|---|---|---|---|
| 2019년 1월 | 537건 (0.007%) | 2001-02-02 14:55 | 2088-01-24 00:25 |
| 2021년 1월 | 24건 | 2008-12-31 23:05 | 2021-02-22 16:52 |
| 2023년 1월 | 48건 | 2008-12-31 23:01 | 2023-02-01 00:56 |
| 2025년 1월 | 22건 | 2024-12-31 20:47 | 2025-02-01 00:00 |
2019년 1월 파일에는 2001년 운행과 2088년 운행이 들어 있습니다. 2025년 파일은 12월 31일 밤과 2월 1일 자정 직후 22건이라, 자정을 넘긴 운행을 어느 달에 넣을지의 경계 문제로 보입니다. 비율은 작지만 “1월 일별 운행 수” 같은 집계를 날짜로 묶으면 2088년이라는 날이 생깁니다.
새 열이 언제부터 채워지는지도 신선도 점검에 들어갑니다. 2025년 1월 cbd_congestion_fee가 0보다 큰 운행은 1월 1~3일 0%, 4일 0.4%, 5일 64.7%였습니다. 데이터 사전이 적은 “2025년 1월 5일부터 부과”와 맞습니다. 2019년 1월의 congestion_surcharge가 1월 21일부터 채워진 사례는 이전 글에서 다뤘습니다. 새 열의 결측은 오류가 아니라 “아직 시작 전”일 수 있으니, 결측률을 날짜별로 나눠 봐야 합니다.
볼륨: 경보는 울렸는데 데이터는 맞습니다
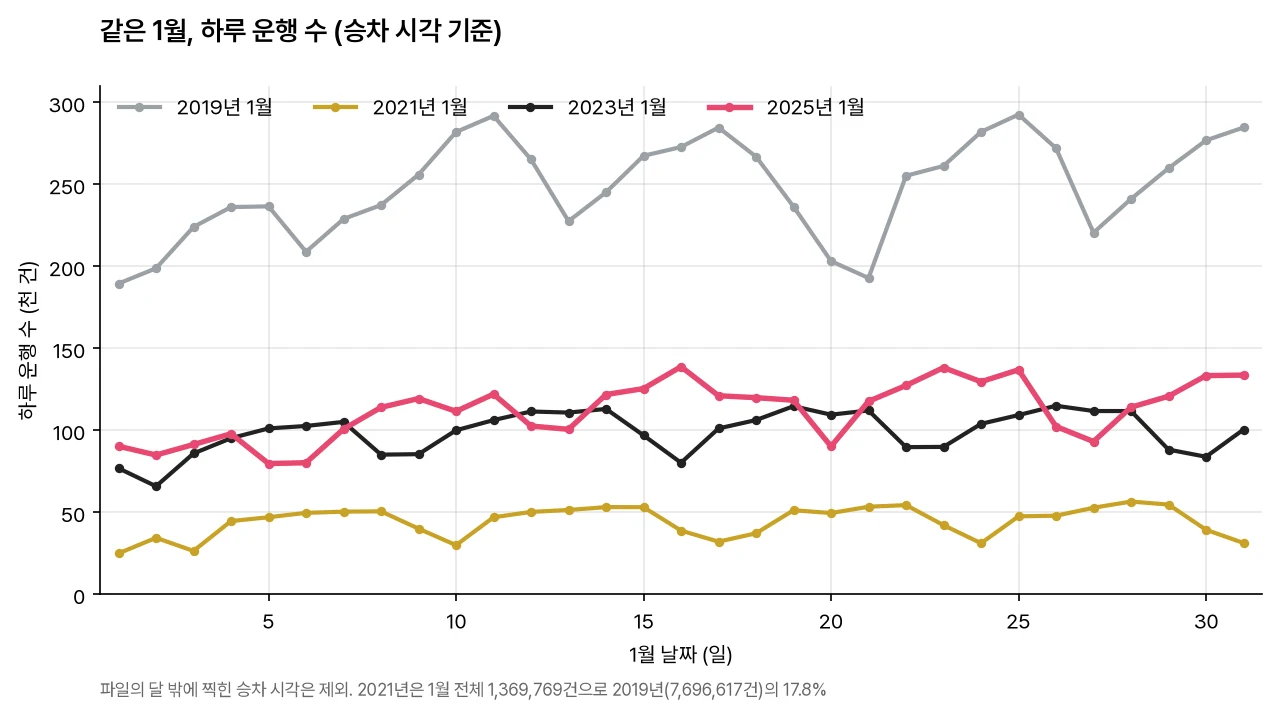
2021년 1월 전체 운행은 1,369,769건으로 2019년 1월(7,696,617건)의 17.8%입니다. 볼륨 모니터라면 “82% 급감”으로 경보를 울릴 숫자이지만, 파이프라인 고장이 아니라 실제로 택시 이용이 줄어든 결과로 보입니다.
달 안에서도 같은 일이 생깁니다. 하루 운행 수를 같은 달의 같은 요일 중앙값과 비교해 20% 넘게 벗어난 날을 찾는 간단한 모니터를 만들었습니다.
s = daily_counts   # 날짜별 운행 수 (index: 날짜)
weekday_median = s.groupby(s.index.day_of_week).transform('median')
flags = s[(s / weekday_median - 1).abs() > 0.2]
2025년 1월에 걸린 날은 1월 1일(-25.3%), 2일(-36.3%), 3일(-24.6%), 5일(-22.2%) 네 날, 2023년 1월은 1월 2일(-21.5%) 하루였습니다. 모두 새해 첫 주입니다. 볼륨 모니터는 무언가 달라졌다는 사실까지만 알려 주고, 그것이 오류인지 연휴인지는 달력과 사람이 판단합니다. 책이 6장에서 근본 원인 분석과 사고 커뮤니케이션을 따로 다루는 이유가 이 작은 실험에서도 드러납니다.
실험 3: 분포, 비율이 바뀌면 누가 바뀌었는지 쪼개 봅니다
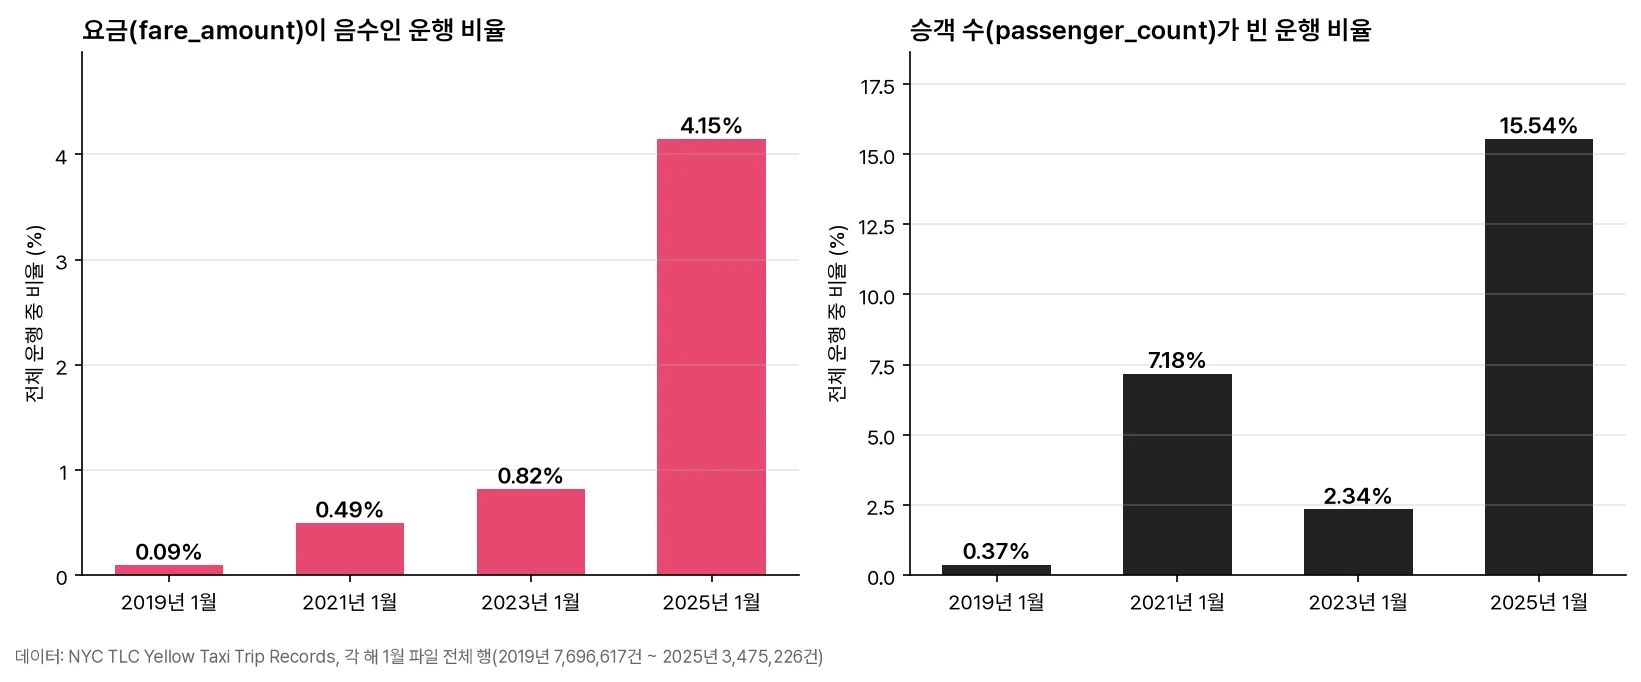
| 파일 | 음수 요금 건수 | 음수 요금 비율 | 그중 VendorID 2 비율 | 승객 수 결측 비율 |
|---|---|---|---|---|
| 2019년 1월 | 7,129 | 0.09% | 100% | 0.37% |
| 2021년 1월 | 6,769 | 0.49% | 99.96% | 7.18% |
| 2023년 1월 | 25,049 | 0.82% | 99.99% | 2.34% |
| 2025년 1월 | 144,118 | 4.15% | 100% | 15.54% |
음수 요금은 네 해 모두 거의 전부 VendorID 2에서 나왔습니다. 2025년판 데이터 사전에서 VendorID 2는 Curb Mobility입니다. 한 공급사의 기록 방식(환불이나 정정을 음수 행으로 남기는 등)일 가능성이 있지만, 데이터만으로는 이유를 확정할 수 없습니다. 분석가는 “음수 요금 4.15%, 전부 VendorID 2”까지 쪼갠 뒤 원천 담당자에게 물으면 됩니다.
승객 수 결측은 더 분명했습니다. 네 해 모두 passenger_count가 빈 행과 payment_type이 0인 행이 한 행도 어긋나지 않고 같았습니다. 현재 데이터 사전에서 0은 Flex Fare trip(정액 요금 운행)입니다. 결측 15.54%는 랜덤하게 빠진 값이 아니라 특정 운행 유형에서 통째로 기록되지 않는 값이고, 이 행을 지우면 Flex Fare 운행이 분석에서 사라집니다. 참고로 이전 글의 1만 건 표본에서는 결제 코드 0이 보이지 않았지만, 2019년 1월 전체 파일에는 28,672건이 있습니다.
한 파일만 봤다면 4.15%와 15.54%는 그냥 “이 데이터의 특성”으로 넘어갔을 숫자입니다. 이전 연도와 나란히 놓아야 분포가 움직였다는 사실이 보입니다.
계보는 이번 실험에서 다루지 못했습니다
다섯 기준 중 계보(lineage)는 데이터가 어느 원천에서 어떤 변환을 거쳐 왔는지를 추적하는 일입니다. 내려받은 완성 파일만으로는 TLC 내부의 변환 과정을 볼 수 없어서 이번에는 확인하지 못했습니다. 계보는 책의 7장처럼 자기 파이프라인을 직접 운영할 때 의미가 생깁니다.
읽고 따라 하기 전에 알아 둘 것
좋았던 점은 데이터 품질을 “깨끗한 데이터” 같은 막연한 말 대신 다섯 개의 점검 질문으로 바꿔 준다는 점입니다. 위 세 실험도 모두 “열이 그대로인가(스키마)”, “제때 제 범위에 들어왔나(신선도)”, “양이 평소와 같은가(볼륨)”, “값의 모양이 평소와 같은가(분포)”라는 질문 하나씩에서 출발했습니다. 질문이 정해지면 코드는 몇 줄이면 됩니다.
따라 할 때 막히는 지점은 다음과 같습니다.
- 데이터 엔지니어 관점의 책입니다. 출판사가 꼽은 대상 독자의 첫 줄이 데이터 엔지니어이고, 2·3장은 데이터 웨어하우스·레이크·카탈로그와 아파치 에어플로를 전제로 합니다. 파이프라인을 운영해 본 적이 없는 취준생에게는 생소한 도구 이름이 많습니다.
- 예제 데이터가 모의 데이터입니다. 4장의 모니터링 실습은 외계 행성 모의 데이터를 씁니다. 실제 공개 데이터로 한 번 더 해 봐야 감이 옵니다.
- 조직·문화 이야기가 뒤쪽 절반을 차지합니다. 6장부터 10장은 사고 대응, 계보, 민주화(RACI 매트릭스), 대담, 비용 계산입니다. 당장 분석 실력을 늘리고 싶은 독자에게는 덜 급한 내용입니다.
취준생이라면 이렇게 읽어 보세요
1장(데이터 다운타임)과 5장(다섯 가지 기준)을 먼저 읽고, 4장(모니터링과 이상 탐지)으로 넘어가는 순서를 권합니다. 2·3장의 도구 설명은 처음에는 훑기만 해도 됩니다.
읽은 뒤에는 포트폴리오에 쓰는 공개 데이터를 두 시점 이상 받아서 이 글의 표처럼 스키마, 달 밖 시각, 하루 건수, 주요 열의 결측·음수 비율을 나란히 비교해 보세요. 바뀐 점마다 오류인지, 현실 변화인지, 정의 변화인지를 한 줄씩 적어 두면 데이터를 믿고 쓴 근거가 됩니다. 시리즈 첫 편 『고객 리텐션의 전략』 서평에서 이탈률을 계산하기 전에 이탈 정의부터 확인한 순서와 같습니다.
이 글의 전체 재현 코드 (pandas, pyarrow)
# 데이터: https://www.nyc.gov/site/tlc/about/tlc-trip-record-data.page 의 Yellow Taxi 1월 파일 4개
# 내려받기 예: https://d37ci6vzurychx.cloudfront.net/trip-data/yellow_tripdata_2019-01.parquet
import pandas as pd, pyarrow.parquet as pq

MONTHS = ['2019-01', '2021-01', '2023-01', '2025-01']
path = lambda ym: f'yellow_tripdata_{ym}.parquet'

# 실험 1: 스키마 - 열 이름과 타입을 해마다 비교
schemas = {ym: {f.name: str(f.type) for f in pq.read_schema(path(ym))} for ym in MONTHS}
cols = sorted(set().union(*schemas.values()), key=str.lower)
print(pd.DataFrame({ym: {c: schemas[ym].get(c, '-') for c in cols} for ym in MONTHS}).to_string())

# 그냥 이어 붙이면 공항 요금 열이 둘로 갈라진다
both = pd.concat([pq.read_table(path(ym)).to_pandas().assign(src=ym)
                  for ym in ['2023-01', '2025-01']], ignore_index=True)
print(both.groupby('src')[['airport_fee', 'Airport_fee']].apply(lambda g: g.isna().mean()))

# 실험 2·3: 신선도, 볼륨, 분포
use = ['tpep_pickup_datetime', 'passenger_count', 'fare_amount', 'payment_type', 'VendorID']
rows, daily = [], {}
for ym in MONTHS:
    d = pq.read_table(path(ym), columns=use).to_pandas()
    start = pd.Timestamp(ym + '-01'); end = start + pd.DateOffset(months=1)
    t = d.tpep_pickup_datetime
    outside = (t < start) | (t >= end)                     # 파일의 달 밖에 찍힌 승차 시각
    s = t[~outside].dt.date.value_counts().sort_index()
    s.index = pd.to_datetime(s.index)
    daily[ym] = s
    neg = d.fare_amount < 0
    rows.append(dict(month=ym, rows=len(d), outside=int(outside.sum()),
                     t_min=t.min(), t_max=t.max(),
                     neg_fare=int(neg.sum()), neg_fare_pct=neg.mean() * 100,
                     neg_fare_vendor2_pct=(d.VendorID[neg] == 2).mean() * 100,
                     pc_null_pct=d.passenger_count.isna().mean() * 100,
                     pay0_rows=int((d.payment_type == 0).sum()),
                     pc_null_is_pay0=bool((d.passenger_count.isna() == (d.payment_type == 0)).all())))
print(pd.DataFrame(rows).T.to_string())

# 볼륨 모니터: 같은 달 같은 요일 중앙값에서 20% 넘게 벗어난 날
for ym in ['2023-01', '2025-01']:
    s = daily[ym]
    dev = s / s.groupby(s.index.day_of_week).transform('median') - 1
    print(ym, {d.strftime('%m-%d'): round(v * 100, 1) for d, v in dev[dev.abs() > 0.2].items()})

# 새 열이 언제부터 채워졌나: 2025년 1월 cbd_congestion_fee > 0 비율
d = pq.read_table(path('2025-01'), columns=['tpep_pickup_datetime', 'cbd_congestion_fee']).to_pandas()
print(d.groupby(d.tpep_pickup_datetime.dt.floor('D')).cbd_congestion_fee
       .agg(lambda x: round((x > 0).mean() * 100, 1)).loc['2025-01-01':'2025-01-07'])