11월 데이터 도구, 뭐가 바뀌었나요? DuckDB 2.0·Spark 4.3·UMAP 0.6 직접 돌려본 정리
이 글과 연결된 글 보기
드래그로 이동 · 휠/두 손가락으로 확대 · 방향키로 글 선택 · 0으로 맞춤. 실선: 본문 링크, 점선: 시리즈·주제의 대표 연결.표시된 글 35편 목록
10월 말부터 11월 사이 데이터 실무자가 쓰는 도구에 큰 업데이트가 몰렸습니다. DuckDB는 2.0으로 올라가며 JSON을 빠르게 다루는 VARIANT 타입, 트리거, 다른 프로세스가 붙는 서버 모드를 넣었고, Spark 4.3은 시점 기준 조인(ASOF JOIN)을 SQL로 쓰게 했고, UMAP 0.6은 같은 데이터에서 저희 맥 기준 77초 걸리던 작업을 47초로 줄였습니다. 반대로 Airbyte Cloud는 11월 17일 보안 사고로 서비스를 내렸다가 복구 중입니다. 아래는 이 소식들을 직접 설치해 돌려 보고, 업그레이드 전에 걸리는 지점까지 정리한 결과입니다.
이 글은 이런 분께 필요합니다
- DuckDB·Spark를 업무에 쓰는데, 이번 메이저 업데이트에서 무엇을 확인하고 올려야 할지 정리가 필요한 분
- 소식은 여러 곳에서 봤지만 실제로 돌아가는 예제가 필요한 분
- Airbyte Cloud로 데이터를 옮기고 있어서 이번 사고의 영향 범위가 궁금한 분
준비물은 Python 3.11 이상입니다. Spark 예제를 돌리려면 Java 17 또는 21이 더 필요합니다. 아래 코드는 2026년 11월 21일 Apple Silicon 맥, Python 3.13에서 실행한 그대로입니다.
한눈에 보기
| 도구 | 나온 날 | 이번에 바뀐 점 | 먼저 챙길 사람 |
|---|---|---|---|
| DuckDB 2.0 | 10월 21일 | VARIANT 타입 정식화, 트리거, 서버 모드(Quack), 새 SQL 파서, 비동기 I/O | 로컬·노트북 분석, 경량 파이프라인 |
| Spark 4.3 | 10월 30일 | SQL ASOF JOIN, JSON_TABLE, SCD Type 2 Auto CDC, 실시간 모드 상태 처리 | 데이터 엔지니어, Databricks 사용자 |
| UMAP 0.6 | 11월 10일 | 새 초기화·최적화기, 이웃 탐색 속도 개선 | 임베딩 시각화, 군집 분석 |
| Airbyte Cloud 사고 | 11월 17일부터 | 보안 사고로 클라우드 중단 후 단계적 복구 중 | Airbyte Cloud 사용 팀 |
같은 기간 레딧 데이터 커뮤니티에서는 도구 자체보다 일의 모양이 바뀐다는 이야기가 많이 올라왔습니다. r/dataengineering에서는 "파이프라인 대신 챗봇용 시맨틱 레이어만 만든다"는 글이 이달 인기글 2위였고, r/datascience에서는 AI 에이전트가 낸 분석을 무엇으로 검증하는지 묻는 글에 "내가 먼저 분석하고 에이전트 결과와 다른 곳을 판다"는 답이 가장 많은 추천을 받았습니다. 이번 업데이트에도 같은 흐름이 보입니다. DuckDB는 에이전트가 CLI를 돌리면 출력을 줄이는 에이전트 모드를 넣었고, NVIDIA는 에이전트용 온톨로지를 자동으로 만드는 도구를 공개했습니다.
Step 1. DuckDB 2.0 설치하고 JSON을 VARIANT로 다루기
먼저 버전을 올립니다. 11월 21일 기준 pip 최신은 첫 패치인 2.0.1입니다.
pip install -U "duckdb>=2.0"
VARIANT는 행마다 모양이 다른 JSON을 담으면서도 열 단위로 압축·실행하는 타입입니다. 1.5에서 처음 들어왔고 2.0에서 저장·Parquet 읽기쓰기까지 이어졌습니다. 로그나 이벤트처럼 필드가 자주 바뀌는 데이터를 문자열 JSON 대신 이 타입으로 넣습니다.
import duckdb
con = duckdb.connect()
con.sql("""
CREATE TABLE events (payload VARIANT);
INSERT INTO events VALUES
 ('{"user": {"id": 42, "tags": ["a", "b"]}}'::JSON::VARIANT),
 ('{"event": "click", "x": 10, "y": 20}'::JSON::VARIANT);
""")
con.sql("SELECT variant_type(payload) AS t, variant_keys(payload) AS k FROM events").show()
┌─────────┬───────────────┐
│    t    │       k       │
├─────────┼───────────────┤
│ OBJECT  │ [user]        │
│ OBJECT  │ [event, x, y] │
└─────────┴───────────────┘
두 행의 키 구성이 달라도 한 컬럼에 들어가고, variant_keys로 행마다 어떤 필드가 있는지 바로 보입니다.
Step 2. 트리거로 변경 기록 남기기
2.0부터 CREATE TRIGGER가 됩니다. 주문 테이블에 행이 들어올 때마다 감사(audit) 테이블에 같이 기록하는 예제입니다. 새로 들어온 행 전체를 REFERENCING NEW TABLE로 받아 한 번에 넣습니다.
con.sql("CREATE TABLE orders(id INT, amount INT)")
con.sql("CREATE TABLE order_audit(id INT, amount INT, logged_at TIMESTAMP)")
con.sql("""
CREATE TRIGGER log_order AFTER INSERT ON orders
REFERENCING NEW TABLE AS n FOR EACH STATEMENT
INSERT INTO order_audit SELECT id, amount, now() FROM n
""")
con.sql("INSERT INTO orders VALUES (1, 100), (2, 250)")
con.sql("SELECT id, amount FROM order_audit ORDER BY id").show()
orders에 넣은 두 행이 order_audit에도 그대로 남습니다. 공식 문서 기준으로 BEFORE ... FOR EACH ROW, UPDATE ... FOR EACH ROW 조합은 아직 지원하지 않으니, 행 단위 트리거가 필요하면 위처럼 문장 단위(FOR EACH STATEMENT)로 바꿔 씁니다.
Step 3. DuckDB를 서버로 띄우고 다른 프로세스에서 붙기
DuckDB는 원래 한 프로세스 안에서만 도는 데이터베이스였습니다. 2.0은 Quack 프로토콜을 다듬어, 한쪽이 서버를 띄우면 다른 프로세스가 토큰으로 붙습니다. 노트북 하나에서 만든 테이블을 대시보드 프로세스가 같이 읽는 식으로 씁니다.
서버 쪽 파일(server.py)입니다. 실행하면 quack:localhost(내부적으로 http://localhost:9494)에서 대기합니다.
import duckdb, time
con = duckdb.connect()
con.sql("INSTALL quack; LOAD quack;")
con.sql("CALL quack_serve(token = 'my_token')")
con.sql("CREATE TABLE events (date DATE, name VARCHAR)")
con.sql("INSERT INTO events VALUES ('2027-04-07', 'DuckCon #8')")
time.sleep(600)  # 서버를 열어 두는 동안 대기
다른 터미널에서 클라이언트(client.py)를 실행합니다.
import duckdb
c = duckdb.connect()
c.execute("ATTACH 'quack:localhost' AS qk (TOKEN 'my_token')")
print(c.execute("SELECT * FROM qk.events").fetchall())
c.execute("CONNECT qk")  # 이후 qk. 없이 바로 조회
print(c.execute("SELECT * FROM events").fetchall())
[(datetime.date(2027, 4, 7), 'DuckCon #8')]
[(datetime.date(2027, 4, 7), 'DuckCon #8')]
여기서 한 번 막혔습니다. CONNECT 다음에 con.sql(...).show()를 쓰면 materialize() is not available while CONNECT-ed 오류가 납니다. 파이썬에서는 execute().fetchall()로 받으면 됩니다. 서버는 기본으로 localhost에서만 연결을 받고, 다른 컴퓨터에서 붙게 하려면 공식 문서대로 TLS 리버스 프록시 뒤에 둡니다.
Step 4. DuckDB 2.0 올리기 전에 확인할 네 가지
새 기능보다 먼저 봐야 할 변경이 있습니다. 공식 마이그레이션 안내와 저희가 실행하며 걸린 것을 합쳤습니다.
- 저장 파일은 되돌릴 수 없습니다. 2.0으로 만든
.duckdb파일은 2.0 이전 버전이 읽지 못합니다. 기존 파일은 2.0에서 그대로 읽고 씁니다. 여러 서비스가 같은 파일을 공유한다면 전부 같이 올려야 합니다. - 화살표 람다가 막혔습니다.
list_transform([1,2,3], x -> x + 1)은 오류가 나고,lambda x: x + 1로 바꿔야 합니다. 급하면SET lambda_syntax = 'enable_single_arrow';로 잠시 되살리지만, 이 설정은 2.1에서 사라집니다. - 새 파서가 기본입니다. 저희 환경에서는
CREATE TABLE t(at TIMESTAMP)처럼at을 따옴표 없이 컬럼명으로 쓰면 문법 오류가 났고,"at"으로 감싸면 통과했습니다. 예전 파서가 필요하면SET enable_legacy_parser = true;를 씁니다. - 지원 기간을 확인합니다. 2.0 LTS는 최소 2027년 10월까지 지원하고, 이전 LTS인 1.4는 2026년 11월 17일로 지원이 끝났습니다. 1.5는 2027년 3월까지 연장됐습니다.
Step 5. Spark 4.3에서 ASOF JOIN과 JSON_TABLE 써 보기
ASOF JOIN은 "그 시점에 알고 있던 가장 최근 값"을 붙이는 조인입니다. 체결 시각마다 직전 호가를 붙이거나, 주문 시점의 회원 등급을 붙일 때 씁니다. 지금까지는 윈도 함수나 범위 조인으로 직접 짰는데, 4.3부터 SQL 한 줄로 됩니다. 다만 기본값은 꺼져 있어서 설정을 먼저 켜야 합니다.
pip install "pyspark==4.3.0"
from pyspark.sql import SparkSession
spark = SparkSession.builder.master("local[2]").getOrCreate()
spark.conf.set("spark.sql.join.asofJoin.enabled", "true")  # 기본은 꺼짐

spark.sql("""CREATE OR REPLACE TEMP VIEW trades AS SELECT * FROM VALUES
 ('AAPL', TIMESTAMP'2026-11-02 09:00:05', 10),
 ('AAPL', TIMESTAMP'2026-11-02 09:00:12', 5) AS t(sym, ts, qty)""")
spark.sql("""CREATE OR REPLACE TEMP VIEW quotes AS SELECT * FROM VALUES
 ('AAPL', TIMESTAMP'2026-11-02 09:00:00', 230.1),
 ('AAPL', TIMESTAMP'2026-11-02 09:00:10', 230.6),
 ('AAPL', TIMESTAMP'2026-11-02 09:00:20', 231.0) AS q(sym, ts, price)""")

spark.sql("""
SELECT t.sym, t.ts, t.qty, q.price
FROM trades t ASOF JOIN quotes q
  MATCH_CONDITION (t.ts >= q.ts)
  ON t.sym = q.sym
ORDER BY t.ts
""").show(truncate=False)
+----+-------------------+---+-----+
|sym |ts                 |qty|price|
+----+-------------------+---+-----+
|AAPL|2026-11-02 09:00:05|10 |230.1|
|AAPL|2026-11-02 09:00:12|5  |230.6|
+----+-------------------+---+-----+
09:00:05 체결에는 그 직전인 09:00:00 호가가, 09:00:12 체결에는 09:00:10 호가가 붙었습니다. 설정을 켜지 않으면 [UNSUPPORTED_FEATURE.ASOF_JOIN] ... Set "spark.sql.join.asofJoin.enabled" to true 오류가 납니다.
중첩 JSON을 행으로 펴는 JSON_TABLE은 설정 없이 바로 됩니다.
spark.sql("""
SELECT title, content FROM JSON_TABLE(
 '{"sections":[{"title":"Returns","text":"Return within 30 days."},{"title":"Delivery","text":"Ships in 2 days."}]}',
 '$.sections[*]' COLUMNS (title STRING PATH '$.title', content STRING PATH '$.text')) AS s
""").show(truncate=False)
4.3은 이 밖에 실시간 모드의 상태 처리(집계·중복 제거, 100밀리초 안팎 지연), 이력을 보존하는 SCD Type 2 Auto CDC를 넣었고, 이번부터 기능 릴리스를 분기마다 냅니다. 올리기 전에는 릴리스 노트의 두 줄을 확인합니다. Python 3.10 지원이 빠졌고, NumPy 최소 버전이 1.23.2로 올랐습니다. Databricks는 11월 5일 Runtime 19에 4.3을 넣었다고 발표했습니다.
Step 6. UMAP 0.6으로 바꾸고 속도 재 보기
UMAP은 고차원 데이터(임베딩, 설문 응답 등)를 2차원으로 줄여 군집을 눈으로 보게 해 주는 라이브러리입니다. 0.6은 초기화와 최적화 방식을 새로 만들고 이웃 탐색을 빠르게 했습니다. 릴리스 공지에서는 arXiv 논문 300만 건을 5분 안에 처리했다고 소개했습니다. 코드는 그대로 두고 버전만 올리면 됩니다.
pip install -U "umap-learn>=0.6"
저희는 같은 데이터(20만 행 × 50차원, 군집 20개를 인공으로 만든 데이터)를 0.5.12와 0.6.0에 각각 넣고 fit_transform 시간을 쟀습니다. 둘 다 numba 스레드 4개, 작은 데이터로 한 번 예열한 뒤 측정했습니다.
import time, numpy as np, umap
from sklearn.datasets import make_blobs
X, _ = make_blobs(n_samples=200_000, n_features=50, centers=20, random_state=0)
X = X.astype(np.float32)
umap.UMAP().fit_transform(X[:2000])  # 예열(JIT 컴파일)
t = time.time(); emb = umap.UMAP().fit_transform(X); print(f"{time.time() - t:.1f}초")
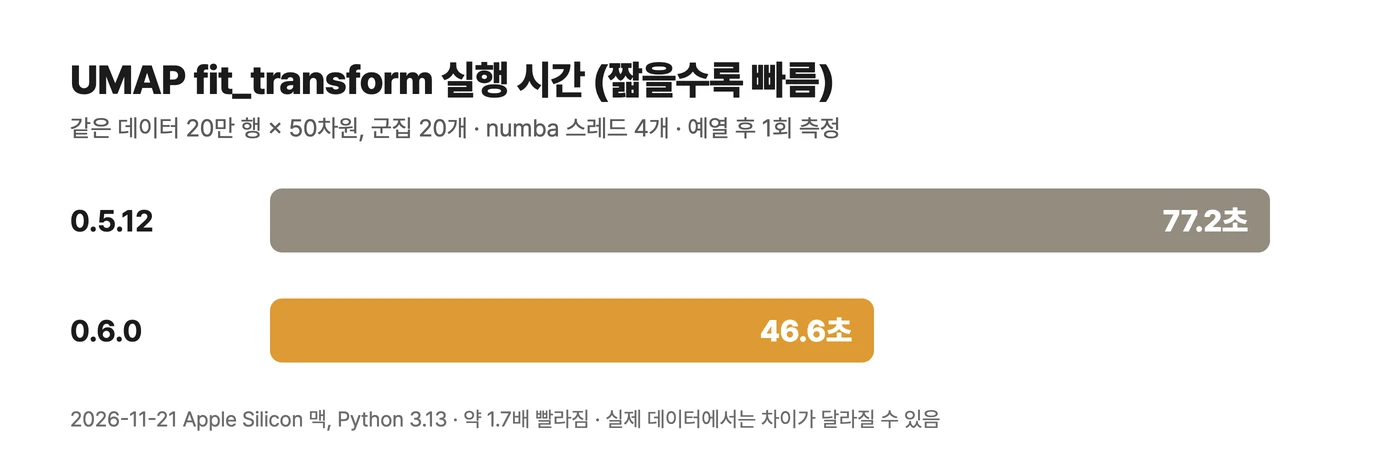
0.5.12는 77.2초, 0.6.0은 46.6초로 약 1.7배 빨라졌습니다. 레딧 공지 글에는 "내 프로젝트에서 5배 빨라졌다"는 댓글도 있었는데, 차이는 데이터 크기와 구조에 따라 달라집니다. 인공 데이터로 한 번 잰 값이라 실제 데이터에서는 직접 재 보는 편이 정확합니다.
Step 7. Airbyte Cloud를 쓴다면 지금 확인할 것
Airbyte는 11월 17일 "전 세계적인 사이버 공격의 일부로 보이는 보안 사고"를 발표했습니다. 회사 발표로는 고객 1% 미만이 처음 공격에 영향을 받았고, 해당 고객에게는 개별 연락했으며, 확산을 막으려고 Airbyte Cloud 전체를 내렸습니다. 상태 페이지의 11월 20일 09:18 UTC(한국 시간 18:18) 공지 기준으로 대부분의 동기화는 돌아왔지만 API 소스는 아직 쓸 수 없고, 데이터베이스 커넥터는 동작합니다. SSO 로그인, Connector Builder, MCP는 아직 중단 상태입니다.
Airbyte Cloud를 쓰는 팀이라면 아래 순서로 확인합니다. 3번은 Airbyte의 공식 요구가 아니라 저희가 권하는 예방 조치입니다.
- 개별 연락이 왔는지 봅니다. 영향받은 고객에게는 Airbyte가 직접 연락했다고 밝혔습니다. 계정 관리자 메일함을 확인하고, 궁금한 점은
[email protected]로 묻습니다. - 빠진 구간을 찾습니다. 11월 17일부터 동기화가 멈춘 연결이 있습니다. 대상 테이블의 마지막 적재 시각을 확인하고, 증분 동기화라면 복구 뒤 빠진 기간이 채워졌는지 행 수로 대조합니다.
- 연결된 자격 증명을 교체할지 검토합니다. Airbyte에 넣어 둔 데이터베이스 비밀번호, API 키, OAuth 토큰 중 권한이 큰 것부터 새로 발급하고 이전 값을 폐기합니다.
- API 소스가 돌아올 때까지의 대안을 정합니다. 매일 꼭 필요한 연결이라면 Airbyte 오픈소스판을 자체 서버에 띄우거나 다른 수집 도구로 임시 우회합니다.
r/dataengineering의 관련 글에는 원인 공지가 늦었다는 불만이 많았습니다. 이번 일로 SaaS 수집 도구 하나에 모든 파이프라인을 걸어 둔 팀은 장애 때 대안을 미리 정해 둘 필요가 생겼습니다.
이번 달 더 볼 소식
직접 돌려 보지는 않았지만 알아 두면 좋은 소식입니다. 각 항목은 공식 발표나 원문 기준으로 정리했습니다.
| 소식 | 내용 | 참고 |
|---|---|---|
| NVIDIA Auto-Ontology 공개 | 회사 데이터베이스의 메타데이터에서 온톨로지(용어·관계·지표 정의)를 자동으로 만들고, 사람이 검수한 뒤 MCP·CLI·API로 에이전트에 제공합니다. Apache 2.0, DuckDB·Snowflake·Databricks 등 10개 엔진 연결. 기본 모델은 NVIDIA API 키가 필요합니다. | GitHub |
| dbt v2로 엔진 섞어 쓰기 | 9월 GA된 dbt v2(Rust로 다시 짠 엔진)로 한 프로젝트 안에서 Snowflake와 DuckDB가 같은 Iceberg 테이블을 나눠 만드는 가이드가 나왔습니다. 엔진 순서 지정 등은 아직 수작업입니다. | Greybeam, dbt v2 GA |
| mizu·pymizu (Posit) | R·Python 병렬 처리를 소켓 대신 공유 메모리로 돌려, 작업 한 번 왕복이 약 100µs에서 1µs 아래로 줄었다고 발표했습니다. 저희 환경은 공유 메모리 생성이 막혀 직접 재지 못했습니다. | Posit 블로그 |
| DuckLake 1.1 | DuckDB 팀의 레이크하우스 포맷 새 버전과 명세가 2.0과 같은 날 나왔습니다. 레딧에서는 Dagster·dbt와 묶어 운영 중이라는 사례가 올라왔습니다. | DuckLake, 레딧 |
| DuckDB CLI 에이전트 모드 | Claude Code·Codex 같은 코딩 에이전트가 CLI를 돌리면 이를 감지해 표를 짧은 Markdown으로 내고 오류를 JSON으로 알립니다. DuckDB 팀 실험에서 모델이 읽을 출력이 59% 줄었습니다. | DuckDB 블로그 |
자주 막히는 곳
| 증상 | 원인 | 해결 |
|---|---|---|
Deprecated lambda arrow (->) detected | DuckDB 2.0에서 화살표 람다가 기본으로 꺼짐 | lambda x: x + 1 문법으로 바꾸기 |
syntax error at or near "at" | 2.0 새 파서에서 일부 단어가 따옴표 없이 컬럼명으로 안 됨 | "at"처럼 큰따옴표로 감싸기 |
파이썬에서 $변수 쿼리 시 Values were not provided for the following parameters | 파이썬 클라이언트가 $이름을 쿼리 파라미터로 해석 | 값을 params로 넘기거나 SQL 안에서 getvariable('이름') 쓰기 |
materialize() is not available while CONNECT-ed | CONNECT 상태에서 .sql().show() 사용 | execute().fetchall()로 받거나 qk.테이블처럼 이름을 붙여 조회 |
| 구버전 DuckDB가 파일을 못 읽음 | 2.0이 쓴 파일은 이전 버전과 호환 안 됨 | 같은 파일을 쓰는 프로그램을 모두 2.0으로 올리기 |
Spark [UNSUPPORTED_FEATURE.ASOF_JOIN] | ASOF JOIN 기본값이 꺼짐 | spark.sql.join.asofJoin.enabled를 true로 |
Unable to locate a Java Runtime | PySpark는 Java가 필요 | JDK 17 또는 21 설치 후 JAVA_HOME 지정 |