따릉이 공개 데이터 해부: 데이터셋 19개 지도와 실측 함정 22개, 2년치 7,832만 건으로 확인한 7단계
이 글과 연결된 글 보기
드래그로 이동 · 휠/두 손가락으로 확대 · 방향키로 글 선택 · 0으로 맞춤. 실선: 본문 링크, 점선: 시리즈·주제의 대표 연결.표시된 글 32편 목록
따릉이 데이터는 하나가 아닙니다. 서울 열린데이터광장에서 "따릉이"로 검색하면 데이터셋이 19개 나오고, 그중 진짜 원천은 대여 한 건이 한 줄인 대여이력 하나입니다. 나머지 대부분은 이 원천을 날짜·대여소·성별·연령으로 묶어 놓은 집계입니다. 이 구조를 모르고 시작하면 같은 숫자를 두 번 세거나, 반기마다 바뀌는 파일 형식에 걸려 몇 시간을 날립니다.
이 글은 19개를 전부 열어 보고, 2024년 7월부터 2026년 6월까지 대여이력 7,832만 건을 직접 받아 정리한 기록입니다. 모든 명령과 수치는 2026년 10월 28일에 실제로 실행한 결과입니다.
이 글은 이런 분께 필요합니다
- 따릉이 데이터로 포트폴리오 분석을 해 보고 싶은데, 데이터셋이 너무 많아서 무엇부터 받아야 할지 모르는 분
- 공공데이터를 처음으로 수백 MB 단위로 받아 보는 분
- 수업에서 "원천과 집계를 대조하는 습관"을 보여 줄 예제가 필요한 분
API로 대여소 현황을 매시간 쌓는 파이프라인은 따릉이 대여소 데이터 수집·전처리·적재 편에 있습니다. 이 글은 그 전 단계, 어떤 데이터가 있고 어디가 함정인지를 다룹니다.
- 원천은
대여이력(OA-15182) 하나입니다. 일별·시간대별·월별 이용정보는 이것을 묶은 집계라서, 2026년 6월 합계가 4,066,539건(일별), 4,066,383건(시간대별), 4,066,681건(공식 일별 대여건수)으로 거의 같습니다. - 파일은 API 키 없이 받을 수 있습니다. 대신 데이터셋마다 다운로드 파라미터가 조금씩 다릅니다.
- 함정은 대부분 반기마다 파일 형식이 바뀌는 것에서 나옵니다. 인코딩, 칼럼 이름, 코드 체계, 확장자가 바뀝니다.
- 2026년 대여이력은 공식 집계보다 2.7~3.1% 많습니다. 0분 이용 기록이 새로 들어왔기 때문으로 보입니다.
Step 1. 19개 데이터셋 중 무엇을 받을지 고르기
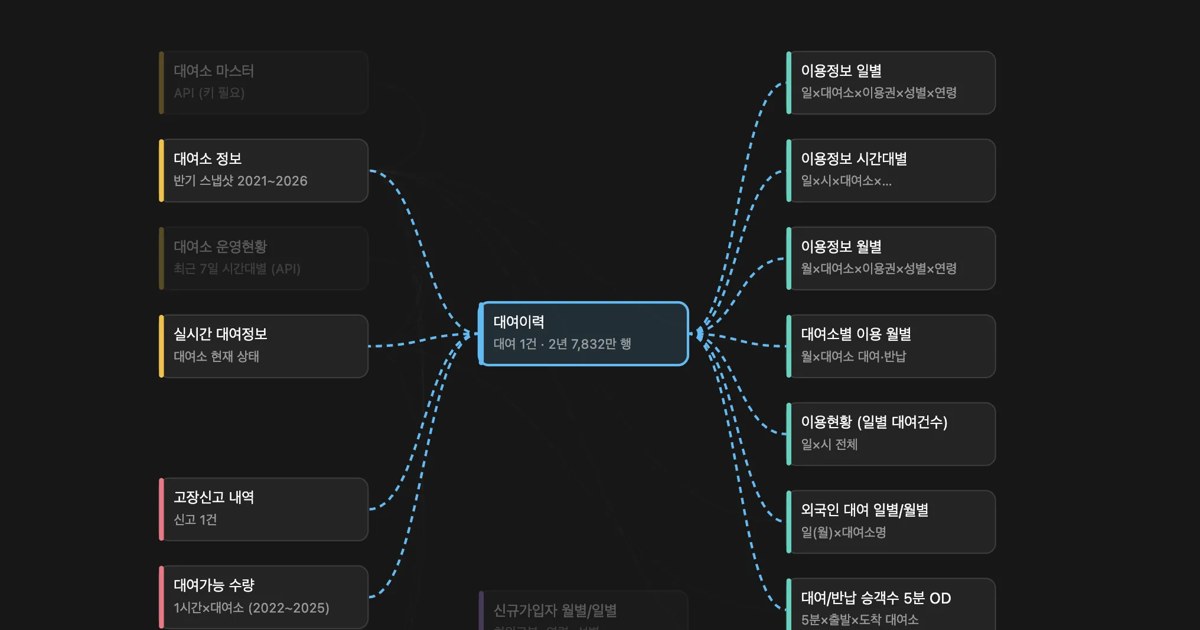
먼저 지도를 봅니다. 가운데가 원천, 오른쪽이 집계, 왼쪽이 대여소 정보·실시간·운영 데이터입니다.
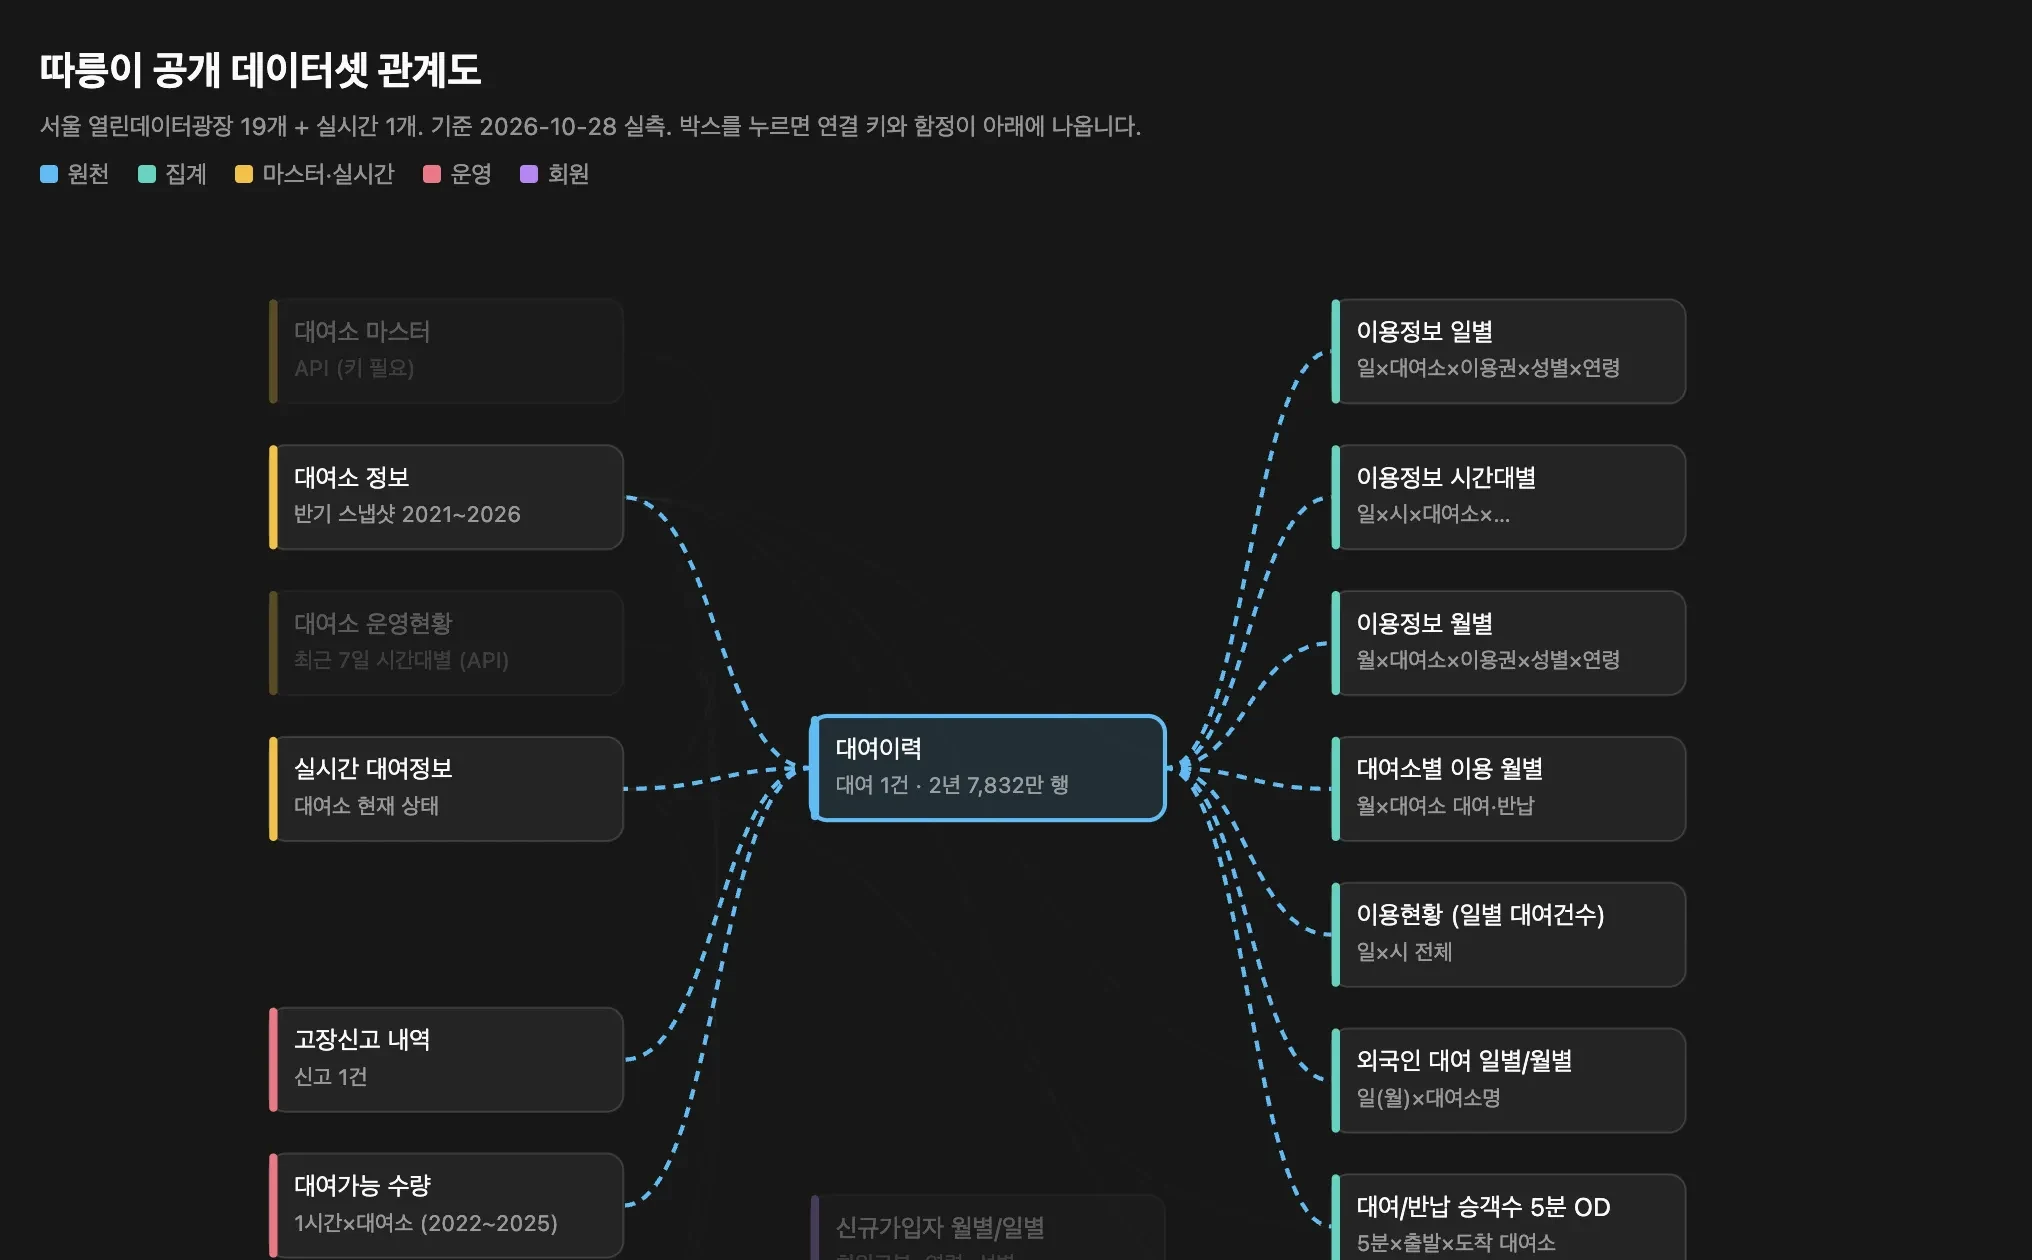
관계도를 직접 눌러 보기: 박스를 누르면 어떤 키로 연결되는지와 그 데이터셋의 함정이 나옵니다.
질문에 따라 고르면 됩니다.
| 하고 싶은 분석 | 받을 데이터셋 | 크기 감각 |
|---|---|---|
| 어느 대여소에서 어디로 가나, 몇 분 타나 | 대여이력 (OA-15182) | 한 달 300~720MB |
| 대여소별·연령대별 이용량 추세 | 이용정보 월별 (OA-15248) | 반기 50~65MB |
| 하루 총 이용량, 날씨 영향 | 이용현황의 일별 대여건수 (OA-14994) | 반기 몇 KB |
| 대여소 위치·거치대 수 | 대여소 정보 (OA-13252) | 0.3MB 엑셀 |
| 자전거 고장 | 고장신고 내역 (OA-15644) | 반기 2~3MB |
| 빈 대여소가 얼마나 자주 생기나 | 대여가능 수량 (OA-22382) | 분기 60~550MB |
| 5분 단위 출근 물결 | 대여/반납 승객수 (OA-21229) | 하루 4~6MB zip |
처음이라면 이용현황(일별 대여건수)으로 전체 흐름을 보고, 대여이력 한 달치로 넘어가는 순서를 권합니다. 대여이력은 한 달에 400만 줄이라 엑셀로는 열리지 않습니다.
Step 2. API 키 없이 파일 받기
데이터셋 페이지의 다운로드 버튼은 내부적으로 downloadFile('150') 같은 함수를 부르고, 이 함수는 폼을 POST합니다. 같은 요청을 터미널에서 보내면 됩니다.
curl -X POST "https://datafile.seoul.go.kr/bigfile/iot/inf/nio_download.do?useCache=false" \
  -d "infId=OA-15182&seqNo=&seq=150&infSeq=1" \
  -H "Referer: https://data.seoul.go.kr/" \
  -o rent_2606.csv
infId: 데이터셋 IDseq: 파일 번호. 데이터셋 페이지 HTML에서downloadFile('숫자')를 찾으면 나옵니다. 위 예시의 150은 2026년 6월 대여이력입니다.infSeq: 대부분 1인데, 대여소 정보(OA-13252)와 시간대별 이용정보(OA-15245)만 2입니다. 페이지의frmFile폼 안 값을 확인하세요.
infSeq가 틀리면 오류 코드 없이 HTTP 200으로 "잘못된 접근입니다"라는 HTML이 내려옵니다. 받은 파일의 첫 줄이 <html로 시작하면 실패로 처리해야 합니다.
목록에 적힌 용량도 믿으면 안 됩니다. 대여이력 2025년 묶음은 목록에 "1MB"로 나오는데 실제로는 1.78GB였습니다. 연도 zip은 1.8~2.1GB씩이니 디스크 여유를 먼저 확인하세요.
Step 3. 인코딩과 파일 종류부터 확인하기
받은 파일 대부분은 CP949(한글 윈도우 인코딩)입니다. 그런데 같은 데이터셋 안에서도 반기마다 UTF-8이 섞입니다. 파이썬 pandas는 encoding='cp949'로 읽으면 되지만, DuckDB는 CP949를 바로 읽지 못해서 먼저 바꿔야 합니다.
iconv -c -f cp949 -t utf-8 rent_2606.csv > rent_2606.u8.csv
확장자도 믿으면 안 됩니다. 아래 파일들은 이름이 .csv인데 실제로는 엑셀입니다.
- 신규가입자 일별
22.07-22.12.csv - 고장신고
22.07-12.csv - 대여소별 이용정보
22.7-22.12.csv - 외국인 대여정보
22.07\~22.12.csv
파일 첫 두 글자가 PK면 엑셀(xlsx)입니다. 신규가입자 일별 24.7-12.csv는 헤더가 아예 없어서 첫 줄이 2024-07-01,회원-내국인,10대,F,77로 시작합니다.
Step 4. DuckDB로 parquet 만들기
UTF-8로 바꾼 대여이력 한 달치(4,182,797줄, 813MB)를 parquet로 바꾸면 94MB가 되고, 이후 집계는 몇 초면 끝납니다.
import duckdb
con = duckdb.connect()
con.sql("""
  copy (select * from read_csv('rent_2606.u8.csv', header=true, all_varchar=true, nullstr='\\N'))
  to 'rent_2606.parquet' (format parquet, compression zstd)
""")
all_varchar=true로 일단 전부 문자로 읽는 이유는 대여소 번호 00102의 앞자리 0이 숫자 변환에서 사라지기 때문입니다.
128개월을 이렇게 처리했을 때 16개월에서 The Parallel CSV Reader currently does not support a full read on this file 오류가 났습니다. read_csv(..., parallel=false)로 다시 읽으면 됩니다.
Step 5. 대여소 번호 맞추기
같은 대여소가 파일마다 다르게 적혀 있습니다. 망원역 1번출구 앞 대여소 하나가 이렇게 나옵니다.
| 파일 | 표기 |
|---|---|
| 대여이력 | 00102 (대여소번호), ST-4 (대여소ID) |
| 대여소 정보 엑셀 | 102 |
| 외국인 대여정보, 대여소별 이용정보 | 102. 망원역 1번출구 앞 (이름 안에 번호) |
| 실시간 대여정보, 5분 OD | ST-4 |
번호는 다섯 자리로 앞을 0으로 채워 맞추고(lpad(번호, 5, '0')), ID(ST-)는 대여이력에 번호와 ID가 함께 있으니 거기서 매핑표를 만들면 됩니다.
대여소 정보 엑셀은 위 4줄이 병합 헤더(LCD/QR, 자치구/상세주소/위도/경도 등)라서, 첫 칸이 숫자인 행만 데이터로 남겨야 합니다.
대여소 수도 출처마다 다릅니다. 같은 시기에 대여소 정보 2,789곳, 실시간 데이터 2,744곳, 2026년 6월 실제로 대여가 일어난 곳 2,761곳이었습니다. "대여소 수"를 쓸 때는 출처를 같이 적어야 합니다.
Step 6. 원천과 집계 대조하기
숫자를 쓰기 전에 원천(대여이력)과 공식 집계(일별 대여건수)를 월별로 맞춰 봤습니다.
| 기간 | 대여이력 − 공식 |
|---|---|
| 2024-07 ~ 2025-12 | 월 −1 ~ −176건 (사실상 일치) |
| 2026-01 | +44,765건 (+2.8%) |
| 2026-04 | +113,502건 (+3.0%) |
| 2026-06 | +116,116건 (+2.9%) |
2026년부터 대여이력이 3% 가까이 많습니다. 같은 시기에 이용시간 0분인 기록이 월 1~3천 건에서 3.9만~10.4만 건으로 늘었습니다. 즉시 반납이나 취소에 가까운 기록이 대여이력에 새로 들어온 것으로 보입니다. 2025년과 2026년을 대여이력으로 바로 비교하면 실제보다 덜 줄어든 것처럼 나옵니다.
이 외에도 2년치에서 확인한 함정입니다.
- 성별이 비어 있는 기록이 25.6%입니다. 결측을 빼면 남 65 : 여 35입니다.
- 생년으로 계산한 나이가 100세 이상인 기록이 약 24만 건 있습니다.
- 반납 대여소가 비어 있는 기록이 월 1~2만 건 있습니다. 대여소별로 묶으면 "이름 없는 대여소"가 상위권에 올라옵니다.
자전거구분(일반/새싹) 칼럼이 2026년 파일에서 사라졌습니다.- 5분 OD 파일에는 출발시간 기준 행과 도착시간 기준 행이 같이 들어 있습니다. 그냥 더하면 두 배가 됩니다.
- 고장신고에는
SPB-00001(197건) 같은 가짜 자전거번호가 있고, 신고 한 번이 부위별로 여러 행이 됩니다.
Step 7. 첫 분석 세 가지
정리한 데이터로 해 본 첫 분석입니다. 원인까지 확인한 결론은 아니고, 데이터가 보여 주는 모양입니다.
하나, 2년 사이 이용이 6% 줄었고 감소분의 대부분이 20대입니다. 공식 집계로 1년차(2024.7~2025.6) 4,016만 건, 2년차(2025.7~2026.6) 3,763만 건(−6.3%)입니다. 대여이력의 생년 기준으로 나누면 20대가 1,111만 건에서 967만 건으로 143만 건 줄었고, 40대 이상은 오히려 늘었습니다.
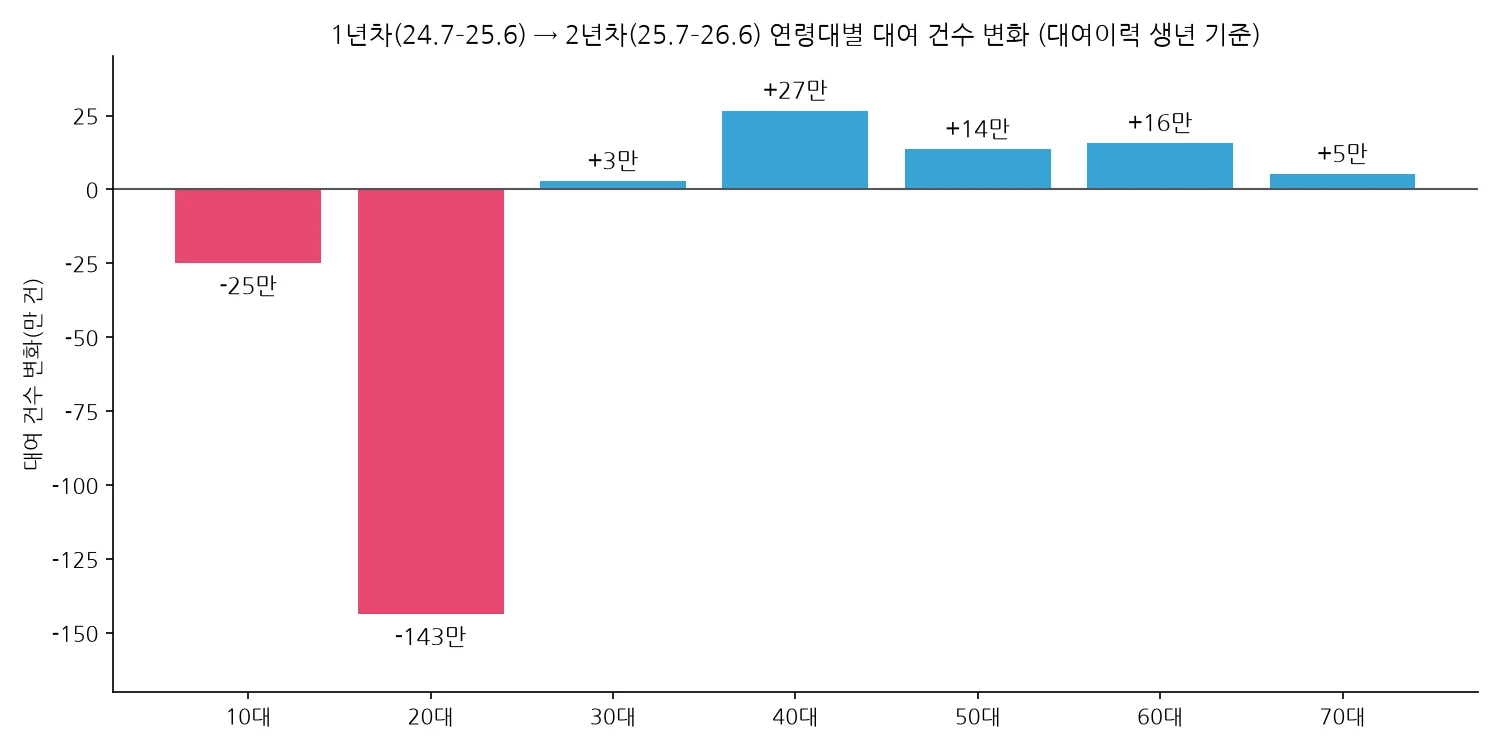
다만 생년이 비어 있는 기록도 270만 건에서 175만 건으로 함께 줄었습니다. 결측에서 연령대로 옮겨 간 몫이 있을 수 있습니다. 또 이 비교는 0분 기록이 들어간 2026년 대여이력을 그대로 썼기 때문에 모든 연령대가 조금씩 부풀려져 있습니다. 공유 킥보드·요금·기후동행카드 같은 원인은 이 데이터만으로는 판단할 수 없습니다.
둘, 평일과 주말은 다른 교통수단입니다. 평일은 8시(하루 평균 1.04만 건)와 18시(1.20만 건)에 봉우리가 두 개 서고, 주말은 오후 5시를 꼭대기로 완만한 산 하나입니다.
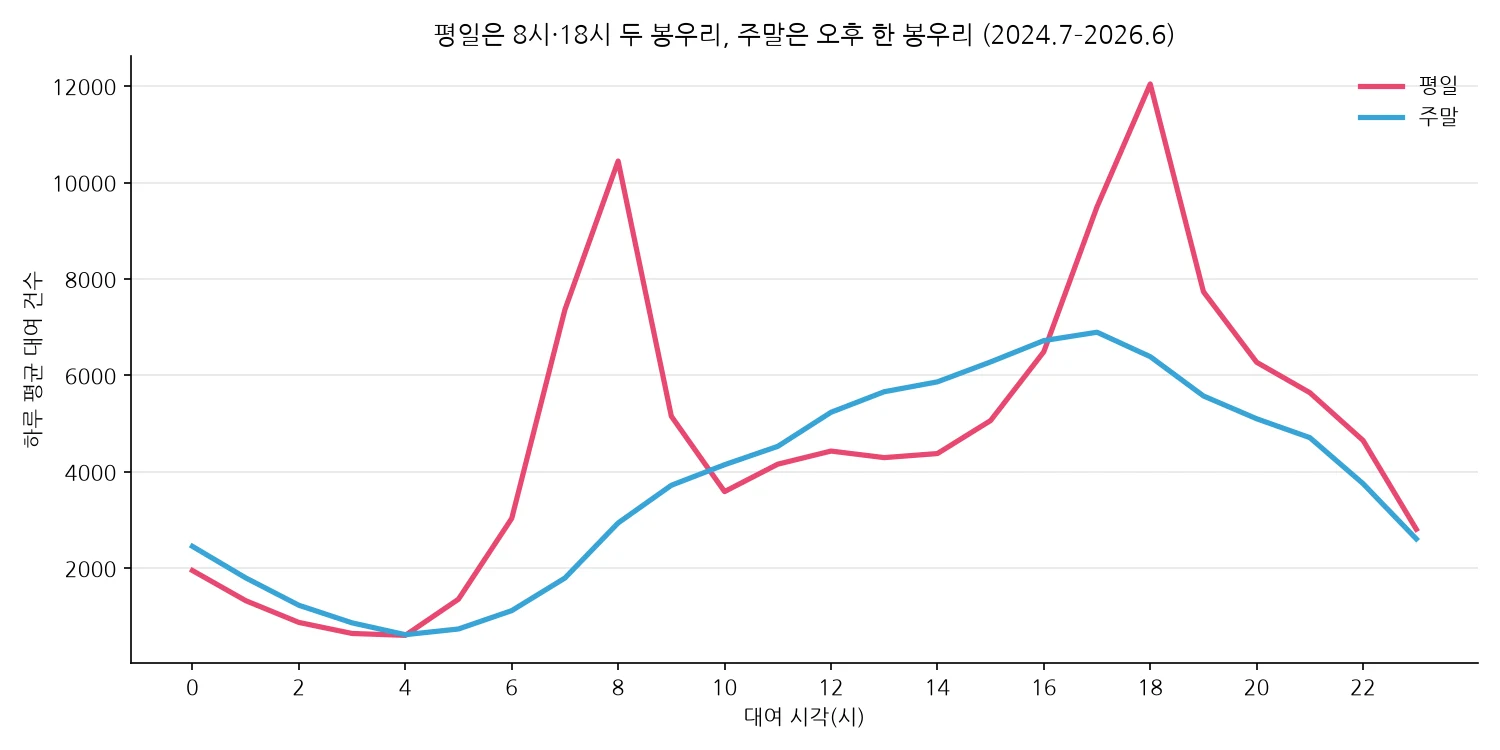
평일 출근 시간(7~9시)에 대여만 많고 반납이 적은 곳은 마곡13단지 정문 앞(대여 3.7만, 반납 0.5만)이었고, 반납이 몰리는 곳은 LG사이언스파크 E14동(순유입 7.1만)과 LG유플러스 마곡사옥(6.6만)이었습니다. 아파트에서 역, 역에서 회사로 가는 흐름이 데이터에 그대로 보입니다. 가장 많이 오간 구간도 신정보도육교 아래 → 오목교역 6번 출구(3.2만 건, 중앙값 4분)처럼 전부 아파트와 역 사이 400~800m였습니다.
셋, 한강버스 선착장이 왕복 대여 상위권에 올라왔습니다. 빌린 곳에 다시 반납하는 왕복 대여는 전체의 7.7%이고, 1위는 한강공원 망원나들목(3.5만 건, 중앙값 51분)입니다. 상위 10곳 중 3곳이 한강버스 여의도·망원·뚝섬 선착장 대여소였고, 선착장 대여소 대여는 2025년 8월부터 생겼습니다. 이 수요가 주변 대여소에서 옮겨 온 것인지 새로 생긴 것인지는 따로 봐야 합니다.
정리
| 확인할 것 | 이유 |
|---|---|
| 원천인지 집계인지 | 같은 이용을 두 번 세지 않으려고 |
| 받은 파일이 HTML이 아닌지, 엑셀이 아닌지 | 다운로드 실패와 가짜 확장자 |
| 인코딩 | CP949와 UTF-8이 반기마다 섞임 |
| 대여소 번호 형식 | 00102 / 102 / 102. 이름 / ST-4 |
| 공식 집계와 월 합계 | 2026년부터 3% 차이 |
다음 글에서는 이 데이터로 한 가지 질문을 끝까지 파 보겠습니다.