'요즘 하자 민원 늘었죠?' 엑셀 3개로 확인하는 6단계: 늘어난 건 따로 있었습니다
이 글과 연결된 글 보기
드래그로 이동 · 휠/두 손가락으로 확대 · 방향키로 글 선택 · 0으로 맞춤. 실선: 본문 링크, 점선: 시리즈·주제의 대표 연결.표시된 글 8편 목록
1월 회의에서 누군가 "요즘 하자 민원이 많이 늘었다"고 말했다고 해 보겠습니다. 실제로 1월 하자 접수는 153건으로, 10월(74건)의 두 배입니다. 틀린 말 같지 않습니다.
그런데 작년 1월과 놓으면 155건입니다. 1~2월을 합쳐도 303건에서 305건으로, 2건 늘었습니다. 같은 기간 두 배 넘게 늘어난 건 따로 있었습니다. 관리비 문의입니다(153건 → 335건).
이 글은 엑셀 파일 3개로 이 결론에 도달하는 과정을 6단계로 정리한 안내서입니다. 쓰는 데이터는 아파트 16개 단지의 18개월치 교육용 가상 데이터이고, 글 끝에서 그대로 내려받을 수 있습니다. 글에 나오는 모든 숫자는 2026년 10월 20일에 원본 CSV로 직접 다시 계산해 맞춰 본 값입니다.
이 글은 이런 분께 필요합니다
- 이런 분: 엑셀은 매일 쓰지만 데이터 분석은 따로 배운 적 없는 현업 직장인. ChatGPT에 엑셀을 올려 본 적은 있는데, 나온 숫자를 그대로 보고서에 써도 되는지 늘 찜찜했던 분.
- 필요한 것: 엑셀, 그리고 파일을 올릴 수 있는 ChatGPT(무료도 됩니다). 코딩은 하지 않습니다.
- 필요한 시간: 처음이면 1시간 정도. 6단계를 따라 하면 끝에 한 장짜리 현황 보고서가 생깁니다.
- 이 글에서 하지 않는 것: 통계 검정이나 예측 모델은 다루지 않습니다. "늘었다는 말이 맞는가, 맞다면 왜인가"까지만 다룹니다.
먼저 파일 3개를 봅니다
| 파일 | 크기 | 한 행이 뜻하는 것 | 이 파일에만 있는 것 |
|---|---|---|---|
| ① 관리비 부과현황 | 288행 · 11열 | 한 단지의 한 달 관리비 | 지역, 준공연도, 세대수 |
| ② 하자접수 | 1,834행 · 8열 | 하자 접수 한 건 | 하자코드(누수, 결로, 도배·마감 등) |
| ③ CS접수 | 5,232행 · 8열 | 고객 문의·민원 한 건 | 문의유형, 만족도 |
중요한 점이 하나 있습니다. 세대수는 ①번 파일에만 있습니다. 하자 파일에는 단지명만, CS 파일에는 단지코드만 있습니다. 그래서 세 파일은 결국 단지를 기준으로 붙여야 하고, 붙이려면 단지 이름부터 맞아야 합니다. Step 2가 그 일입니다.
Step 1. "늘었다"를 비교할 수 있는 문장으로 바꿉니다
"하자 민원이 늘었다"는 아직 확인할 수 없는 문장입니다. 무엇과 비교해서 늘었는지가 빠져 있기 때문입니다. 분석을 시작하기 전에 세 가지를 정합니다.
| 정할 것 | 고르는 예 | 이 글의 선택 |
|---|---|---|
| 무엇을 셀까 | 하자 접수 건수 / CS의 하자 문의 건수 | 하자 접수 건수 (②번 파일) |
| 무엇과 비교할까 | 지난달 / 작년 같은 달 | 작년 같은 달 |
| 어떤 단위로 볼까 | 건수 / 1,000세대당 건수 | 둘 다 보고, 단지끼리 비교할 때는 1,000세대당 |
"작년 같은 달"을 고르는 이유가 있습니다. 하자에는 계절이 있습니다. 겨울에는 결로와 동파성 누수가 몰립니다. 1월을 10월과 비교하면 계절 차이를 "증가"로 착각하게 됩니다.
ChatGPT에 처음 보내는 글은 이 세 가지를 그대로 담습니다. 아래 틀의 4칸을 한 줄씩 채우면 됩니다.
① 나는 아파트 관리회사 CS팀이야. 팀장님이 "요즘 하자 민원이 늘었다"고 해서 숫자로 확인하려고 해.
② 올린 파일 3개(관리비 부과현황, 하자접수, CS접수)를 봐.
③ 각 파일이 몇 행·몇 열이고, 한 행이 무엇을 뜻하는지, 세 파일을 무엇으로 연결할 수 있는지 알려줘. 아직 분석이나 계산은 하지 마.
④ 파일별로 표 하나씩, "행 수 / 열 이름 / 연결 열 / 눈에 띄는 표기 문제" 순서로 줘.
③번 칸의 "아직 계산은 하지 마"가 중요합니다. 이 말이 없으면 ChatGPT는 지저분한 데이터를 그대로 세어서 바로 그럴듯한 결론을 냅니다.
Step 2. 합치기 전에 표기와 중복부터 맞춥니다
실무 엑셀은 사람이 손으로 입력한 기록이라 같은 것이 여러 모양으로 적혀 있습니다. 이 데이터에서 실제로 확인한 문제는 이렇습니다.
| 파일 | 문제 | 원본 | 정리 후 |
|---|---|---|---|
| ② 하자접수 | 단지명 표기가 제각각 (라일락자이, 라일락XI, 라일락 자이, 라일락자이(단지), 끝 공백) | 75가지 | 16개 단지 |
| ② 하자접수 | 접수일 형식 4종 (2025-01-02, 20250105, 2025.1.9, 25/02/19) | 4종 | YYYY-MM 한 형식 |
| ② 하자접수 | 같은 접수번호가 두 번 나오는 행 | 1,834행 | 1,799건 (35행 제거) |
| ③ CS접수 | 단지코드 소문자·끝 공백 (xi01, XI01␣) | 48가지 | 16개 |
| ③ CS접수 | 같은 뜻 다른 이름 (주차/주차관련, 관리비/관리비 문의) | 11종 | 7종 |
| ① 관리비 | 부과월 형식 5종 (2025-01, 2025.2, 2025/07, 25년 10월, 202606) + 완전히 같은 행 6개 | 288행 | 282행 |
왜 이게 결론을 바꾸는가
단지명을 맞추지 않고 하늘채움자이로만 세면 219건이 나옵니다. 표기를 통일하면 280건입니다. 61건, 약 22%가 다른 이름 뒤에 숨어 있었습니다. 순위표 1등의 숫자가 이만큼 틀리면, 그 아래 단지들의 순서도 믿을 수 없습니다.
중복도 같은 문제를 만듭니다. 35개 접수번호를 직접 열어 보면, 모두 같은 접수 한 건을 표기만 다르게 두 번 적은 것이었습니다. 하나는 2025-01-09, 하나는 2025.1.9처럼요. 그래서 "모든 칸이 똑같은 행"만 찾으면 9건밖에 안 잡힙니다. 접수번호를 기준으로 찾아야 35건이 다 나옵니다.
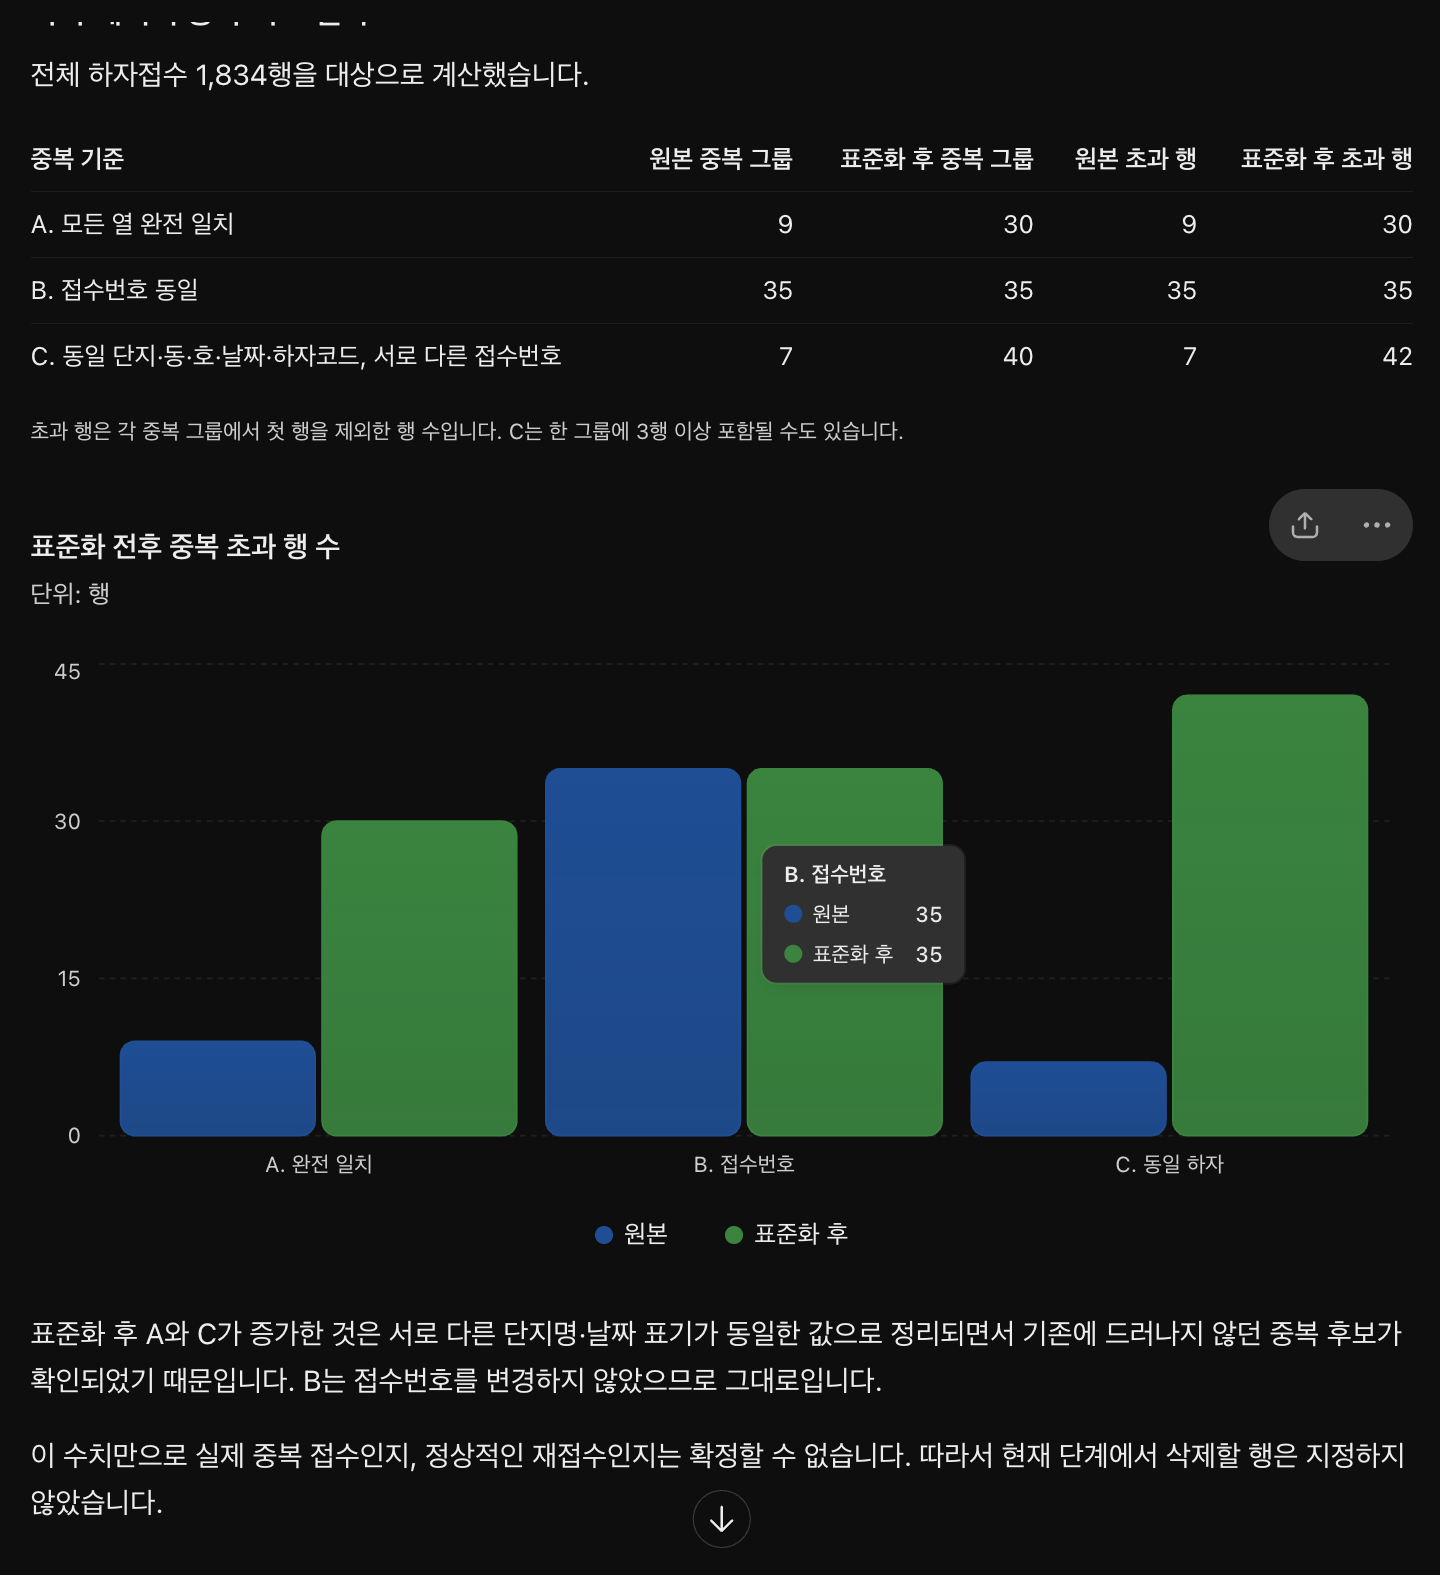
교육 준비 중 실제로 ChatGPT에 같은 파일을 올려 받은 화면입니다. 중복을 어떤 기준으로 보느냐에 따라 9건, 35건, 42건으로 답이 달라집니다.
ChatGPT에 보낼 글은 이렇게 씁니다.
① 나는 하자 현황을 단지별로 비교하려고 해.
② 하자접수 파일의 단지명 열과 관리비 파일의 단지명 열을 봐.
③ 하자 파일 단지명을 관리비 파일의 단지명 16개 중 하나로 바꾸는 대응표를 만들어 줘. 접수일은 YYYY-MM으로 통일하고, 접수번호가 같은 행은 몇 개인지 먼저 보여줘. 아직 지우지는 마.
④ 대응표는 "원래 표기 / 바꿀 이름 / 행 수" 표로, 중복은 접수번호별로 두 행을 나란히 보여줘.
"아직 지우지는 마"를 넣는 이유는, 지우기 전에 사람이 눈으로 확인해야 하기 때문입니다. 같은 접수번호라도 진짜 재접수일 수 있습니다. 이 데이터에서는 확인해 보니 모두 같은 건이어서 지웠습니다.
Step 3. 건수 대신 1,000세대당으로 다시 줄 세웁니다
단지마다 크기가 다릅니다. 라일락자이는 2,140세대, 새솔자이는 820세대입니다. 큰 단지는 하자도 많이 접수되는 게 당연합니다. 그래서 단지끼리 비교할 때는 세대수로 나눈 값을 봅니다.
1,000세대·월당 하자 건수 = 하자 건수 ÷ 세대수 ÷ 개월 수 × 1,000
이렇게 다시 매기면 순서가 바뀝니다.
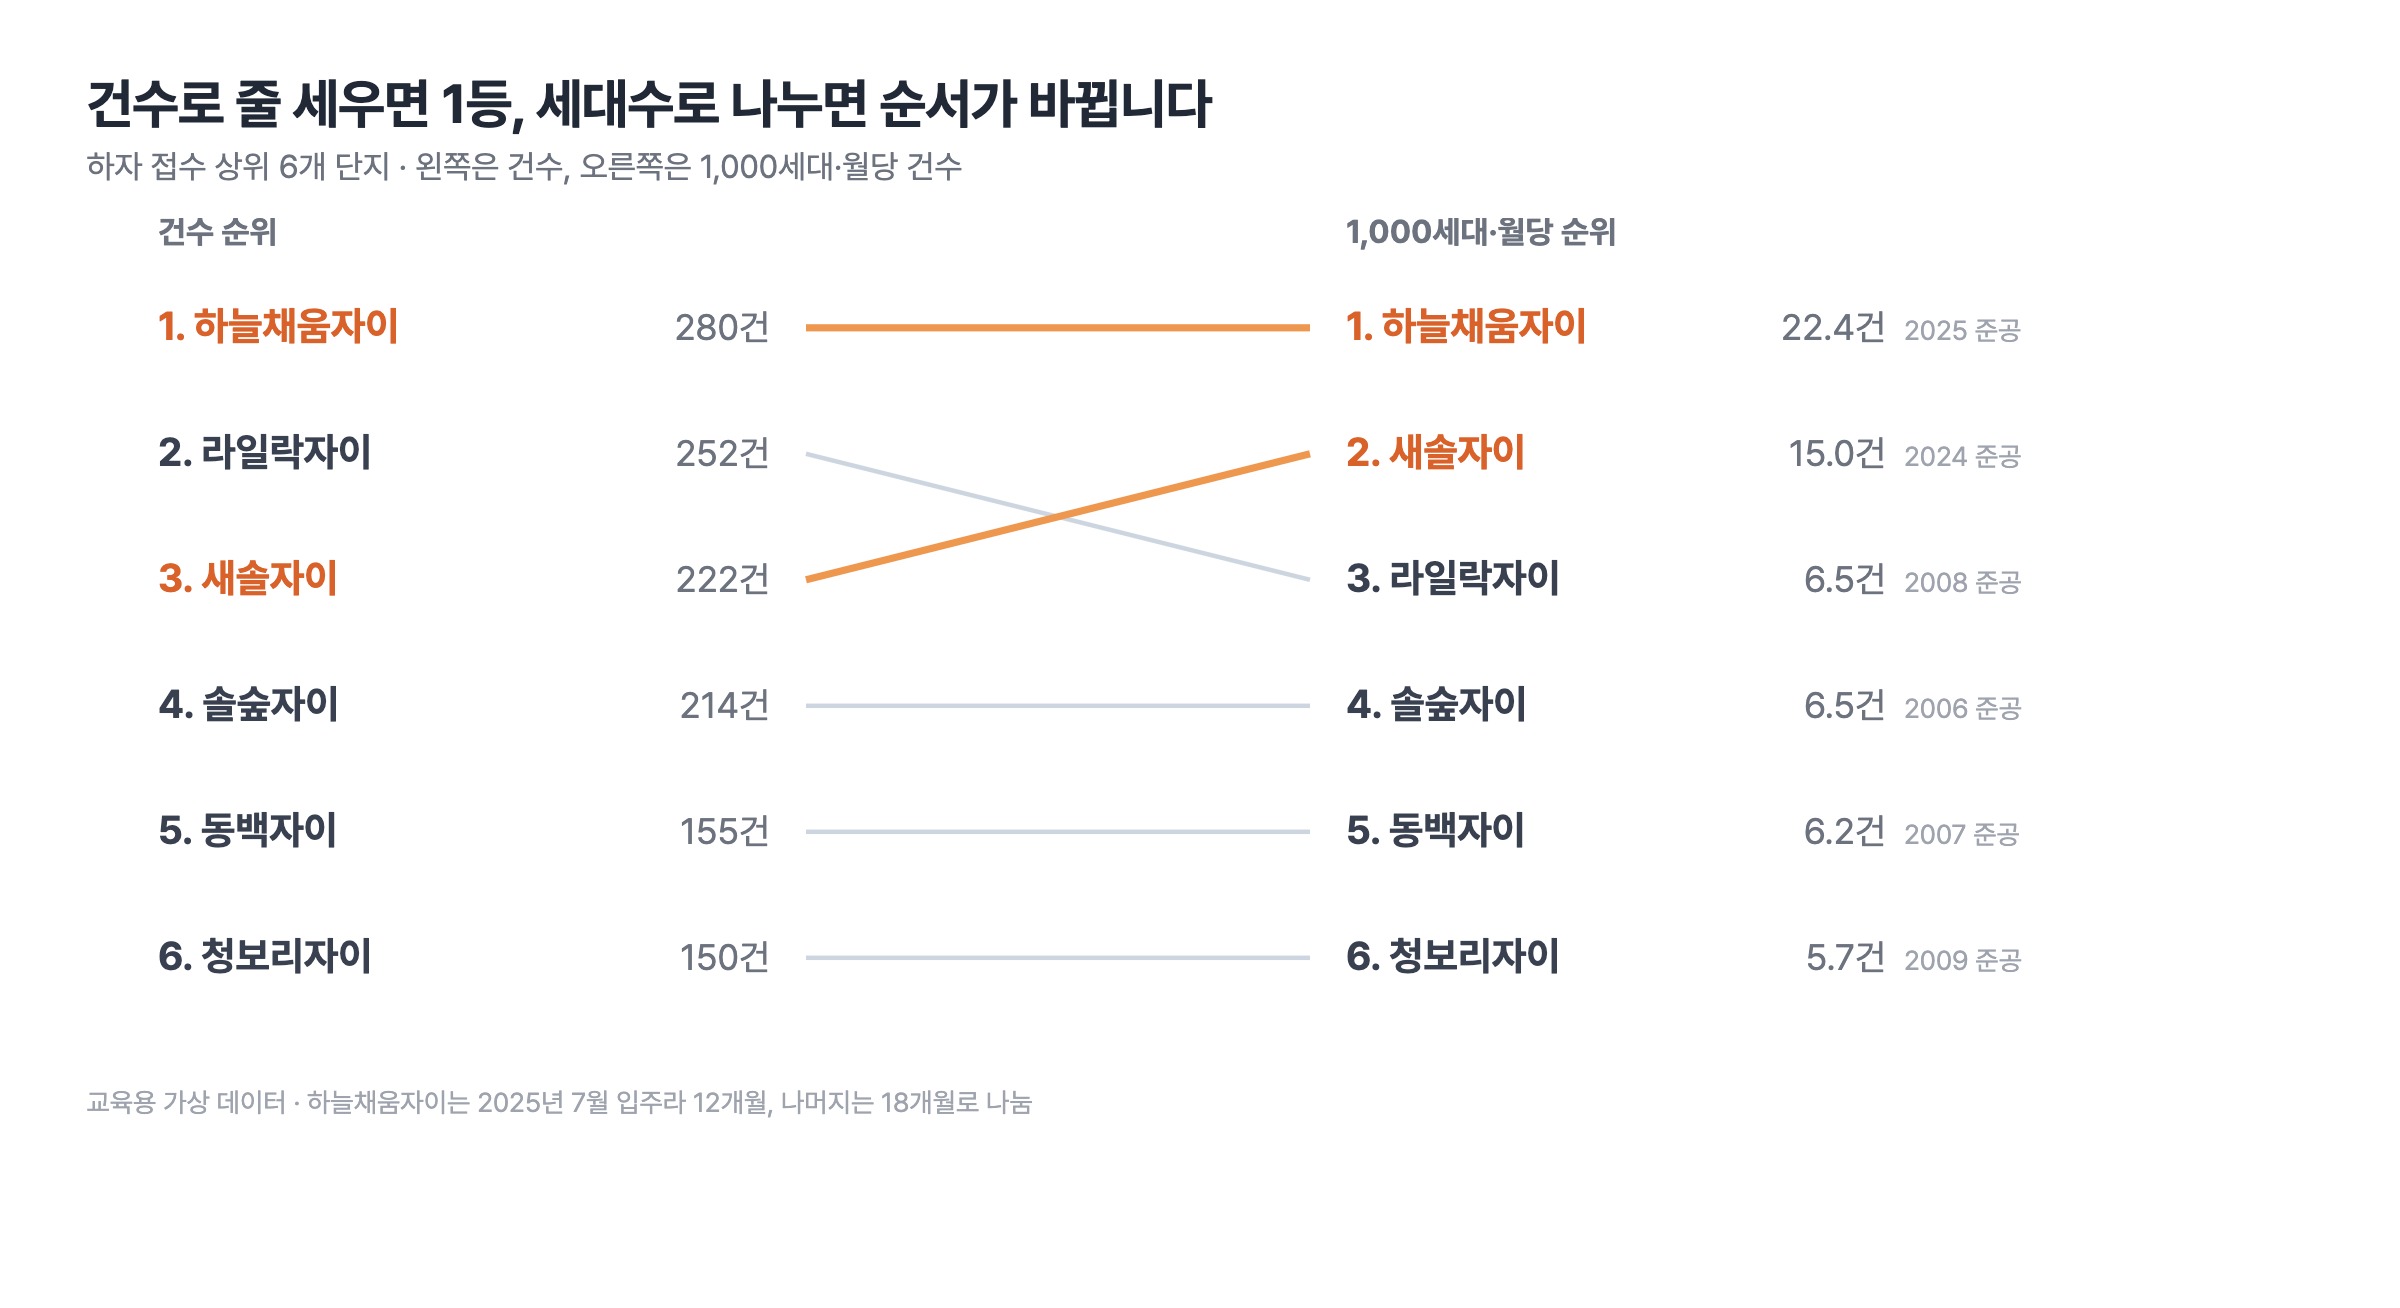
건수로는 2등이던 라일락자이(2008년 준공)가 3등으로 내려가고, 820세대짜리 새솔자이(2024년 준공)가 2등으로 올라옵니다. 1·2등이 모두 최근 2년 안에 준공한 단지라는 사실은 건수만 볼 때는 잘 보이지 않습니다.
분모에서 한 번 더 틀리기 쉽습니다
하늘채움자이는 2025년 준공 단지로, 관리비 파일에 2025년 7월부터 나옵니다. 7월에 입주가 시작됐다는 뜻입니다. 그러니 2025년 1~6월의 세대수 합계에는 하늘채움자이 1,040세대가 들어가면 안 됩니다.
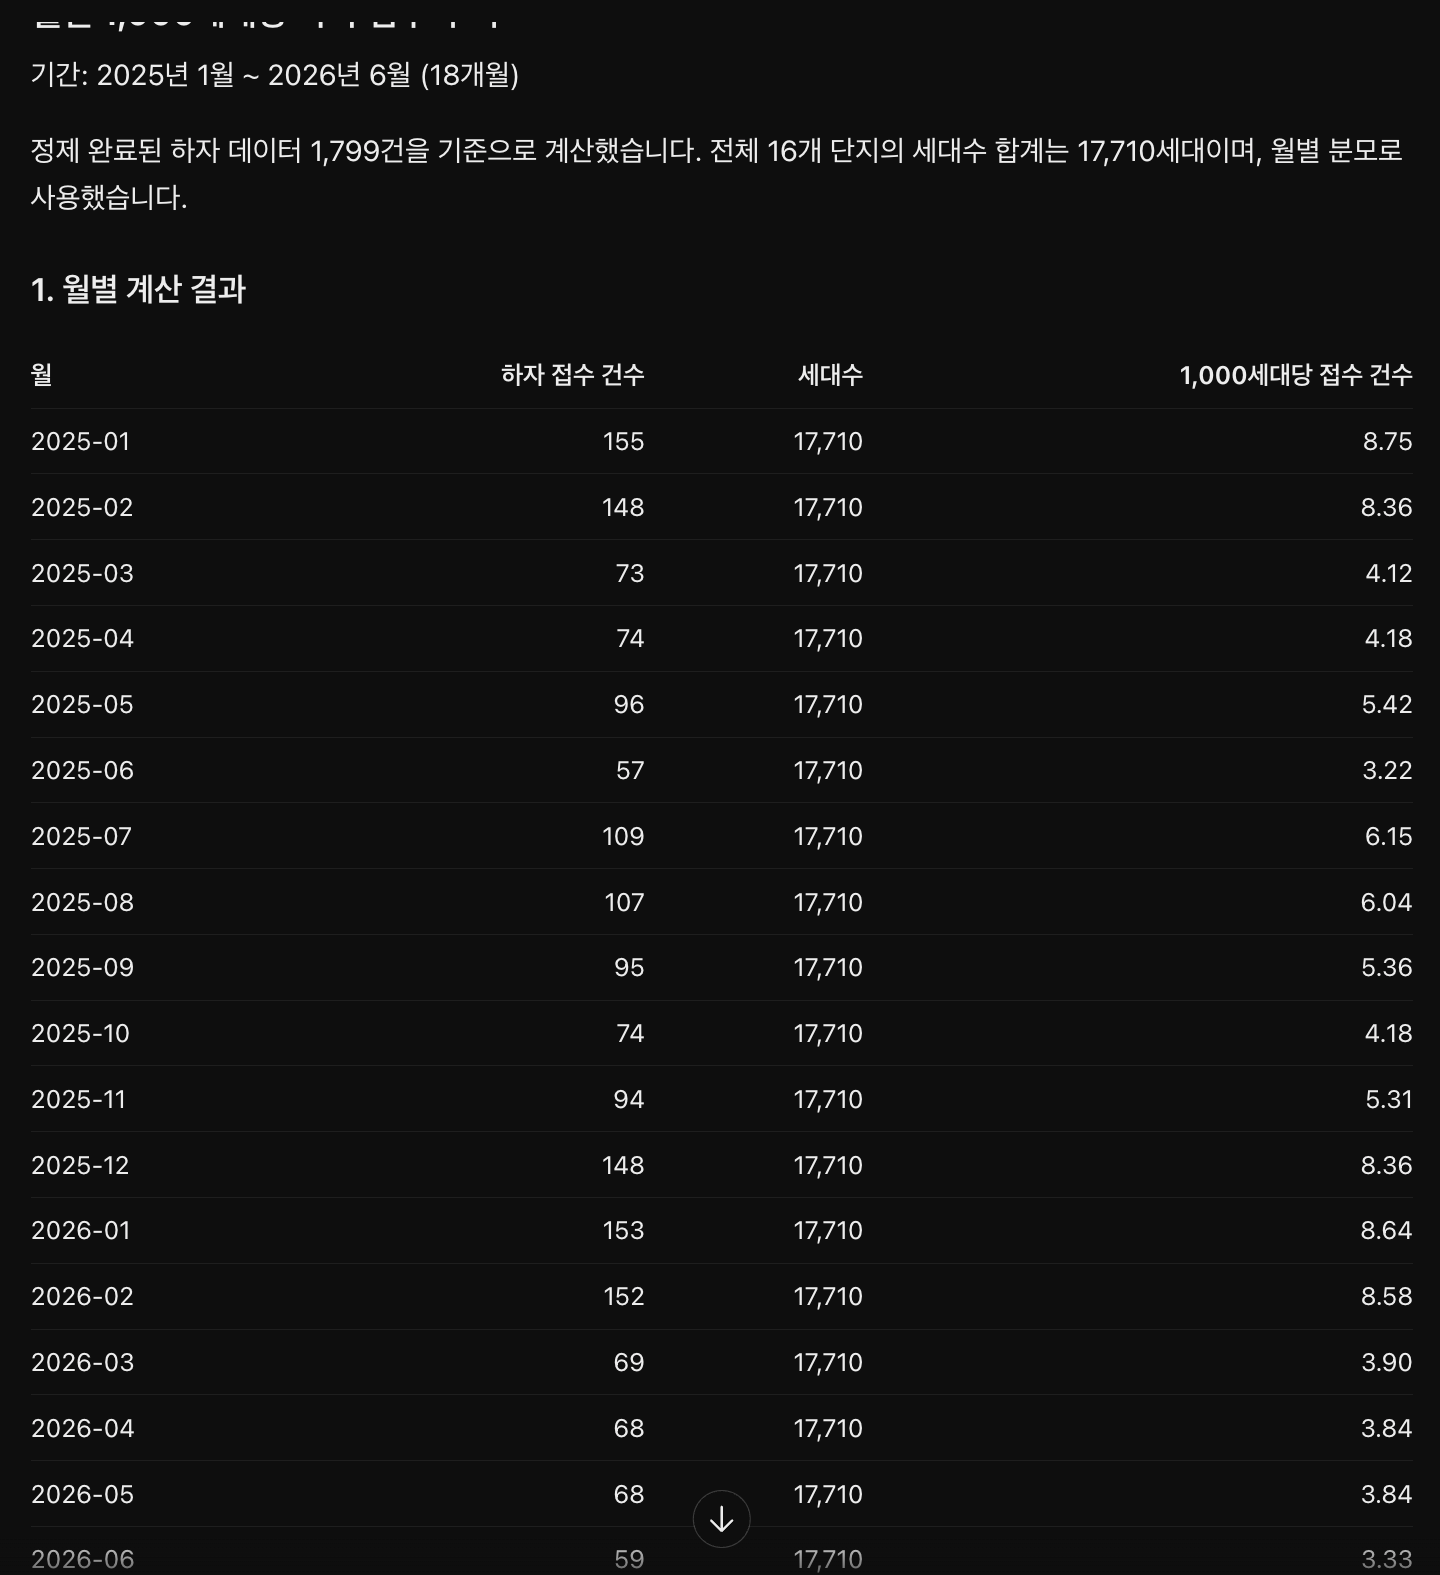
교육 준비 중 실제로 받은 답입니다. 18개월 내내 분모를 17,710세대로 고정했습니다. 2025년 1월의 올바른 분모는 하늘채움자이를 뺀 16,670세대이고, 값은 8.75가 아니라 9.30입니다.
관리비 파일에는 완전히 같은 행도 6개 있었습니다. 이걸 지우지 않고 월별 세대수를 더하면 2025년 9월이 19,850세대가 됩니다. 실제 17,710세대보다 2,140세대(라일락자이 한 단지만큼) 많습니다. 분모는 "그 달에 실제로 관리비가 나간 단지"의 세대수로, 중복을 지운 뒤에 더해야 합니다.
Step 4. 같은 달끼리 놓고 비교합니다
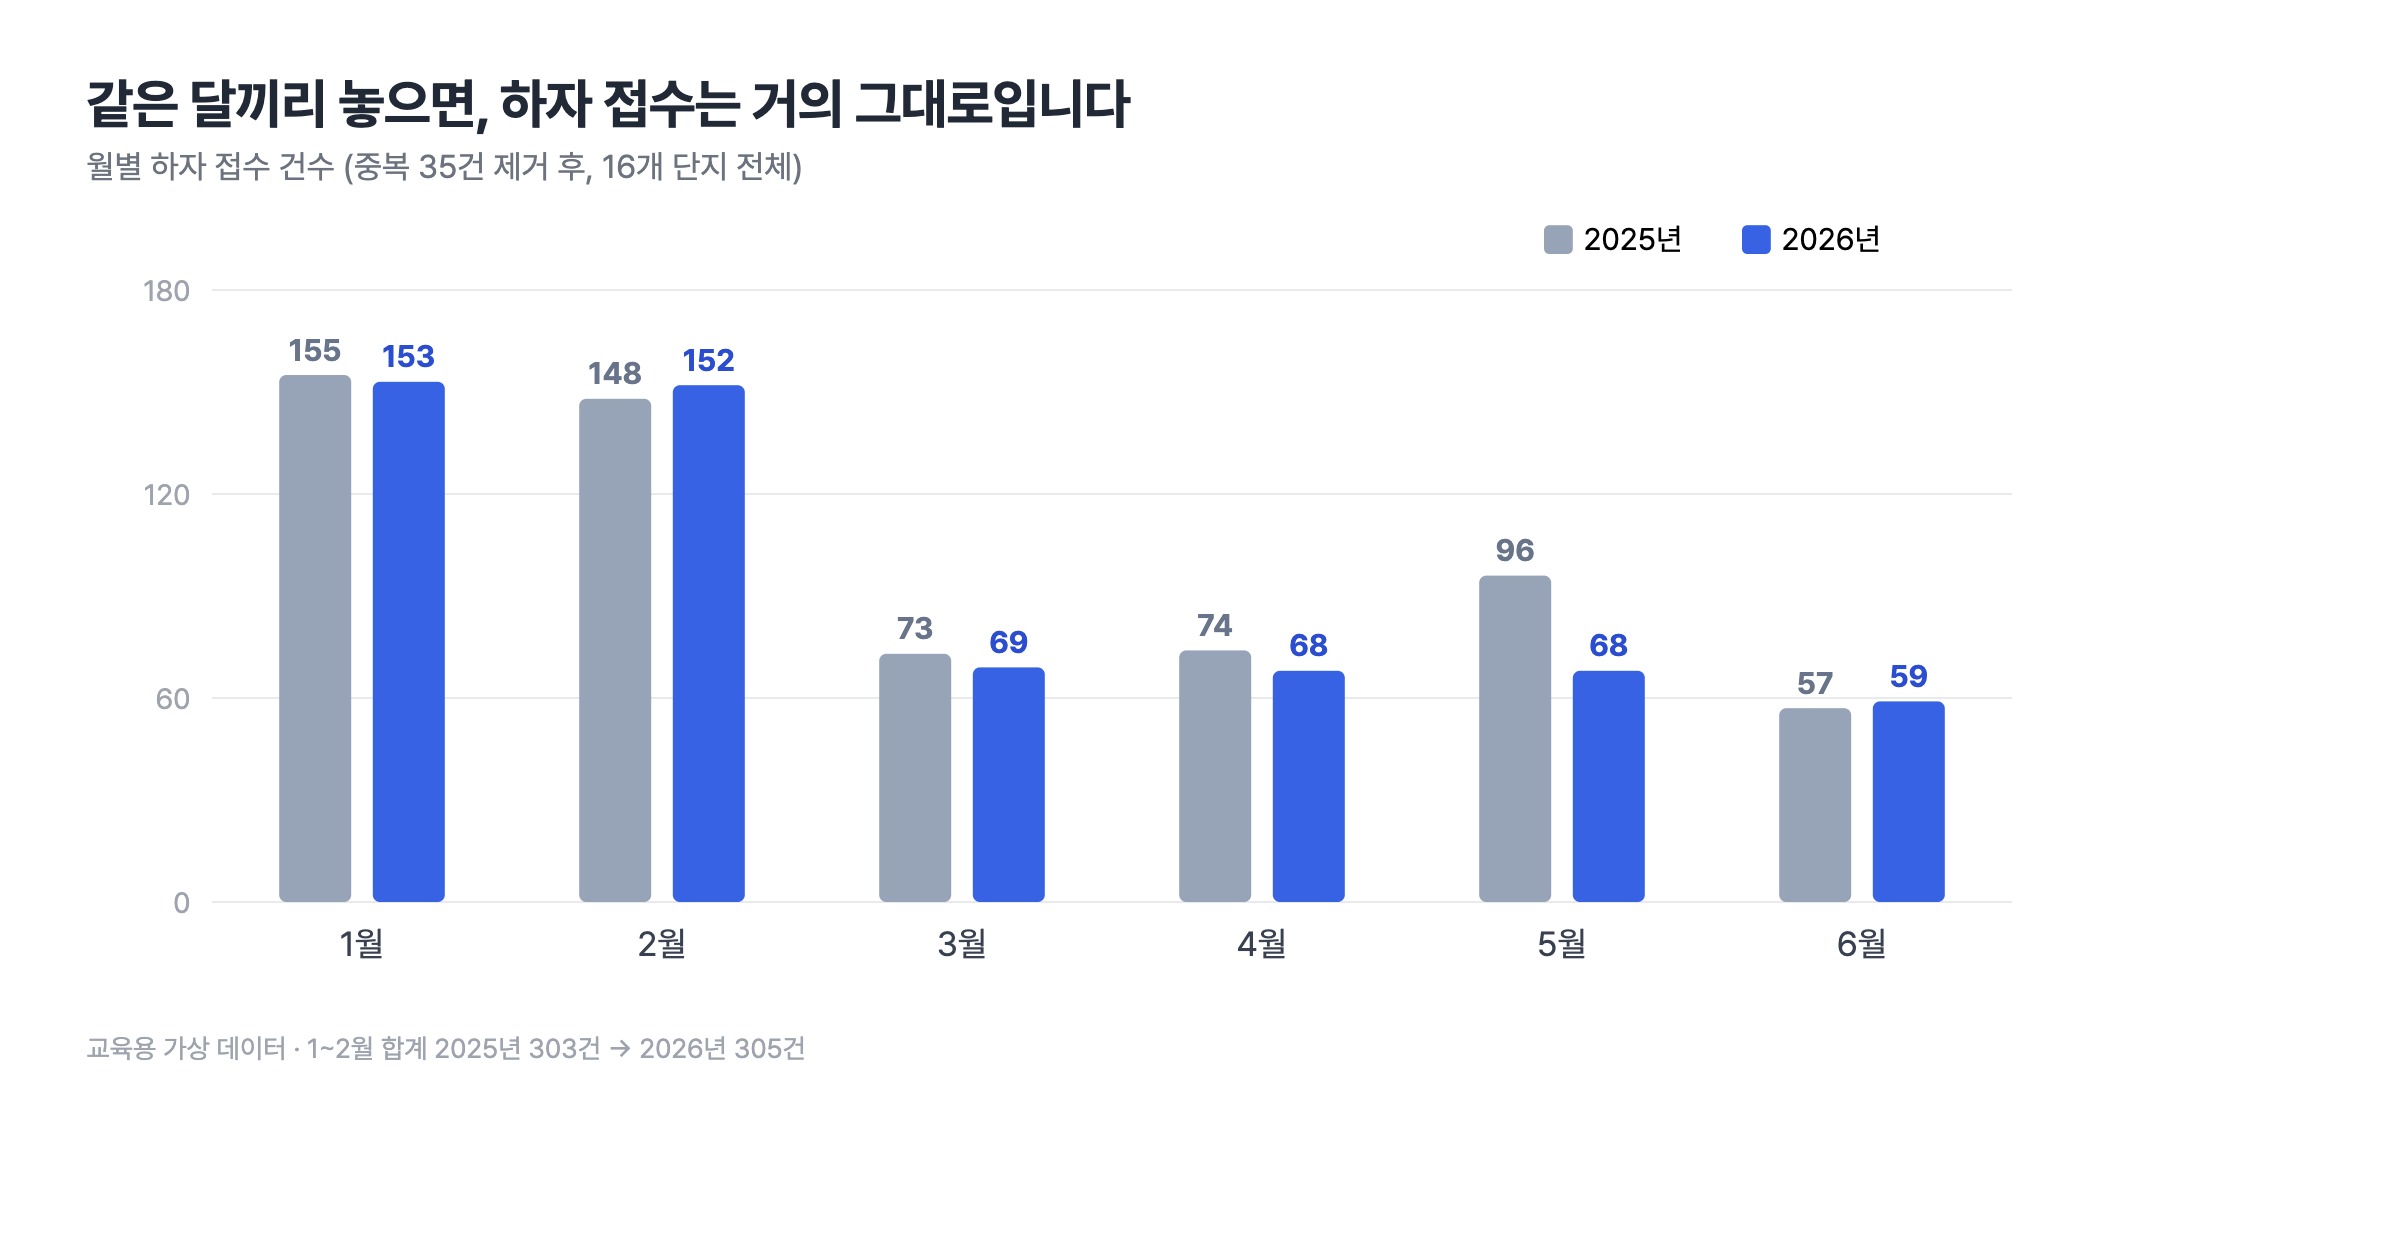
이제 처음 질문으로 돌아갑니다. 2026년 상반기를 2025년 같은 달과 나란히 놓으면 이렇습니다.
| 기간 | 2025년 | 2026년 | 차이 |
|---|---|---|---|
| 1~2월 | 303건 | 305건 | +2건 |
| 1~6월 | 603건 | 569건 | −34건 |
"요즘 늘었다"는 느낌은 겨울이 왔기 때문입니다. 10월 74건, 11월 94건이던 접수가 12월 148건, 1월 153건으로 뛰니 늘어난 것처럼 보입니다. 하지만 작년 겨울에도 똑같이 뛰었습니다. 1~6월 전체로는 오히려 34건 줄었습니다.
그래도 많은 곳은 어디인가
"늘지 않았다"와 "문제가 없다"는 다른 말입니다. 원인 후보를 두 갈래로 쪼개 보면 하자가 몰리는 곳이 분명하게 보입니다.
| 갈래 | 숫자 | 주된 하자 |
|---|---|---|
| 2010년 이전 준공 4개 단지의 겨울 | 겨울(12~2월) 결로·누수 1,000세대·월당 10.21건, 그 외 달 0.63건 | 결로, 누수. 전체 겨울 결로·누수 412건 중 84%가 이 4개 단지 |
| 2024년 이후 준공 2개 단지 | 2개 단지가 전체 1,799건 중 502건(28%) | 도배·마감 151건, 창호·문 74건, 균열 66건 |
오래된 단지는 겨울에만 결로·누수가 16배 늘고, 새 단지는 계절과 상관없이 입주 초기 마감 하자가 많습니다. 조치도 다릅니다. 앞쪽은 겨울 전 예방 점검이고, 뒤쪽은 시공 항목별 집중 점검입니다.
ChatGPT에는 원인을 바로 묻지 말고, 쪼개는 기준을 정해 줍니다.
① 나는 하자가 많은 이유를 팀장님께 두세 가지로 설명하려고 해.
② 정리가 끝난 하자 데이터(1,799건)와 관리비 파일의 준공연도를 봐.
③ 준공연도를 2010년 이전 / 2011~2023년 / 2024년 이후로 나누고, 계절을 겨울(12~2월) / 그 외로 나눠서 1,000세대·월당 하자 건수를 계산해 줘. 원인이라고 단정하지 말고 "후보"로만 적어.
④ 준공연도 3행 × 계절 2열 표로 주고, 표 아래에 가장 큰 칸 두 개의 주된 하자유형을 적어 줘.
Step 5. 다른 파일에서 진짜 늘어난 것을 찾습니다
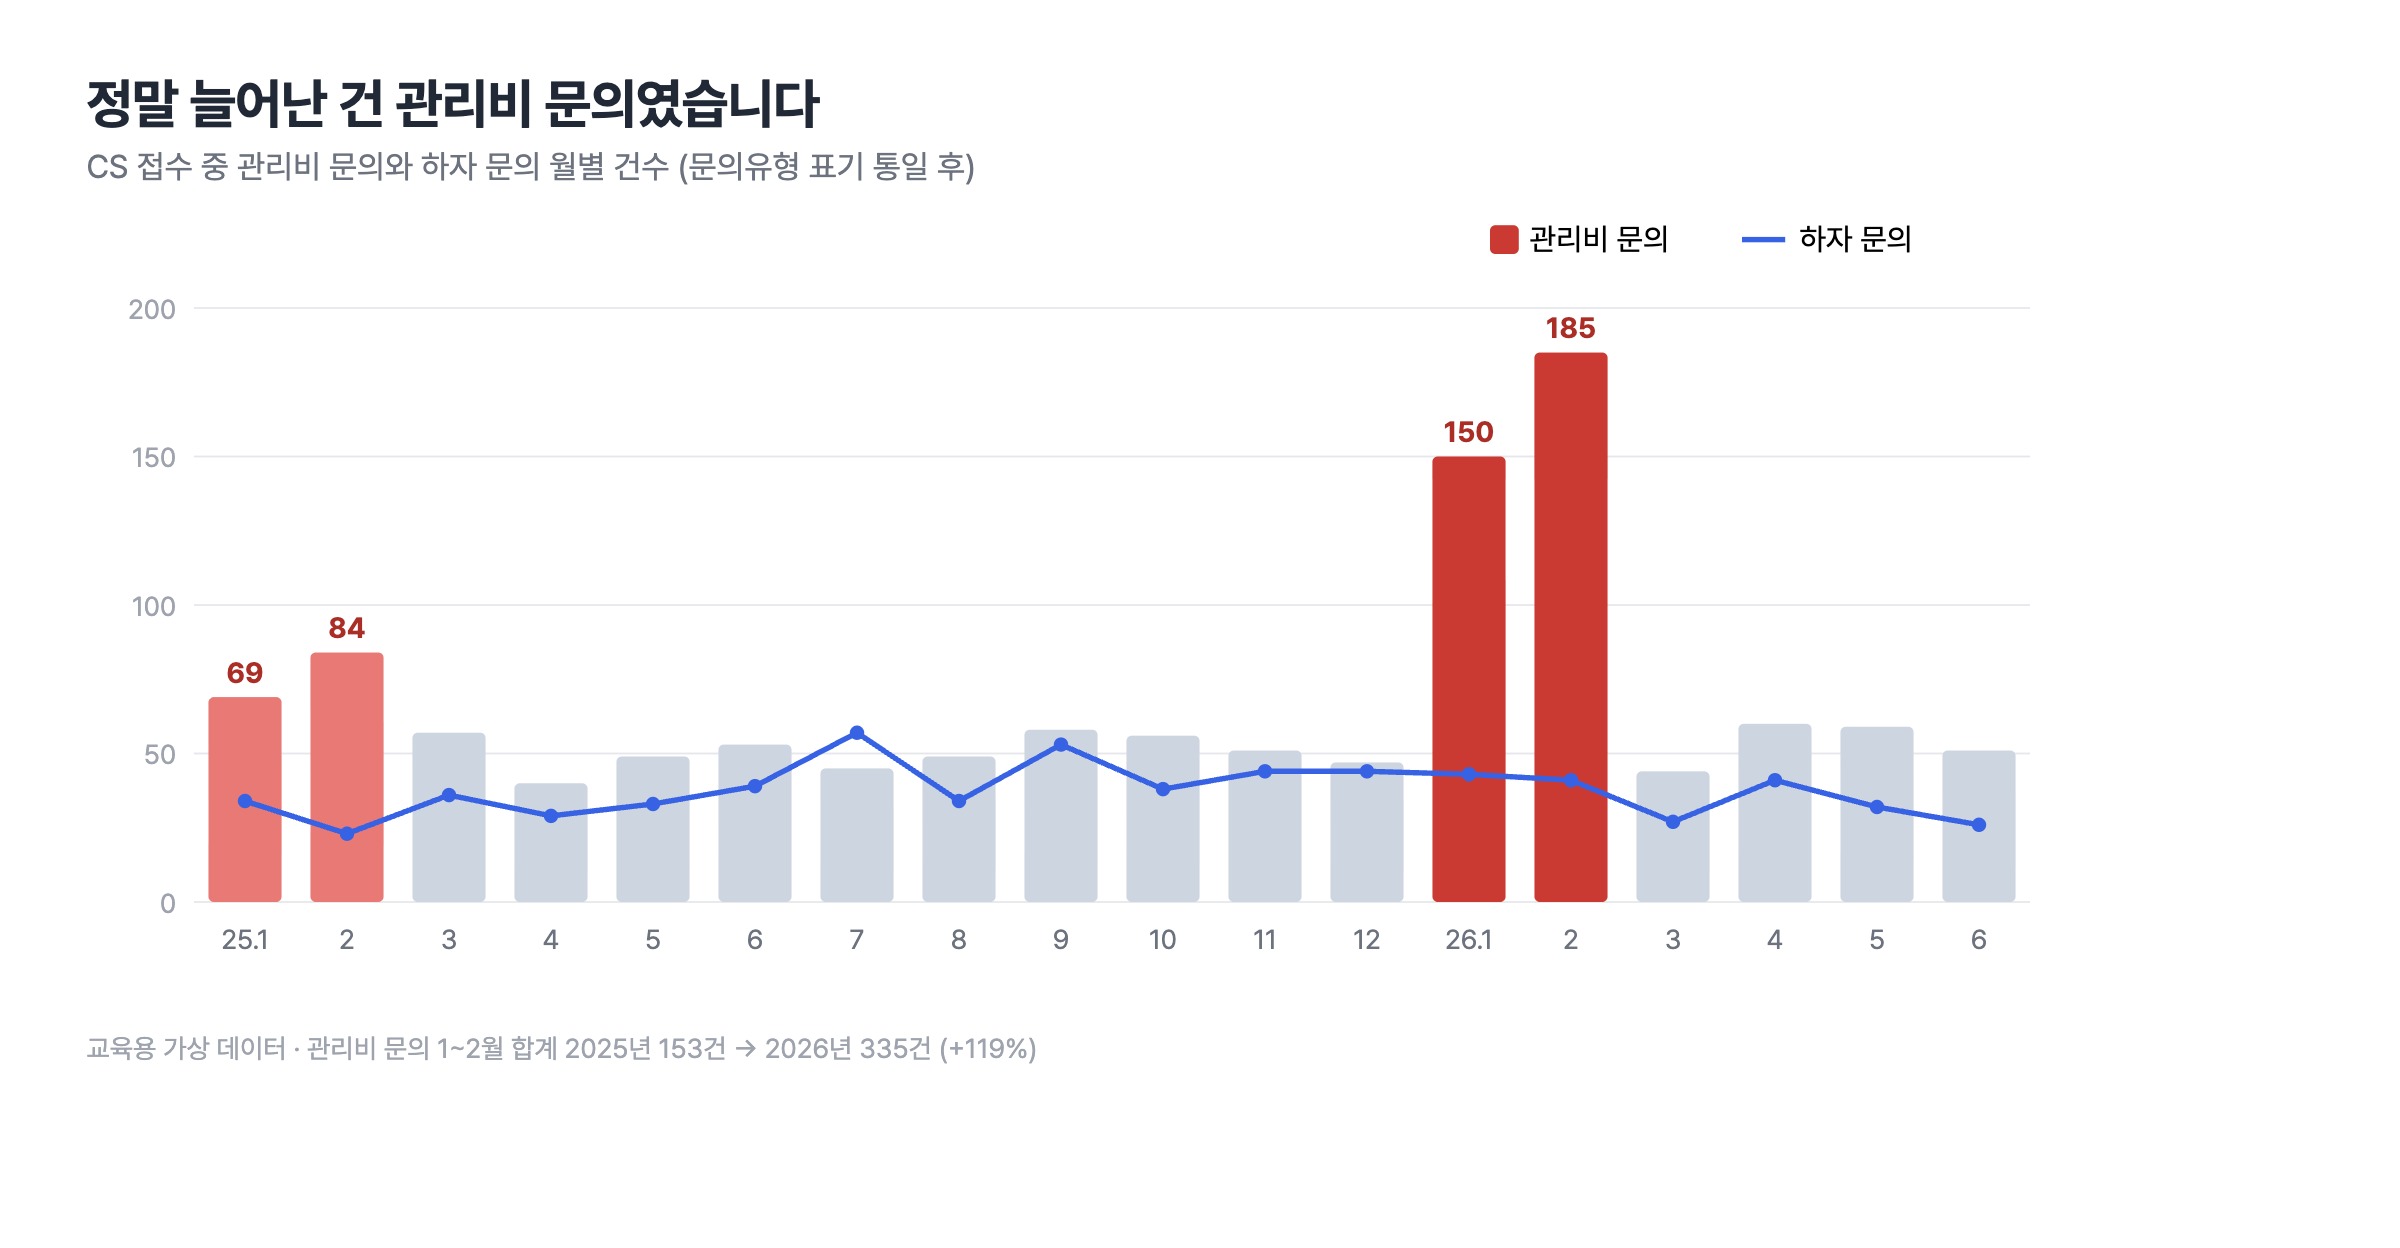
하자가 늘지 않았다면, 팀장님은 왜 "민원이 늘었다"고 느꼈을까요? 민원은 하자 파일만이 아니라 CS 파일에도 쌓입니다. CS 문의유형을 7종으로 정리한 뒤 같은 방식으로 작년 같은 달과 비교했습니다.
| CS 문의 (1~2월 합계) | 2025년 | 2026년 | 변화 |
|---|---|---|---|
| 관리비 | 153건 | 335건 | +119% |
| 하자 | 57건 | 84건 | +27건 |
관리비 문의 안을 내용별로 열어 보면, 늘어난 폭이 고르지 않습니다.
| 관리비 문의 내용 (1~2월) | 2025년 | 2026년 |
|---|---|---|
| 장기수선충당금 문의 | 33건 | 91건 |
| 관리비 고지서 항목 문의 | 27건 | 74건 |
| 관리비 자동이체 변경 | 39건 | 82건 |
| 난방비가 지난달보다 많이 나왔어요 | 54건 | 88건 |
같은 15개 단지(2025년 1월에도 있던 단지)만 놓고 1월 세대 평균 관리비를 비교하면 324,374원에서 354,121원으로 9.2% 올랐습니다. 다만 관리비가 9% 오른 것만으로 문의가 두 배 넘게 늘어난 것을 다 설명하기는 어렵습니다. 장기수선충당금과 고지서 항목 문의가 각각 2.8배 늘어난 점을 보면, 고지서 구성이나 충당금 부과 기준이 바뀌었는지를 먼저 확인해 볼 만합니다. 이건 데이터 밖의 사실이라 담당 부서에 물어봐야 합니다.
CS 파일에는 하루짜리 이상값도 하나 있습니다. 2025년 8월 14일 바다숲자이 한 단지에서 73건이 들어왔고, 그중 72건이 "엘리베이터 운행 중단 관련 문의"였습니다. 이런 날은 월별 합계를 크게 흔들기 때문에, 추이를 볼 때는 따로 표시해 둬야 합니다.
Step 6. 한 장으로 정리하고, 숫자를 검산합니다
마지막으로 ChatGPT에 지금까지의 결과를 한 장 대시보드로 묶어 달라고 했습니다.
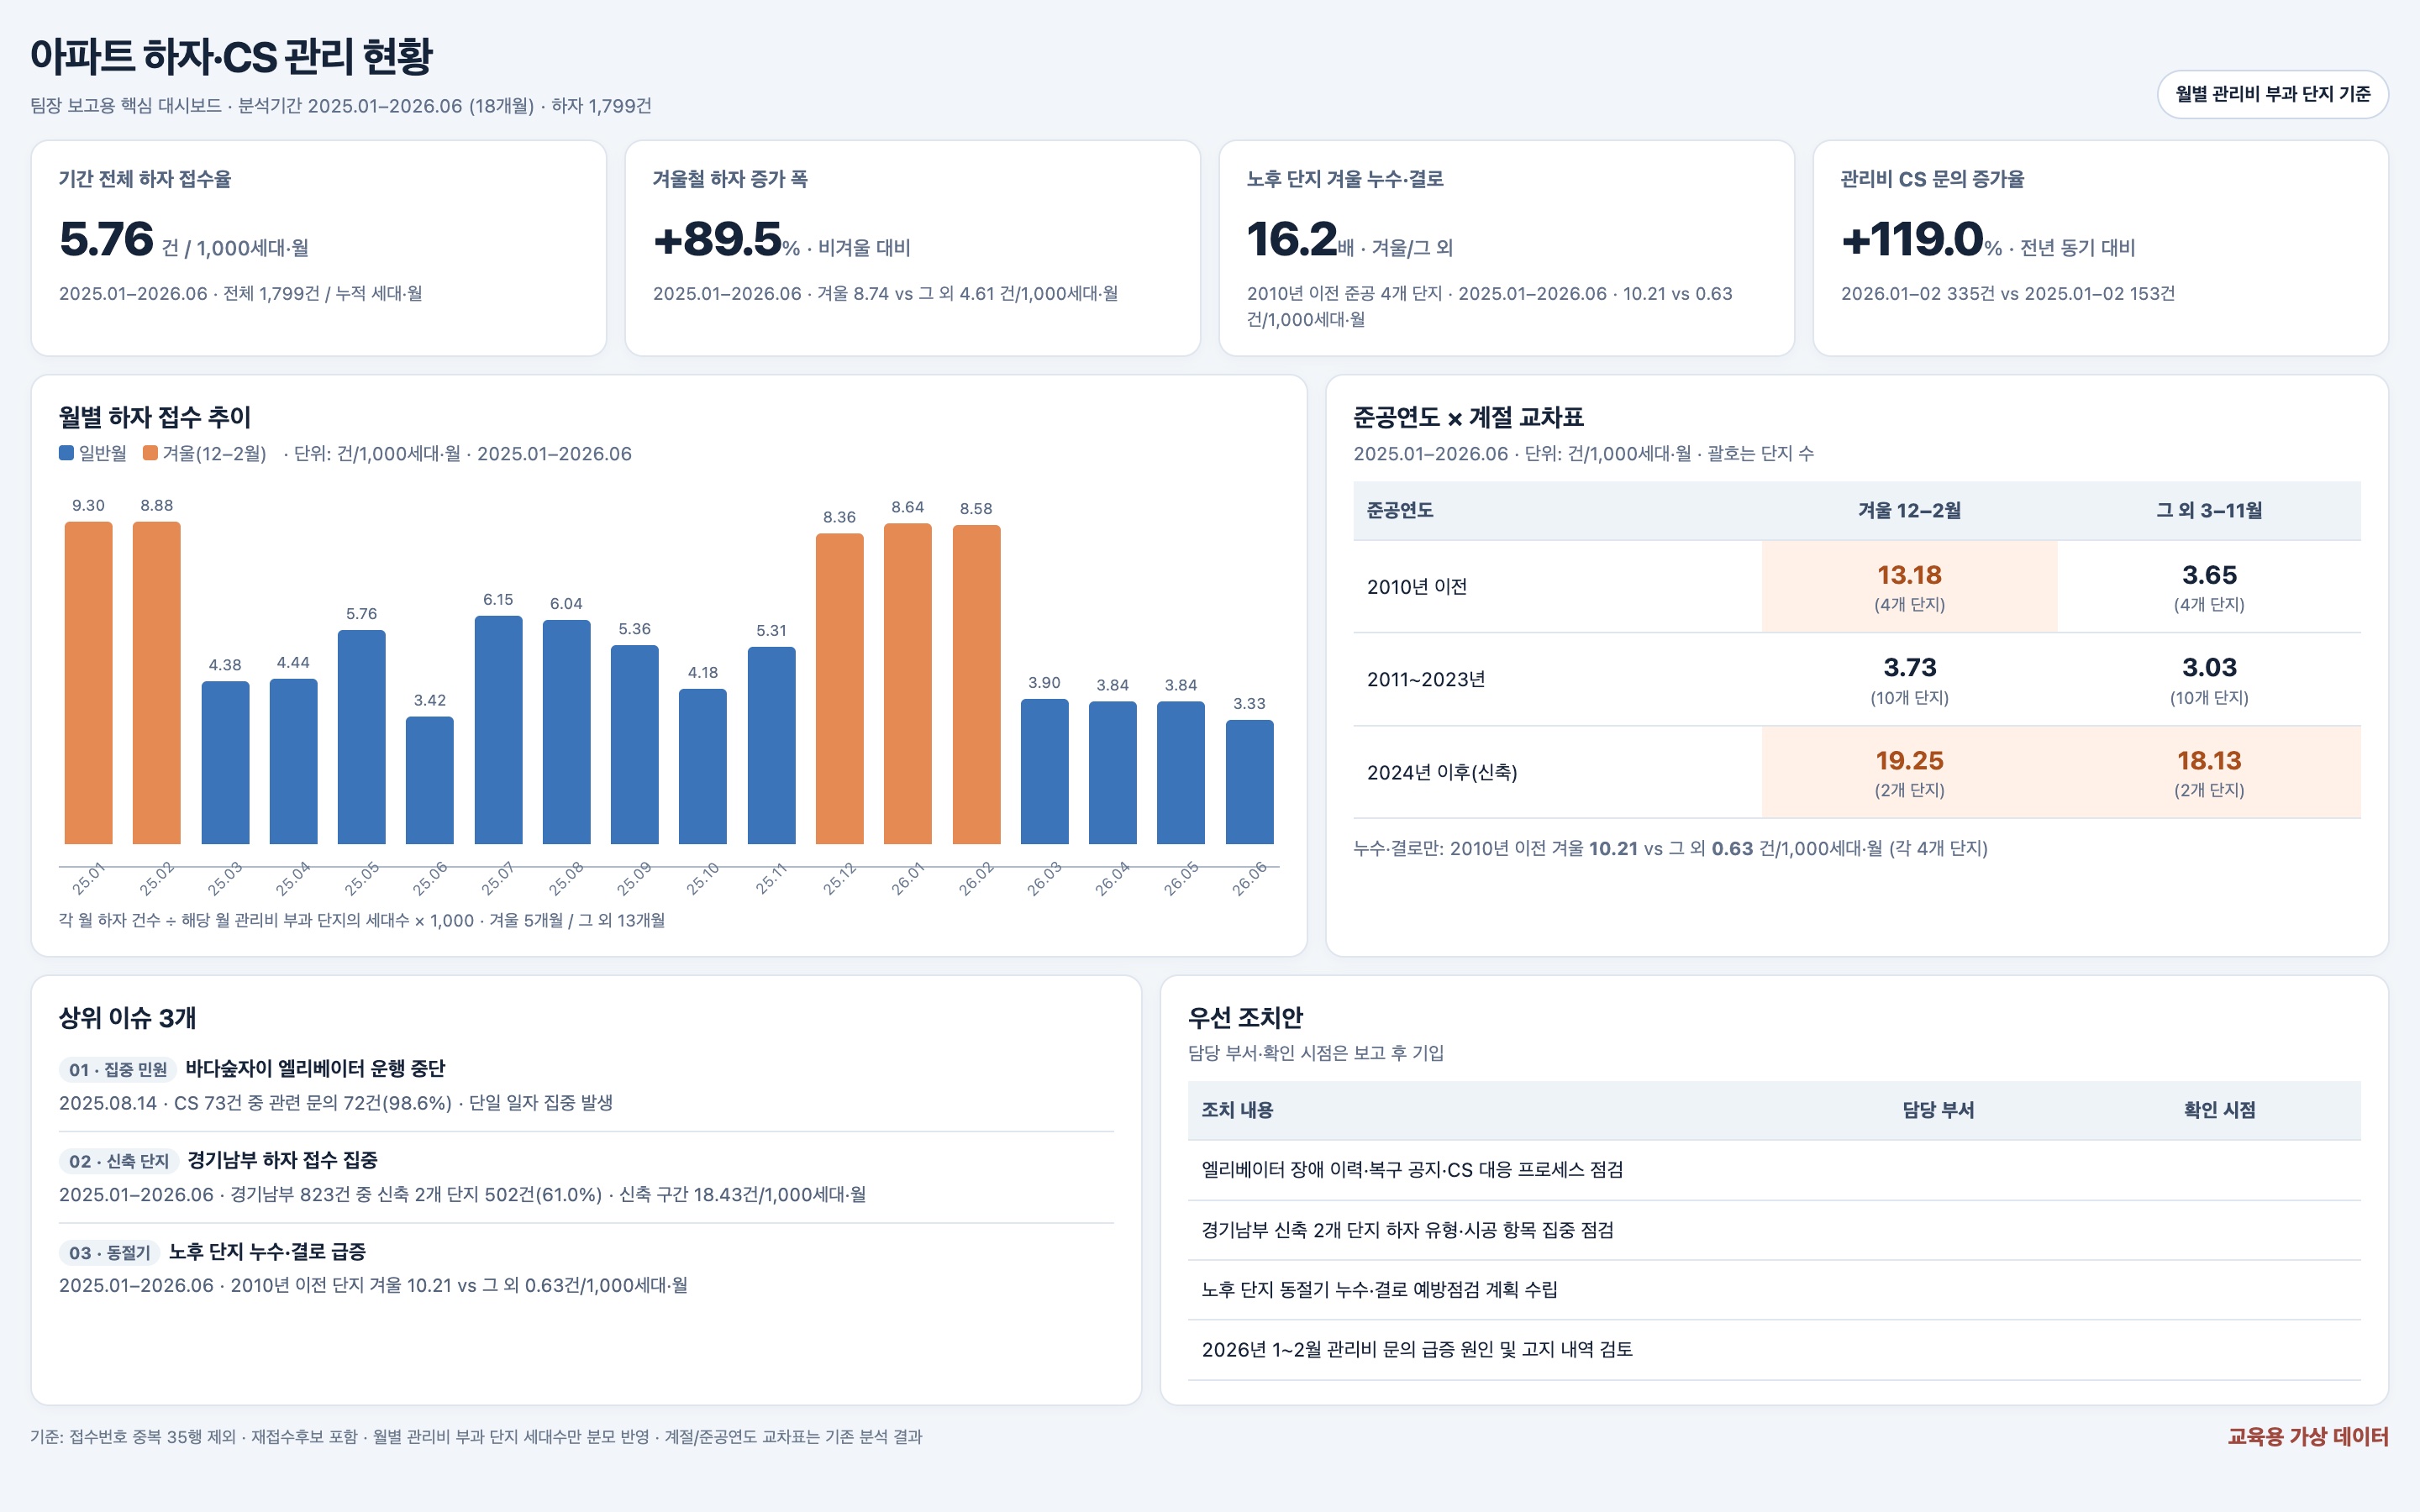
실습 파일 3개를 ChatGPT에 올려 이 글과 같은 흐름으로 진행한 뒤 받은 결과입니다. 2025년 1월 값이 Step 3에서 고친 9.30으로 들어가 있습니다.
보고서로 내보내기 전에 아래 다섯 가지만 확인합니다. ChatGPT가 낸 숫자든 내가 엑셀로 낸 숫자든 똑같이 적용됩니다.
| 확인할 것 | 어떻게 | 이 데이터의 정답 |
|---|---|---|
| 행 수가 원본과 맞는가 | 정리 전후 행 수를 같이 달라고 한다. 줄었다면 무엇을 왜 지웠는지 묻는다 | 1,834행 → 1,799건 (중복 35) |
| 고유값 개수가 맞는가 | 단지 이름·코드의 고유값 개수를 묻는다. 관리비 파일의 단지 수와 같아야 한다 | 16개 |
| 분모가 맞는가 | 월별 세대수 합계를 표로 달라고 한다. 입주 전 단지·중복 행이 들어갔는지 본다 | 2025년 1~6월 16,670 / 7월부터 17,710 |
| 한 단지를 손으로 세어 봤는가 | 엑셀 필터로 한 단지만 걸러 행 수를 직접 센다. 표기가 여러 개면 모두 걸어야 한다 | 하늘채움자이 280건 |
| 비교 기준이 맞는가 | "지난달 대비"인지 "작년 같은 달 대비"인지 표 제목에 쓰게 한다 | 작년 같은 달 |
이 중 하나라도 어긋나면 처음부터 다시 시킬 필요는 없습니다. 어긋난 칸 하나만 짚어서 "2025년 1~6월 분모에서 하늘채움자이를 빼고 다시 계산해 줘"처럼 고쳐 달라고 하면 됩니다.
자주 막히는 곳
| 증상 | 원인 | 해결 |
|---|---|---|
| 단지별 순위가 할 때마다 다르다 | 단지명 표기를 통일하지 않고 셌다 | Step 2의 대응표를 먼저 만들고, 대응표로 바꾼 뒤 세게 한다 |
| 중복이 9건이라고 나온다 | "모든 칸이 같은 행"만 중복으로 봤다 | 접수번호 기준으로 다시 찾게 하고, 두 행을 나란히 보여 달라고 한다 |
| 월별 1,000세대당 값이 대시보드마다 다르다 | 분모를 18개월 내내 같은 값으로 넣었거나, 관리비 파일의 중복 행을 더했다 | 월별 세대수 합계 표를 따로 받아 확인한다 |
| "겨울에 하자가 급증했다"는 결론이 나온다 | 겨울을 가을과 비교했다 | 작년 같은 달과 비교하게 한다 |
| 만족도 평균이 이상하게 높거나 낮다 | 만족도 칸의 53%(5,232건 중 2,758건)가 비어 있다 | 평균을 낼 때 응답 건수를 함께 쓰게 하고, 빈칸을 0으로 넣지 않게 한다 |
| ChatGPT가 원인을 단정한다 | 원인을 묻는 질문에 "후보"라는 조건이 없었다 | "원인이라고 단정하지 말고 후보로만" 문구를 ③번 칸에 넣는다 |
실습 데이터
이 글에서 쓴 파일 3개(엑셀·CSV)를 그대로 받을 수 있습니다. 아파트 관리 업무를 본떠 만든 교육용 가상 데이터이며, 실제 단지나 회사의 데이터가 아닙니다. 날짜 형식, 단지명 표기, 중복 접수 같은 지저분한 부분은 실무 파일과 비슷하도록 일부러 넣었습니다.
실습 데이터 내려받기 (ZIP, 엑셀 3개 + CSV 4개)
실무 데이터를 ChatGPT에 올릴 때는 사내 보안 규정을 먼저 확인하세요. 동·호수, 이름, 연락처처럼 사람을 알아볼 수 있는 열은 지우거나 가린 다음 올리는 것이 기본입니다.