같은 고객 데이터로 이탈률이 61%도, 17%도 나옵니다: 『고객 리텐션의 전략』 따라 해 본 서평
이 글과 연결된 글 보기
드래그로 이동 · 휠/두 손가락으로 확대 · 방향키로 글 선택 · 0으로 맞춤. 실선: 본문 링크, 점선: 시리즈·주제의 대표 연결.표시된 글 20편 목록
같은 온라인몰 거래 데이터인데, “며칠 동안 안 사면 이탈인가”만 바꾸자 월 이탈률이 61%, 27%, 17%로 달라졌습니다. 칼 골드(Carl Gold)의 『고객 리텐션의 전략』은 이 정의 문제부터 SQL로 풀고, 고객 행동을 메트릭으로 만들어 코호트별 이탈률을 비교하는 방법을 가르치는 책입니다. 책의 순서대로 공개 데이터를 따라 해 보니 최근 90일 주문이 1~2회인 고객은 다음 90일에 50.2%가 떠났고, 4회를 넘긴 고객은 6.1%만 떠났습니다. 이 글은 책의 구성과 읽는 순서, 직접 돌려 본 결과, 그리고 따라 할 때 막히는 지점을 정리한 서평입니다.
이 책은 어떤 책인가요
원서는 2020년 11월 Manning에서 나온 『Fighting Churn with Data』입니다. 저자 칼 골드는 구독 관리 플랫폼 주오라(Zuora)의 최고 데이터 과학자로 일하며 구독자 분석 제품의 예측 시스템을 만든 사람입니다. 책은 데이터 분석가, 데이터 과학자, 머신러닝 엔지니어를 주 독자로 잡고 Python과 SQL 기초를 전제로 합니다.
최근 데이터 분석 수업에서 리텐션을 설명하며 이 책을 추천했는데, 한국어판을 찾는 분이라면 판이 두 개라는 점을 먼저 알아 두시면 좋습니다.
| 구분 | 2022년 번역본 | 2025년 재번역판 |
|---|---|---|
| 제목 | 고객 리텐션의 전략 | 데이터 기반 리텐션 전략 |
| 옮긴이 | 정현지 | 장훈 |
| 출간 | 2022-06-30, 636쪽 | 2025-07-21, 572쪽 |
| 정가 | 40,000원 | 42,000원 |
| 지금 구하는 법 | 알라딘 기준 품절(출판사 유통 중단), 중고만 | 교보·예스24·알라딘에서 판매 |
두 판 모두 에이콘출판의 데이터 과학 시리즈이고 원서는 같습니다. 2022년판은 알라딘에서 2022년 8월부터 품절로 표시되어 있어서(2026년 11월 22일 확인), 새 책으로 사려면 2025년판을 고르면 됩니다. 이 글의 장·절 번호는 목차가 공개된 2025년판 기준입니다.
책은 “예측”보다 “측정”에 더 많은 쪽을 씁니다
이탈 분석 책이라고 하면 머신러닝 예측 모델을 먼저 떠올리기 쉽습니다. 이 책은 순서가 반대입니다. 1부에서 이탈을 정의하고 측정하는 데 네 장을 쓰고, 2부에서 고객 행동과 이탈의 관계를 코호트로 읽는 법을 세 장에 걸쳐 다룬 뒤에야 3부에서 회귀와 머신러닝을 꺼냅니다. 출판사 소개에도 “예측은 좋은 메트릭을 확보하는 것보다는 덜 중요하지만 유용할 수 있다”고 적혀 있습니다.
저자는 대부분의 독자에게 1부와 2부를 처음부터 읽고, 예측이나 유사 고객 찾기가 필요할 때 3부로 넘어가라고 권합니다. 출판사 소개도 8장과 9장은 해당 주제 경험이 없으면 난이도가 높을 수 있다고 밝힙니다.
구독 서비스 책처럼 보이지만 비구독 사업도 계속 함께 다룹니다. 1장에서 저자는 구독 관련 기법을 많이 가르치되 “모든 경우에 같은 개념이 리테일과 비구독 상황에 어떻게 적용되는지 보여 준다”고 씁니다. 2.5절 “비구독 제품의 활동(이벤트 기반) 이탈”, 4.4절 “비구독 제품의 활성 기간 확인”이 그 예입니다. 저도 구독 데이터가 아닌 온라인몰 거래 데이터로 따라 해 봤습니다.
따라 한 데이터: 영국 온라인몰 2년치 거래
데이터는 UCI 저장소의 Online Retail II입니다. 영국의 선물용품 온라인몰이 2009년 12월 1일부터 2011년 12월 9일까지 기록한 거래 내역입니다. 중복 행, 고객 ID가 없는 행, 취소 송장(C로 시작), 수량·가격이 0 이하인 행을 빼면 고객 5,878명, 주문(송장) 36,969건이 남습니다.
책의 실습 코드는 저자가 GitHub에 MIT 라이선스로 공개했고, PostgreSQL에 시뮬레이션 데이터를 넣어 돌리는 구조입니다. 이번에는 PostgreSQL을 띄우지 않고, 책의 SQL과 Python 코드에 담긴 계산 규칙을 pandas로 옮겨 돌렸습니다.
실험 1: 이탈 정의만 바꿔도 월 이탈률이 61%에서 17%로 내려갑니다
구독 서비스는 해지일이 기록되지만 온라인몰에는 “해지”가 없습니다. 책의 활동 이탈 SQL(목록 2.3)은 이 문제를 비활성 기간으로 풉니다. 측정 시작일 직전 N일 안에 활동한 고객을 시작 고객으로 세고, 그중 측정 종료일 직전 N일 안에 활동이 없는 고객을 이탈로 셉니다.
import pandas as pd

def active(inv, day, window):
    """day 직전 window일 안에 주문한 고객 집합"""
    m = (inv.t > day - pd.Timedelta(days=window)) & (inv.t <= day)
    return set(inv.loc[m, 'Customer ID'])

def activity_churn(inv, start, window):
    end = start + pd.DateOffset(months=1)
    s, e = active(inv, start, window), active(inv, end, window)
    return len(s - e) / len(s)   # 시작 고객 중 종료 시점에 비활성인 비율
N을 30일, 60일, 90일로 바꿔 2010년 3월부터 2011년 11월까지 21개월의 월 이탈률을 계산했습니다.
| 비활성 기간 N | 시작 고객 수(월평균) | 월 이탈률 평균 | 범위 |
|---|---|---|---|
| 30일 | 1,021명 | 61.2% | 54.4~68.9% |
| 60일 | 1,631명 | 27.0% | 19.8~51.4% |
| 90일 | 2,073명 | 16.7% | 9.3~35.5% |
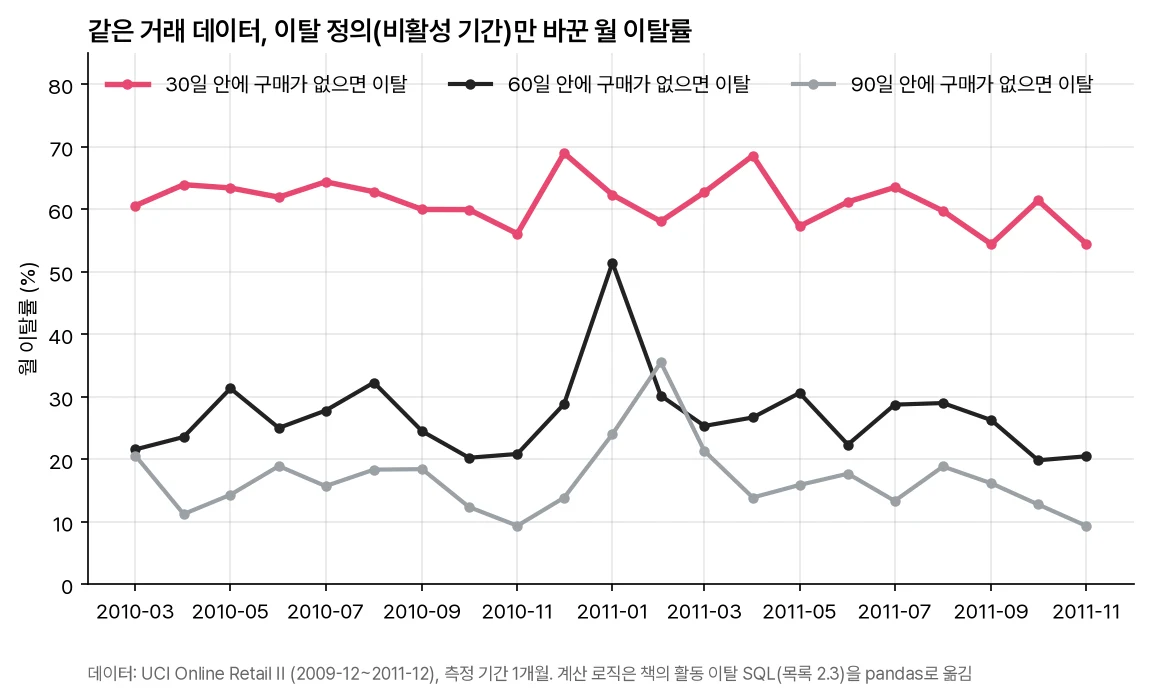
세 숫자 모두 같은 데이터에서 계산했고 틀린 값도 없습니다. 이 온라인몰에서 같은 고객의 주문 간격은 중앙값이 24일이고, 간격의 44%가 30일을 넘습니다. 30일 기준이면 한 달 남짓 쉬었다가 다시 오는 단골까지 이탈로 잡힙니다. 이탈률을 보고받으면 숫자보다 “며칠 무활동을 이탈로 봤는지”를 먼저 물어야 합니다.
정의가 정해져도 달마다 흔들립니다. 60일 기준 2011년 1월의 이탈률은 51.4%로 다른 달의 두 배 가까이 됩니다. 이 달의 시작 고객(직전 60일인 11~12월 주문 고객)은 1,951명으로 평소보다 많았습니다. 월 주문 수가 2010년 11월 2,587건으로 2년 중 가장 많았다가 12월 1,400건, 2011년 1월 987건으로 줄었고, 12월 24일부터 1월 3일까지는 주문이 한 건도 없습니다. 연말 선물 시즌에만 주문한 고객이 시작 고객에 대거 들어왔다가 다음 달에 이어지지 않은 것으로 보입니다. 책도 2.7.5절 “계절성과 이탈률”을 따로 둡니다. 한 달치 이탈률로 추세를 말하면 안 되는 이유입니다.
실험 2: 메트릭 코호트로 보면 “누가 떠나는지”가 보입니다
이탈률은 결과일 뿐이라 어떤 고객이 떠나는지는 알려 주지 않습니다. 책의 핵심 기법인 5장의 메트릭 코호트 분석은 고객 행동을 숫자(메트릭)로 만들고, 그 값으로 고객을 줄 세워 몇 묶음(코호트)으로 나눈 뒤 묶음마다 이탈률을 비교합니다.
먼저 4장 방식으로 분석용 데이터셋을 만들었습니다. 2010년 3월 1일부터 2011년 9월 1일까지 매월 1일을 관찰일로 정하고, 관찰일 직전 90일 안에 주문한 고객마다 한 줄을 만듭니다. 메트릭은 그 90일 동안의 주문 수, 구매 금액, 주문당 평균 금액, 마지막 주문 이후 일수, 첫 주문 이후 일수(가입 기간)입니다. 정답(이탈 여부)은 관찰일 다음 90일 동안 주문이 없으면 이탈로 표시했습니다. 한 고객이 여러 달에 걸쳐 관찰되므로 결과는 고객 5,249명에 대한 관찰 38,926건이고, 전체 이탈률은 43.1%입니다.
코호트를 나누는 코드는 책의 목록 5.1(cohort_plot)과 같은 방식입니다.
def cohort_table(df, metric, n=10):
    groups = pd.qcut(df[metric], n, duplicates='drop')   # 메트릭 값으로 n등분
    return df.groupby(groups, observed=True).agg(
        cohort_avg=(metric, 'mean'),        # 코호트의 메트릭 평균
        churn_rate=('is_churn', 'mean'),    # 코호트의 이탈률
        n=('is_churn', 'size'))
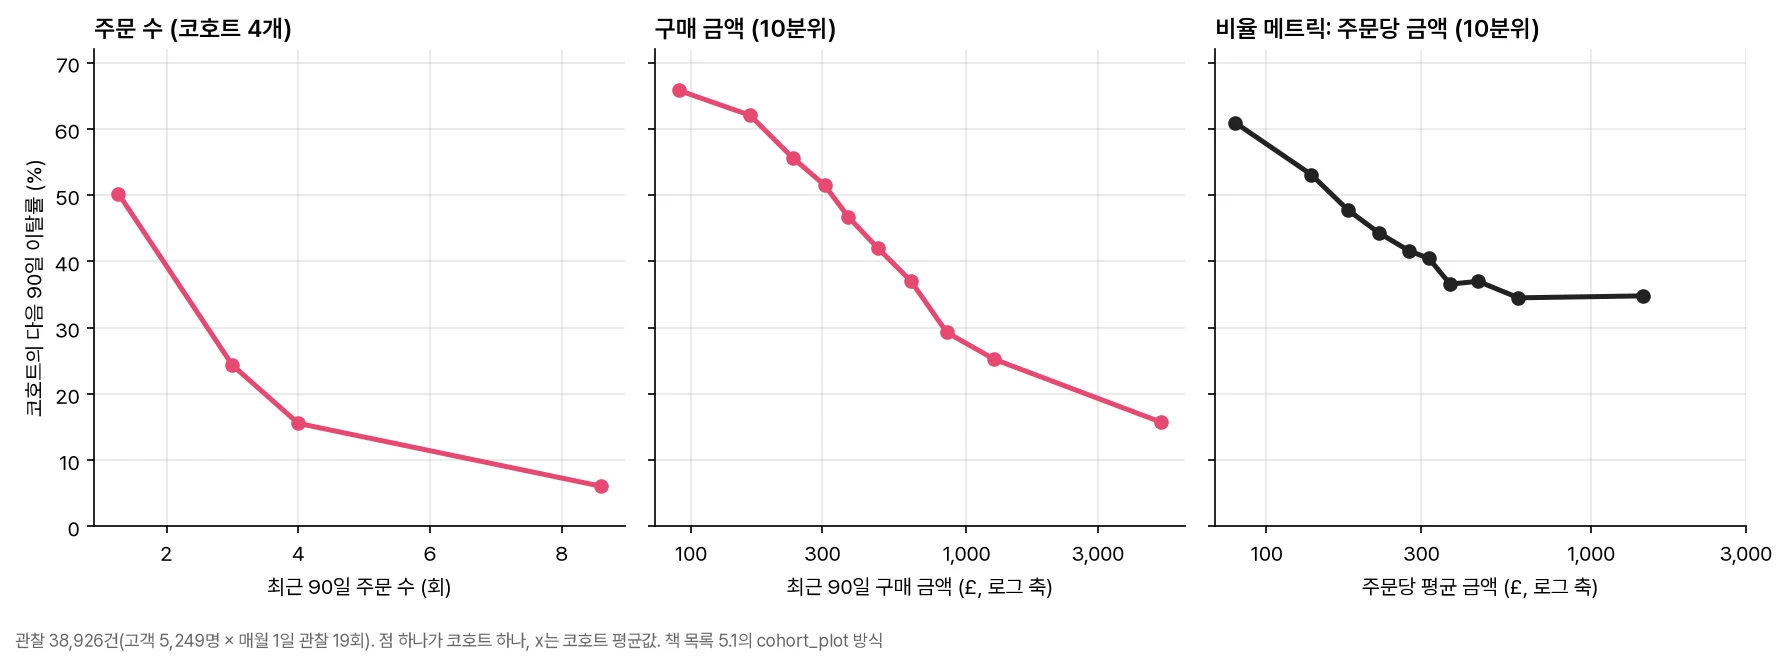
| 메트릭 | 값이 가장 낮은 코호트의 이탈률 | 값이 가장 높은 코호트의 이탈률 | 읽는 법 |
|---|---|---|---|
| 최근 90일 주문 수 | 1~2회: 50.2% | 4회 초과(평균 8.6회): 6.1% | 가장 강한 신호 |
| 최근 90일 구매 금액 | 하위 10%(평균 £90): 65.8% | 상위 10%(평균 £5,098): 15.7% | 꾸준히 내려감 |
| 주문당 평균 금액 | 하위 10%(평균 £80): 60.9% | 상위 10%(평균 £1,443): 34.8% | £400 근처부터 평평 |
| 마지막 주문 이후 일수 | 5일 이내: 31.8% | 75~89일: 57.3% | 오래 쉴수록 이탈 |
| 첫 주문 이후 일수 | 30일 이내: 59.6% | 483~638일: 27.0% | 신규 고객이 가장 위험 |
첫 주문 이후 일수는 데이터가 시작하는 2009년 12월 1일 이전 기록을 모르므로, 그 전부터 거래하던 고객은 실제보다 짧게 잡힙니다. 관찰일이 뒤로 갈수록 “첫 주문 30일 이내” 고객은 그 전 1년 넘게 주문 기록이 없는 사람이라 실제 신규일 가능성이 높아집니다.
10등분을 했는데 코호트가 4개만 나온 이유
주문 수 그래프에는 점이 4개뿐입니다. 관찰 38,926건 중 79%가 주문 1~2회에 몰려 있어서 10분위 경계값이 겹쳤고, duplicates='drop'이 겹친 경계를 합쳤습니다. 오류는 나지 않으니 표의 행 수를 세지 않으면 놓칩니다. 책도 5.1.8절에서 대다수 고객의 값이 0에 몰린 메트릭을 따로 다룰 만큼 흔한 상황입니다. 이럴 때는 분위 대신 실제 값으로 나눠 보면 됩니다. 주문 1회 고객의 이탈률은 55.6%, 2회는 35.7%, 3회는 24.3%, 5회는 9.2%였습니다.
비율 메트릭은 주문 수가 못 보여 주는 정보를 더합니다
주문당 평균 금액은 구매 금액을 주문 수로 나눈 값으로, 7장에서 다루는 비율 메트릭입니다. 로그를 씌우면 주문 수와의 상관계수가 0.10에 그쳐서 “얼마나 자주 사는가”와 거의 겹치지 않는 정보입니다. 실제로 주문을 딱 한 번 한 고객만 모아도 주문당 금액 하위 20%의 이탈률은 66.4%, 상위 20%는 46.5%로 갈렸습니다. 같은 1회 구매 고객이라도 첫 주문을 크게 한 고객이 덜 떠납니다.
반대로 주문당 상품 종류 수는 10종을 넘으면 이탈률이 40% 안팎에서 더 내려가지 않았습니다. 모든 메트릭이 이탈을 설명하지는 않고, 코호트 그래프가 평평해지는 지점에서 그 메트릭의 쓸모가 끝납니다.
코호트 차이는 원인이 아닙니다
주문을 많이 한 고객이 덜 떠난다고 해서 주문을 늘리면 이탈이 줄어든다는 뜻은 아닙니다. 원래 이 가게를 좋아하는 고객이 자주 사고, 그래서 덜 떠날 수도 있습니다. 책도 5.1.9절에서 “메트릭이 이탈의 원인인가?”를 따로 다룹니다. 코호트 분석의 결과는 “어떤 고객에게 먼저 연락할지”를 정하는 근거로 쓰고, 개입이 효과가 있는지는 실험으로 따로 확인해야 합니다.
실험 3: 비슷한 메트릭을 회귀에 같이 넣으면 부호가 뒤집힙니다
3부의 예측도 가볍게 확인했습니다. 앞쪽 13개월(2010-032011-03)의 관찰로 로지스틱 회귀를 학습하고, 뒤쪽 6개월(2011-042011-09)로 AUC를 쟀습니다. 금액 메트릭은 로그를 씌운 뒤 표준화했습니다.
| 넣은 메트릭 | AUC | 구매 금액의 계수 |
|---|---|---|
| 주문 수 하나 | 0.674 | - |
| 구매 금액 하나 | 0.695 | -0.71 (많이 살수록 덜 이탈) |
| 주문 수 + 주문당 금액 + 마지막 주문 이후 일수 + 가입 기간 | 0.726 | - |
| 위 4개 + 구매 금액 | 0.726 | +0.56 (많이 살수록 더 이탈?) |
구매 금액만 넣으면 계수가 음수로, 코호트 그래프와 같은 방향입니다. 그런데 주문 수와 주문당 금액을 함께 넣으면 구매 금액의 계수가 양수로 뒤집힙니다. 구매 금액은 주문 수와 주문당 금액을 곱한 값이라, 로그를 씌우면 두 값의 합과 거의 같아집니다. 회귀가 같은 정보를 세 변수에 나눠 싣다 보니 계수 하나하나의 의미가 사라졌습니다. 구매 금액을 빼도 AUC는 0.726 그대로이고, 남은 계수는 모두 코호트 그래프와 같은 방향입니다.
이 함정이 책의 8.5.1절 “상관 메트릭”이고, 6장 전체가 서로 겹치는 메트릭을 묶거나 걸러 내는 방법입니다. 예측 정확도만 보면 문제가 드러나지 않고, 계수를 사업 담당자에게 설명하는 순간 “많이 산 고객이 더 떠난다”는 엉뚱한 말이 나옵니다.
읽고 따라 하기 전에 알아 둘 것
좋았던 점은 이탈률을 하나의 숫자로 두지 않는다는 점입니다. 2장 한 장 안에 순 리텐션, 계정 기반 표준 이탈, 활동 이탈, 월간 반복 수익(MRR) 이탈을 각각의 SQL로 구분하고, 측정 기간을 바꿨을 때 이탈률을 환산하는 법까지 다룹니다. 실험 1처럼 정의가 숫자를 얼마나 바꾸는지 직접 보면, 이 구분이 왜 필요한지 납득이 됩니다. 코드와 시뮬레이션 데이터가 공개되어 있어 자기 데이터가 없어도 책 전체를 따라 하게 되어 있는 점도 좋습니다.
따라 할 때 막히는 지점은 다음과 같습니다.
- PostgreSQL이 필요합니다. 저자 코드는 Python과 PostgreSQL을 전제로 하고, README에는 Python 3.9~3.12를 지원하며 3.13은 아직 지원하지 않는다고 적혀 있습니다(2025년 4월 공지 기준).
- 첫 인쇄본의 경로가 지금 코드와 다릅니다. 책에 나오는
listings/py/run_churn_list.py는 현재fightchurn/run_churn_listing.py이고, 데이터 생성 스크립트도fightchurn/churnsim아래로 옮겨졌습니다. 2025년판은 에이콘이 별도 저장소에도 소스를 올려 두었습니다. - 더 현실적인 데이터는 무겁습니다. 2023년에 추가된 CRM 시뮬레이션(
crm5)은 README 기준 한 시간가량 돌고 PostgreSQL에 약 30GB를 만듭니다. - 책값과 분량이 부담될 수 있습니다. 2025년판도 572쪽, 정가 42,000원입니다.
취준생이라면 이 순서로 읽고 따라 해 보세요
포트폴리오용으로 읽는다면 2장(이탈 측정) → 4장(관찰 데이터셋 만들기) → 5장(메트릭 코호트)을 먼저 읽고, 각 장을 읽은 날 공개 데이터로 바로 돌려 보는 방법을 권합니다. 이 글에서 쓴 Online Retail II처럼 구독이 아닌 데이터라면 2.5절과 4.4절의 비구독 버전을 따르면 됩니다.
결과를 정리할 때는 이 글의 세 실험처럼 “이탈을 며칠 무활동으로 정의했는지”, “코호트가 몇 개로 나뉘었는지”, “겹치는 메트릭을 어떻게 처리했는지”를 함께 적어 두세요. 세 가지가 적혀 있어야 숫자를 본 사람이 같은 계산을 다시 해 볼 수 있습니다. 같은 데이터로 신규 고객 리텐션을 SQL로 계산할 때 생기는 오류는 윈도우 함수와 리텐션의 조용한 오류 글에서 다뤘습니다.
이 글의 전체 재현 코드 (pandas, scikit-learn)
# 데이터: https://archive.ics.uci.edu/dataset/502/online+retail+ii 의 online_retail_II.xlsx
import pandas as pd, numpy as np
from sklearn.linear_model import LogisticRegression
from sklearn.metrics import roc_auc_score

raw = pd.concat(pd.read_excel('online_retail_II.xlsx', sheet_name=None).values(), ignore_index=True)
df = raw.drop_duplicates()
df = df[df['Customer ID'].notna() & ~df['Invoice'].astype(str).str.startswith('C')]
df = df[(df.Quantity > 0) & (df.Price > 0)].assign(amount=lambda d: d.Quantity * d.Price)
c = 'Customer ID'
inv = df.groupby([c, 'Invoice'], as_index=False).agg(
    t=('InvoiceDate', 'min'), amount=('amount', 'sum'), lines=('StockCode', 'nunique'))

# 실험 1: 활동 이탈 (책 목록 2.3의 계산 규칙)
def active(day, w):
    m = (inv.t > day - pd.Timedelta(days=w)) & (inv.t <= day)
    return set(inv.loc[m, c])

rows = []
for w in [30, 60, 90]:
    for s in pd.date_range('2010-03-01', '2011-11-01', freq='MS'):
        A, B = active(s, w), active(s + pd.DateOffset(months=1), w)
        rows.append(dict(window=w, start=s, n_start=len(A), churn=len(A - B) / len(A)))
print(pd.DataFrame(rows).groupby('window').churn.agg(['mean', 'min', 'max']))

# 실험 2: 관찰 데이터셋 (매월 1일 관찰, 직전 90일 메트릭, 다음 90일 무주문 = 이탈)
obs = []
for d in pd.date_range('2010-03-01', '2011-09-01', freq='MS'):
    past = inv[(inv.t > d - pd.Timedelta(days=90)) & (inv.t <= d)]
    future = set(inv.loc[(inv.t > d) & (inv.t <= d + pd.Timedelta(days=90)), c])
    first = inv[inv.t <= d].groupby(c).t.min()
    g = past.groupby(c).agg(orders=('Invoice', 'nunique'), spend=('amount', 'sum'),
                            last=('t', 'max'), lines=('lines', 'sum'))
    g['avg_order_value'] = g.spend / g.orders
    g['avg_lines_per_order'] = g.lines / g.orders
    g['days_since_last'] = (d - g['last']).dt.days
    g['tenure_days'] = (d - first.reindex(g.index)).dt.days
    g['is_churn'] = ~g.index.isin(future)
    g['obs_date'] = d
    obs.append(g.drop(columns=['last', 'lines']))
o = pd.concat(obs).reset_index()

for m in ['orders', 'spend', 'avg_order_value', 'avg_lines_per_order', 'days_since_last', 'tenure_days']:
    q = pd.qcut(o[m], 10, duplicates='drop')
    print(o.groupby(q, observed=True).agg(avg=(m, 'mean'), churn=('is_churn', 'mean'), n=('is_churn', 'size')))

# 실험 3: 로지스틱 회귀 (앞 13개월 학습, 뒤 6개월 평가)
X = o[['orders', 'spend', 'avg_order_value', 'days_since_last', 'tenure_days']].copy()
for col in ['orders', 'spend', 'avg_order_value']:
    X[col] = np.log1p(X[col])
X = (X - X.mean()) / X.std()
tr = o.obs_date < '2011-04-01'
for cols in [['orders'], ['spend'],
             ['orders', 'avg_order_value', 'days_since_last', 'tenure_days'],
             ['orders', 'spend', 'avg_order_value', 'days_since_last', 'tenure_days']]:
    model = LogisticRegression().fit(X.loc[tr, cols], o.is_churn[tr])
    auc = roc_auc_score(o.is_churn[~tr], model.predict_proba(X.loc[~tr, cols])[:, 1])
    print(cols, round(auc, 3), dict(zip(cols, model.coef_[0].round(2))))