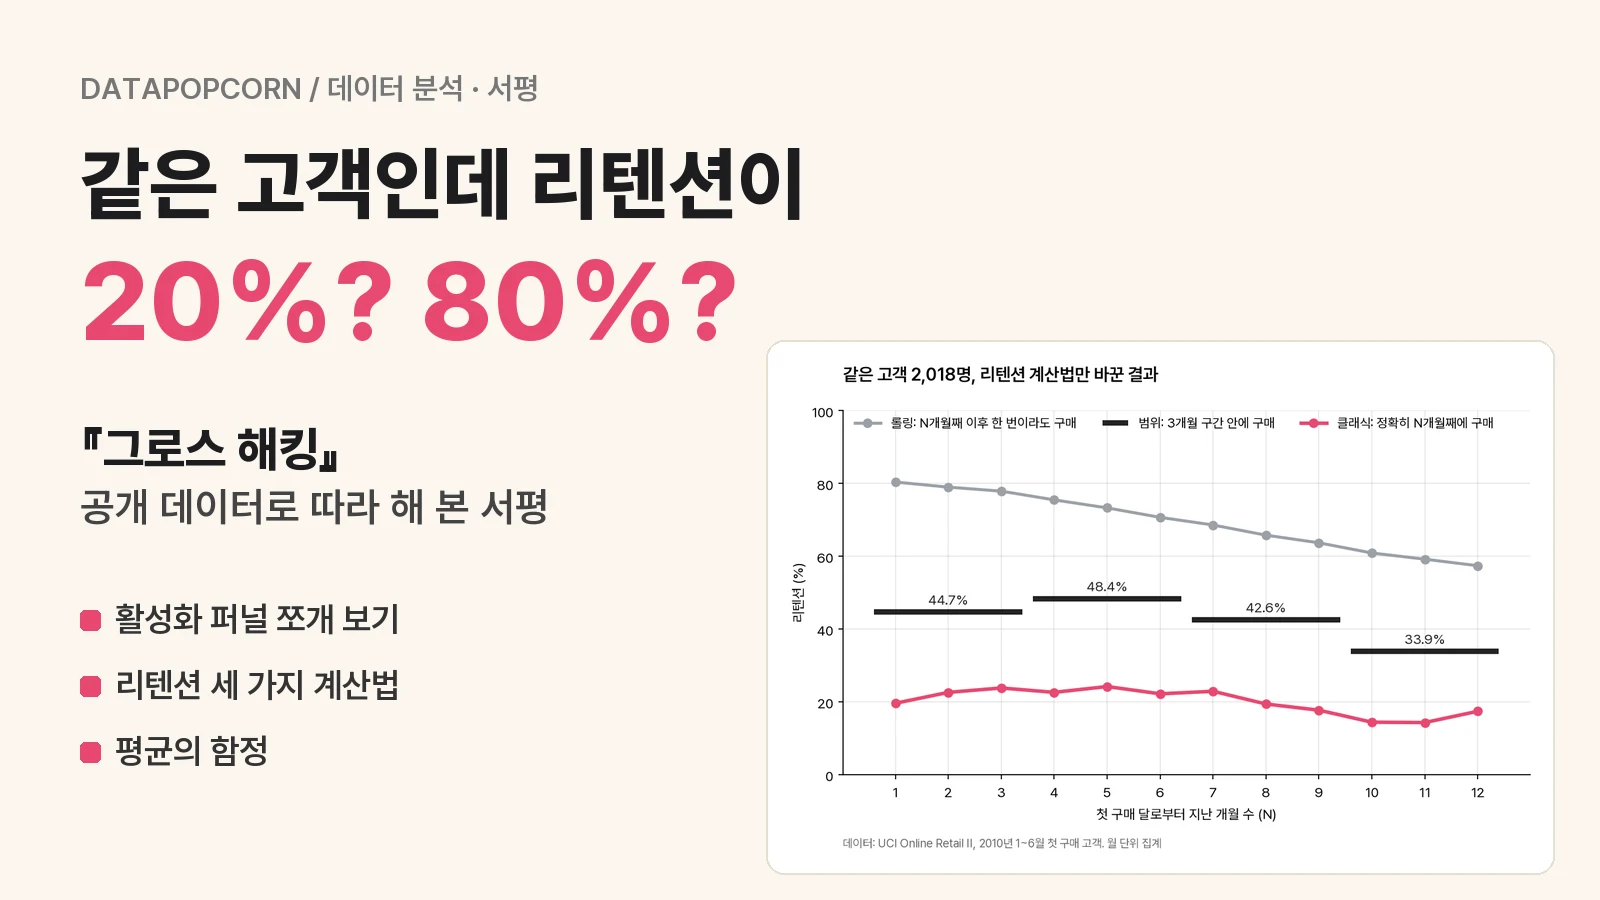
같은 고객인데 리텐션이 20%도, 80%도 나옵니다: 『그로스 해킹』 따라 해 본 서평
이 글과 연결된 글 보기
드래그로 이동 · 휠/두 손가락으로 확대 · 방향키로 글 선택 · 0으로 맞춤. 실선: 본문 링크, 점선: 시리즈·주제의 대표 연결.표시된 글 16편 목록
같은 온라인몰 고객 2,018명의 다음 달 리텐션을 계산했더니, 계산법에 따라 19.6%, 44.7%, 80.4%가 나왔습니다. 양승화의 『그로스 해킹』은 3.4절에서 리텐션을 재는 방법을 클래식, 범위, 롤링 세 가지로 나눠 설명합니다. 이 세 가지와 3.3절의 퍼널 쪼개 보기, 4.1절의 대푯값 주의점을 공개 데이터에 그대로 적용해 봤습니다. 구매로 끝난 세션 1,908건 중 퍼널 단계를 순서대로 지난 세션은 1,509건뿐이었고, 2011년 고객당 매출은 평균이 1,971파운드인데 중앙값은 658파운드였습니다. 제가 읽고 데이터 직군 취준생에게 권하는 책이라, 책의 구성과 직접 돌려 본 결과, 읽을 때 걸리는 지점을 함께 정리했습니다.
이 책은 어떤 책인가요
저자 양승화는 네이버, 이음소시어스, SK텔레콤을 거쳐 책을 낼 당시 마이리얼트립의 그로스실 실장(Head of Growth)으로 데이터 파이프라인, 핵심 지표 관리, 가설 검증, 성장 실험을 맡았습니다. 출판사가 밝힌 대상 독자는 데이터 분석 공부를 시작하는 기획자·마케터·분석가, 스타트업에 관심이 있는 사람, 데이터를 업무에 적용하는 과정을 알고 싶은 실무자입니다.
| 항목 | 내용 |
|---|---|
| 제목 | 그로스 해킹 - 데이터와 실험을 통해 성장하는 서비스를 만드는 방법 |
| 출판사 | 위키북스 |
| 출간 | 2021-01-14, 256쪽 |
| 정가 | 15,000원 (예스24 판매가 13,500원, 전자책 10,500원) |
| ISBN | 9791158392369 |
| 지금 구하는 법 | 예스24 기준 판매 중 (2026년 11월 22일 확인) |
1편에서 다룬 『고객 리텐션의 전략』이 572쪽에 SQL과 Python 코드를 따라 치는 실무서였다면, 이 책은 256쪽 안에 지표 정의부터 조직 문화까지 넓게 훑는 입문서입니다. 코드는 거의 없고, 각 지표를 어떤 질문에 쓰는지와 어떻게 잘못 읽히는지를 문장과 예시로 설명합니다.
책의 절반 가까이가 3장 AARRR입니다
출판사가 공개한 목차는 6개 장과 에필로그입니다. 가장 큰 장은 3장 AARRR로, 3.1 개요 뒤에 고객 유치(Acquisition), 활성화(Activation), 리텐션(Retention), 수익화(Revenue), 추천(Referral)을 한 절씩 다룹니다.
순서에도 주장이 담겨 있습니다. 2장에서 제품-시장 적합성(PMF)을 먼저 확인하라고 한 뒤에야 3장의 지표 관리로 넘어갑니다. 2.4절은 PMF를 확인하는 지표로 리텐션, 전환율, 순수 추천 지수(NPS)를 듭니다. 4장은 지표를 읽을 때 빠지는 함정을 모아 둔 장으로, 4.1절에 허무 지표, 심슨 패러독스, 대푯값을 쓸 때의 주의점, 생존자 편향이 이어집니다. 5장은 행동 로그 설계와 A/B 테스트, 6장은 그로스 조직 구성과 문화입니다.
이번 실험은 3.3절(활성화), 3.4절(리텐션), 4.1절의 대푯값 항목을 골랐습니다. 취준생이 포트폴리오에서 가장 자주 계산하는 지표이고, 공개 데이터로 바로 확인이 되는 부분입니다.
따라 한 데이터 두 가지
- 세션 데이터: UCI의 Online Shoppers Purchasing Intention(CC BY 4.0). 한 온라인몰의 1년치 세션 12,330건이고, 세션마다 본 페이지 수, 구글 애널리틱스의 페이지 가치(PageValues), 방문자 유형(신규·재방문), 월, 구매 여부가 들어 있습니다. 완전히 같은 행 125개를 지워 12,205세션으로 썼고, 이 중 1,908세션(15.6%)이 구매로 끝났습니다.
- 거래 데이터: 1편에서 쓴 UCI Online Retail II. 영국 선물용품 온라인몰의 2009년 12월~2011년 12월 거래입니다. 1편과 같은 기준으로 중복 행, 고객 ID가 없는 행, 취소 송장, 수량·가격이 0 이하인 행을 뺐습니다.
실험 1: 퍼널을 정의해 보면 순서를 건너뛴 구매가 보입니다
3.3절은 활성화를 다루며 퍼널의 세부 단계를 정의하고, 단계별 전환율을 재고, 코호트별로 쪼개 보는 순서를 따릅니다. 세션 데이터로 퍼널을 네 단계로 정의했습니다. 상품 페이지를 1개 이상 본 세션, 5개 이상 본 세션, 페이지 가치가 0보다 큰 페이지(구매 직전에 거치는 페이지)에 닿은 세션, 그리고 구매입니다.
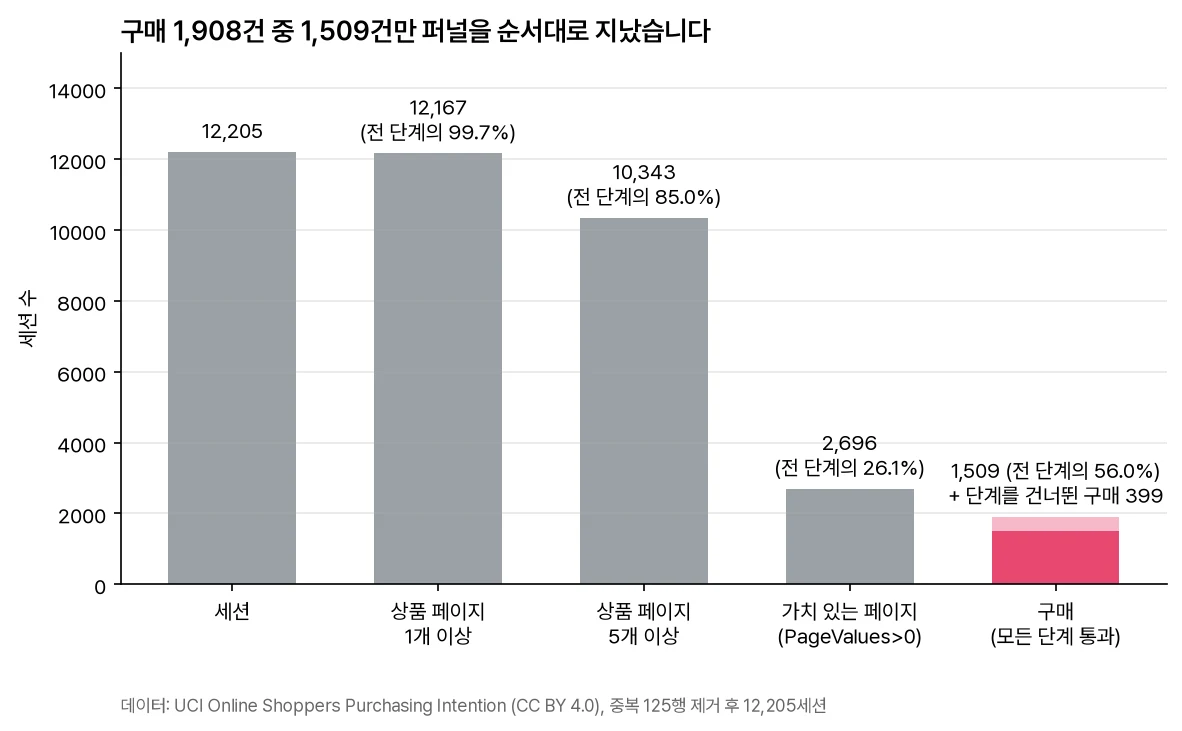
| 단계 | 세션 수 | 전 단계 대비 |
|---|---|---|
| 세션 | 12,205 | - |
| 상품 페이지 1개 이상 | 12,167 | 99.7% |
| 상품 페이지 5개 이상 | 10,343 | 85.0% |
| 페이지 가치 > 0 | 2,696 | 26.1% |
| 구매(모든 단계 통과) | 1,509 | 56.0% |
가장 크게 줄어드는 곳은 상품을 둘러본 뒤 구매 직전 페이지로 넘어가는 단계(26.1%)입니다. 그런데 표만 보면 구매가 1,509건으로 보이지만 실제 구매 세션은 1,908건입니다. 나머지 399건은 상품 페이지를 5개 미만으로 봤거나 페이지 가치가 0인 채로 구매했습니다. 퍼널을 필터의 연속으로 계산하면 이 399건(구매의 20.9%)이 조용히 빠집니다. 단계를 정의한 다음에는 “단계를 건너뛴 전환이 몇 건인지”를 같이 세어야 정의가 실제 행동과 맞는지 보입니다.
코호트로 쪼개면 신규 방문자가 더 많이 삽니다
같은 구매율을 방문자 유형으로 나누면 신규 방문자 1,693세션의 구매율은 24.9%, 재방문자 10,431세션은 14.1%입니다. 재방문자가 더 많이 살 거라는 직관과 반대입니다.
4.1절에 심슨 패러독스 항목이 있어서, 이 차이가 월별 구성 때문에 생긴 착시인지 확인했습니다. 세션의 월 분포가 고르지 않기 때문입니다(5월 3,329세션, 2월 181세션). 월마다 나눠 봐도 신규 방문자의 구매율이 10개월 중 9개월에서 더 높았고, 예외인 2월은 신규 방문자 세션이 1건뿐이었습니다. 차이의 크기는 달마다 달라서 10월은 22.6% 대 20.5%로 2.1%p, 5월은 27.6% 대 9.2%로 18.4%p였습니다. 이번 데이터에서는 방향이 뒤집히지 않았지만, 합계 숫자를 보고하기 전에 한 번은 쪼개 봐야 “뒤집히지 않았다”고 말하게 됩니다.
실험 2: 리텐션은 계산법에 따라 19.6%에서 80.4%까지 갈립니다
3.4절의 리텐션 계산법 세 가지를 같은 고객에게 적용했습니다. 거래 데이터에서 첫 구매 달이 2010년 1~6월인 고객 2,018명을 고르고, 첫 구매 달을 0개월로 놓은 뒤 월 단위로 셌습니다.
| 계산법 | 책의 정의 | 이번 계산 |
|---|---|---|
| 클래식 | Day N에 이용한 사람 / Day 0에 처음 이용한 사람 | 정확히 N개월째 달에 구매한 고객 비율 |
| 범위 | Range N에 이용한 사람 / Range 0에 처음 이용한 사람 | 1 |
| 롤링 | After N day에 이용한 사람 / Day 0에 처음 이용한 사람 | N개월째 이후 언젠가 한 번이라도 구매한 비율 |
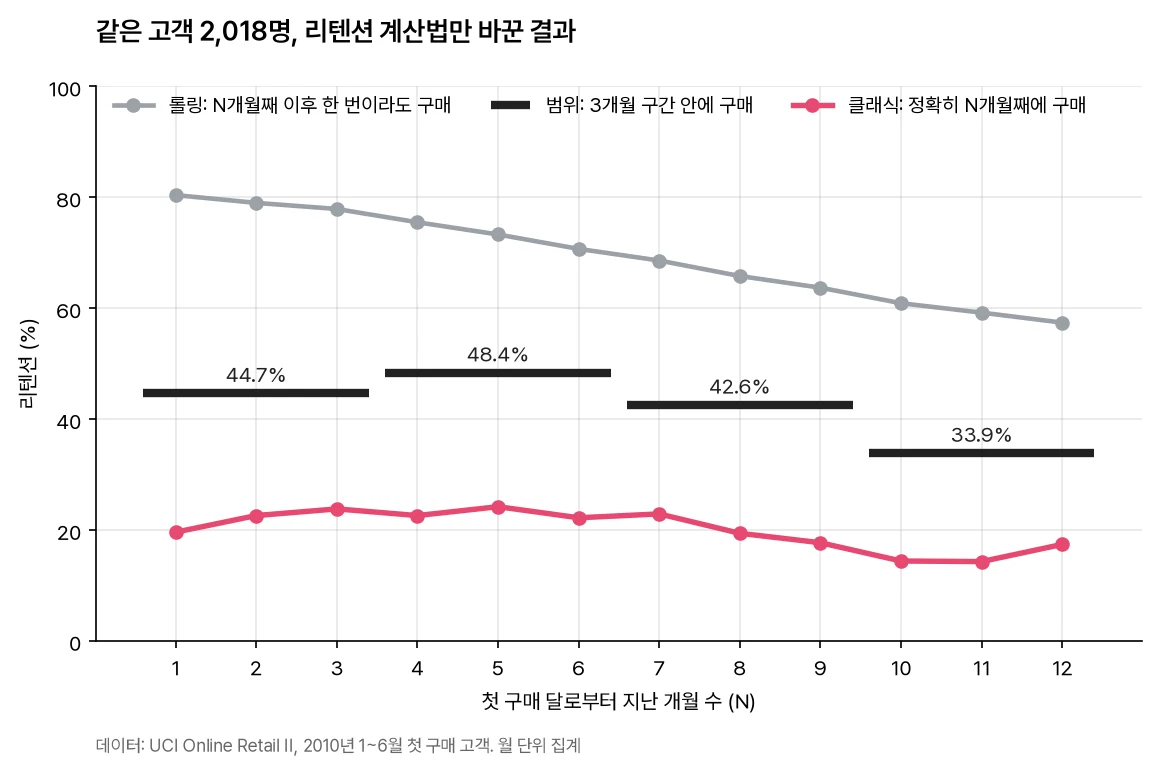
| 기간 | 클래식 | 범위(3개월) | 롤링 |
|---|---|---|---|
| 1개월째 | 19.6% | 1~3개월: 44.7% | 80.4% |
| 3개월째 | 23.8% | 77.9% | |
| 6개월째 | 22.2% | 4~6개월: 48.4% | 70.7% |
| 12개월째 | 17.4% | 10~12개월: 33.9% | 57.4% |
같은 고객인데 “다음 달 리텐션”이 19.6%도 되고 80.4%도 됩니다. 클래식은 그 달 하나만 보고, 롤링은 그 뒤 전체 기간 중 한 번만 와도 남은 고객으로 칩니다. 롤링 1개월째 80.4%는 뒤집어 말하면 첫 구매 달 이후 다시는 사지 않은 고객이 19.6%라는 뜻입니다.
계산하며 확인한 성질이 세 가지 있습니다.
- 롤링은 관측이 끝나는 날에 따라 바뀝니다. “N개월째 이후 언젠가”의 끝이 데이터 마지막 날(2011년 12월 9일)이라, 데이터가 한 달 더 쌓이면 지금 계산한 값도 올라갑니다.
- 범위는 구간이 길수록 올라갑니다. 3개월 구간의 44.7%는 그 안의 어느 한 달 클래식 값(19.6~23.8%)의 두 배쯤 됩니다.
- 클래식은 달력의 영향을 받습니다. 2010년 3월 첫 구매 고객 443명만 따로 보면 클래식 리텐션이 2010년 10월(7개월째) 30.2%였다가 12월 10.8%, 2011년 1월 11.5%로 떨어집니다. 고객이 줄었다기보다 연말 성수기 뒤 주문이 쉬는 달이 끼어든 결과라, 한 달 값만 보고 추세를 말하면 안 됩니다.
이 온라인몰은 도매 고객이 많아 몇 달에 한 번씩 주문하는 고객이 흔합니다. 매달 오기를 기대하는 서비스가 아니면 클래식 값은 실제보다 비관적으로 보이고, 롤링 값은 너무 낙관적으로 보입니다. 보고서에는 어떤 계산법을 왜 골랐는지와, 다른 계산법으로 보면 얼마인지를 함께 적는 편이 안전합니다.
이 데이터는 2009년 12월부터 시작해서, 2010년 1~6월에 “처음” 산 고객 중에는 그 이전부터 거래하던 고객이 섞여 있습니다. 1편에서 다룬 경계 문제와 같은 한계입니다.
실험 3: 고객당 매출은 평균과 중앙값이 세 배 차이 납니다
4.1절은 대푯값을 쓸 때 주의할 점을 따로 다룹니다. 2011년(12월 9일까지) 거래가 있는 고객 4,219명의 고객당 매출을 계산했습니다.
| 지표 | 값 |
|---|---|
| 고객당 평균 매출 | £1,971.3 |
| 고객당 중앙값 | £657.8 |
| 평균보다 많이 산 고객 | 20.1% |
| 상위 1% 고객(42명)의 매출 비중 | 32.0% |
| 상위 1%를 뺀 평균 | £1,354.8 |
“고객 한 명이 1년에 평균 1,971파운드를 쓴다”는 문장은 틀리지 않았지만, 고객 다섯 명 중 네 명은 그보다 적게 씁니다. 42명이 매출의 3분의 1을 만들기 때문에, 이 42명을 빼기만 해도 평균이 1,355파운드로 내려갑니다. 3.5절의 수익화 지표를 계산할 때 평균 하나만 보고하면 대부분의 고객과 거리가 먼 숫자가 됩니다. 중앙값과 상위 고객 비중을 함께 적어야 합니다.
읽고 따라 하기 전에 알아 둘 것
좋은 점은 지표를 “무엇을 확인하려고 보는가”부터 설명한다는 점입니다. 3장은 각 지표마다 기본 개념, 측정 방법, 개선 방법, 정리 순서로 반복되어 구조를 잡기 쉽고, 4장은 지표가 틀리게 읽히는 경우를 따로 모아 둡니다. 실험 2처럼 리텐션 계산법 세 가지를 나란히 계산해 보면, 책이 왜 리텐션 숫자보다 정의를 먼저 정하라고 하는지 바로 보입니다. 256쪽에 15,000원이라 첫 책으로 부담이 적은 편입니다.
걸리는 지점은 다음과 같습니다.
- 코드와 데이터가 없습니다. 개념과 공식은 책에 있지만 계산은 독자가 직접 데이터를 구해 해야 합니다. 이 글의 재현 코드처럼 공개 데이터를 하나 정해 두고 절마다 계산해 보는 방식을 권합니다.
- 2021년 1월에 나온 책입니다. 모바일 앱 어트리뷰션(3.2절)이나 행동 로그 도구처럼 바뀌는 속도가 빠른 영역은 지금 쓰는 도구의 공식 문서와 대조해서 읽어야 합니다.
- 공개 데이터에는 앱 서비스 같은 접속 로그가 드뭅니다. 책의 예시는 접속·로그인 중심인데, 공개 데이터는 거래나 세션 단위가 많습니다. 실험 2처럼 “접속”을 “구매”로, “일”을 “월”로 바꿔 적용하고, 바꾼 기준을 글에 밝혀 두면 됩니다.
취준생이라면 이렇게 읽어 보세요
처음에는 2장과 3장을 읽고, 3.3절과 3.4절은 읽은 날 공개 데이터로 바로 계산해 보세요. 퍼널은 단계를 정의한 뒤 건너뛴 전환을 세고, 리텐션은 세 가지 계산법으로 같은 고객을 계산해 표 하나에 나란히 놓으면 됩니다. 4장은 계산을 마친 뒤에 다시 읽으면서 자기 결과에 심슨 패러독스나 대푯값 문제가 없는지 점검하는 체크리스트로 쓰기 좋습니다.
포트폴리오에는 숫자와 함께 “퍼널 단계를 어떻게 정의했는지”, “리텐션을 어떤 계산법으로 쟀는지”, “평균 대신 무엇을 같이 봤는지”를 적어 두세요. 이 세 가지가 적혀 있어야 읽는 사람이 같은 숫자를 다시 계산할 수 있습니다. 리텐션을 고객 행동 메트릭과 이탈 예측으로 더 깊게 파고 싶다면 1편 『고객 리텐션의 전략』 서평으로 이어서 읽으면 됩니다.
이 글의 전체 재현 코드 (pandas)
# 데이터 1: https://archive.ics.uci.edu/dataset/468 의 online_shoppers_intention.csv
# 데이터 2: https://archive.ics.uci.edu/dataset/502 의 online_retail_II.xlsx
import pandas as pd, numpy as np

# 실험 1: 활성화 퍼널과 코호트별 전환율 (Online Shoppers)
s = pd.read_csv('online_shoppers_intention.csv').drop_duplicates()
steps = {
    '세션': len(s),
    '상품 페이지 1개 이상': (s.ProductRelated >= 1).sum(),
    '상품 페이지 5개 이상': (s.ProductRelated >= 5).sum(),
    '가치 있는 페이지 도달(PageValues>0)': ((s.ProductRelated >= 5) & (s.PageValues > 0)).sum(),
    '구매': ((s.ProductRelated >= 5) & (s.PageValues > 0) & s.Revenue).sum(),
}
print(steps, '전체 구매', s.Revenue.sum())
print('단계를 건너뛴 구매:', (s.Revenue & ~((s.ProductRelated >= 5) & (s.PageValues > 0))).sum())
print(s.groupby('VisitorType').Revenue.agg(['mean', 'size']))
nr = s[s.VisitorType != 'Other']
print(nr.groupby(['Month', 'VisitorType']).Revenue.agg(['mean', 'size']).unstack())

# 실험 2: 리텐션 세 가지 (Online Retail II, 월 단위)
raw = pd.concat(pd.read_excel('online_retail_II.xlsx', sheet_name=None).values(), ignore_index=True)
df = raw.drop_duplicates()
df = df[df['Customer ID'].notna() & ~df['Invoice'].astype(str).str.startswith('C')]
df = df[(df.Quantity > 0) & (df.Price > 0)].assign(amount=lambda d: d.Quantity * d.Price)
c = 'Customer ID'
df['m'] = df.InvoiceDate.dt.to_period('M')
act = df[[c, 'm']].drop_duplicates()
first = act.groupby(c).m.min()
last = act.groupby(c).m.max()
cohort = first[(first >= pd.Period('2010-01', 'M')) & (first <= pd.Period('2010-06', 'M'))]
A = act[act[c].isin(cohort.index)].copy()
A['k'] = (A.m - A[c].map(first)).apply(lambda x: x.n)
n = len(cohort)
classic = [A.loc[A.k == k, c].nunique() / n for k in range(1, 13)]
rng = [A.loc[A.k.between(3 * r - 2, 3 * r), c].nunique() / n for r in range(1, 5)]
span = (last[cohort.index] - first[cohort.index]).apply(lambda x: x.n)
rolling = [(span >= k).mean() for k in range(1, 13)]
print('코호트', n)
print('클래식', np.round(np.array(classic) * 100, 1))
print('범위(3개월)', np.round(np.array(rng) * 100, 1))
print('롤링', np.round(np.array(rolling) * 100, 1))

# 실험 3: 대푯값 (고객당 매출, 2011년)
y = df[df.InvoiceDate.dt.year == 2011].groupby(c).amount.sum().sort_values(ascending=False)
print('고객 수', len(y), '평균', round(y.mean(), 1), '중앙값', round(y.median(), 1))
print('평균보다 많이 산 고객 비율', round((y > y.mean()).mean() * 100, 1))
top = y.head(int(len(y) * 0.01))
print('상위 1% 고객 수', len(top), '매출 비중', round(top.sum() / y.sum() * 100, 1))
print('상위 1% 제외 평균', round(y.iloc[len(top):].mean(), 1))