
Jev, 누구에게 필요할까 — 댓글·카페 리뷰·채용공고·실종자 후보 220건으로 직접 돌려 봤습니다
이 글과 연결된 글 보기
드래그로 이동 · 휠/두 손가락으로 확대 · 방향키로 글 선택 · 0으로 맞춤. 실선: 본문 링크, 점선: 시리즈·주제의 대표 연결.표시된 글 14편 목록
Jev에게 판단을 맡길 만한 사람은 "매일 같은 기준으로 고르는 일"이 있는 사람입니다. 크리에이터 댓글, 카페 리뷰, 취준생 채용공고, 실종자 CCTV 후보를 220건 돌려 보니 23초에 $0.007이 들었습니다. 강의 문의를 찾고 맞는 공고를 고르는 일은 잘했지만, 환불 요청과 사기 댓글은 놓쳤습니다. 놓친 이유는 대부분 질문과 기준선을 어떻게 잡았느냐에 있었습니다.
배경 — "나한테 필요한 건지 모르겠다"
Jev는 글을 쓰는 대신 정해진 선택지 중 하나를 고르고 확률을 돌려주는 모델입니다. 작동 방식은 TypeSafe Jev 입문에서 정리했습니다. 해외에서는 사례가 2천 건 넘게 올라와 있지만 대부분 개발자가 만든 데모이고, 한국어로 비개발자의 일에 붙여 본 결과는 거의 없습니다.
쉽게 말하면 입력은 LLM처럼, 출력은 룰베이스처럼 동작합니다. 자유로운 문장을 읽고 뜻을 파악하지만, 답은 내가 정한 선택지와 확률로만 나옵니다. 그래서 결과를 코드의 조건문에 바로 연결할 수 있습니다.
다만 가운데 판단은 규칙이 아니라 모델이 합니다. 규칙처럼 늘 똑같이 맞지는 않고, 그럴듯하게 틀리기도 합니다. 이번 실험에서 그런 경우가 여러 번 나왔습니다.
그래서 질문을 바꿨습니다. "Jev로 뭘 할 수 있나"가 아니라 "누구의 어떤 일에 Jev가 맞나"입니다. 크리에이터, 카페 사장님, 취준생, 공공기관 담당자 네 사람을 정하고, 각자 매일 하는 판단 하나씩을 Jev에게 맡겨 봤습니다.
목표 — 정답과 비교해서 숫자로 말하기
네 실험 모두 같은 방식으로 진행했습니다.
- 데이터마다 사람이 생각하는 정답을 먼저 붙입니다
- Jev에게 같은 질문을 던집니다
- 정답과 비교해서 맞은 수, 놓친 수, 시간, 비용을 잽니다
"잘 되는 것 같다"로 끝내지 않으려고, 실험마다 성공 기준을 미리 정했습니다. 예를 들어 카페는 "사장님이 직접 봐야 할 위험 문의 6건을 하나도 놓치지 않는다"였습니다.
실험 방법 — 상황과 질문만 넘깁니다
Jev에는 프롬프트를 길게 쓰지 않습니다. 판단할 상황(state)과 질문(questions)만 넘깁니다. 카페 실험의 질문은 이렇습니다.
{
  "category": {
    "type": "choice",
    "instructions": "This is a review or message to a small neighborhood cafe in Korea. What kind of message is it?",
    "criteria": {
      "칭찬": "Positive review. May mention a small downside but the overall tone is good.",
      "불만": "Complains about taste, service, delivery, cleanliness, price, or facilities, or asks for a refund or exchange.",
      "질문": "Asks about hours, parking, pets, seats, menu changes, or other store information.",
      "예약·주문 문의": "Wants to reserve or place an order in advance.",
      "기타": "Sales, collaboration offers, or anything else."
    }
  },
  "is_risky": {
    "type": "noul",
    "instructions": "Must the owner personally handle this today instead of a staff member or an auto-reply?",
    "criteria": {
      "true": ["Hygiene problems or foreign objects in food.", "Health problems after eating or drinking.", "Asks for a refund, exchange, or the price difference back, or got the wrong item.", "Fights between customers, or mentions reporting or legal action."],
      "false": "Normal praise, small complaints about taste or facilities, and simple questions."
    }
  }
}
choice는 선택지 중 하나를 고르고, noul은 문장이 참일 확률을 0~1로 줍니다. 채용공고와 실종자 실험에는 단계별 점수를 주는 score도 썼습니다. 모델은 OpenRouter의 typesafe/jev-1.13이고, 판단 기준은 영어로 썼습니다. Jev는 영어 정확도가 가장 높다고 공식 문서에 적혀 있기 때문입니다.
결과 — 한눈에 보기
| 누구 | 데이터 | 시간 | 비용 | 잘한 것 | 못한 것 |
|---|---|---|---|---|---|
| 크리에이터 | 유튜브 실제 공개 댓글 100개 | 9.9초 | $0.0030 | 강의·연락 문의 5건 모두 찾음 | 스팸 2건 모두 놓침 |
| 카페 사장님 | 가상 카페 리뷰·DM 50건 | 5.3초 | $0.0013 | 분류 48/50 | 위험 문의 6건 중 3건 놓침 |
| 취준생 | 가상 이력서 1개 + 공고 30개 | 2.7초 | $0.0010 | 잘 맞는 공고 9개 중 8개를 상위에 | 큰 실수 없음 |
| 공공기관 | 가상 실종 신고 + 후보 40건 | 4.9초 | $0.0018 | 불가능한 후보를 상위 8명에서 모두 뺌 | 걸어서 갈 수 있는 거리 계산 |
카페와 실종자, 채용 데이터는 모두 지어낸 연습용 데이터입니다. 댓글은 데이터팝콘 유튜브 채널의 실제 공개 댓글이고, 작성자 정보는 저장하지 않았습니다.
크리에이터 — 문의 5건은 다 찾았지만 사기 댓글에 답하라고 했습니다
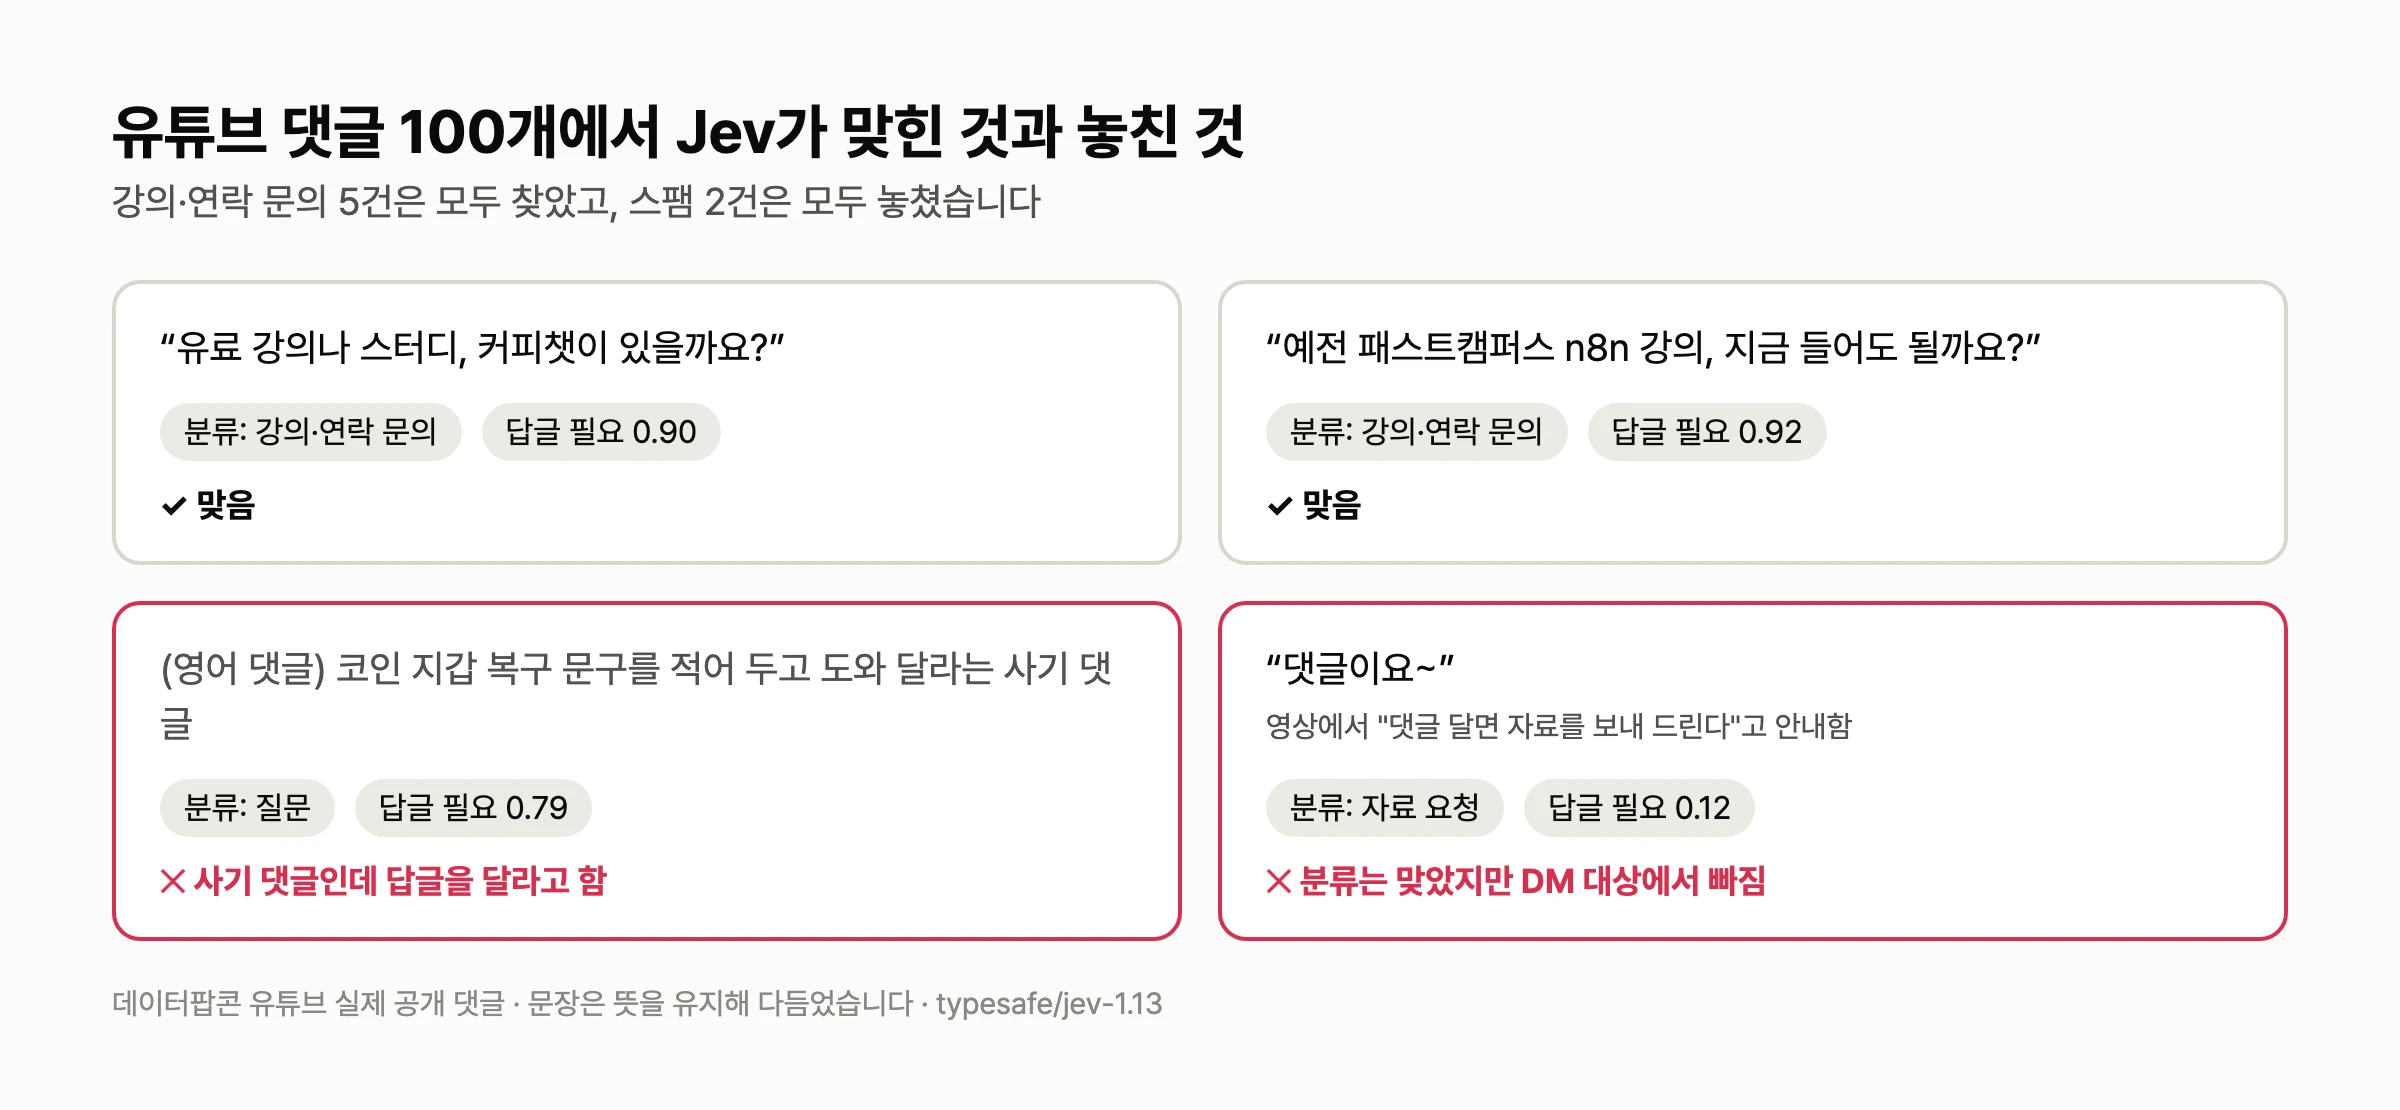
크리에이터에게 댓글 100개 중 정말 놓치면 안 되는 건 "유료 강의가 있나요", "연락처를 받을 수 있을까요" 같은 문의입니다. Jev는 이런 문의 5건을 모두 강의·연락 문의로 골랐고, 답글이 필요하다는 확률도 0.82~0.92로 높게 줬습니다. 전체 분류는 100개 중 86개가 정답과 같았습니다.
틀린 것 중에는 정답이 애매한 경우가 많았습니다. "결국 토큰 문제" 같은 댓글을 정답은 기타로, Jev는 비판으로 봤는데 어느 쪽이 맞다고 하기 어렵습니다. 확실히 틀린 건 두 가지입니다.
- 스팸 2건을 모두 놓쳤습니다. 그중 하나는 코인 지갑 복구 문구를 적어 두고 도움을 청하는 전형적인 사기 댓글이었는데, Jev는 이를
질문으로 보고 답글이 필요하다는 확률을 0.79로 줬습니다. - "댓글이요~"를
자료 요청으로 맞게 분류했지만, 답글 필요 확률은 0.12였습니다. 영상에서 "댓글 달면 자료를 보내 드린다"고 안내했기 때문에 이 댓글이 가장 확실하게 DM을 보내야 하는 댓글입니다. 같은 응답 안에서 두 질문의 답이 서로 맞지 않았습니다.
두 질문을 따로 판단하기 때문에 생기는 일입니다. 분류 결과로 답글 여부를 정하는 규칙은 Jev에 맡기지 말고 코드로 정하는 편이 안전합니다.
카페 사장님 — 분류는 Gemini와 같았지만, 환불 3건을 놓쳤습니다
같은 50건을 예전에 Gemini(gemini-3.5-flash-lite)로 분류해 본 기록이 있어서 비교할 수 있었습니다. 분류 정답은 둘 다 50건 중 48건으로 같았습니다. 사장님이 직접 봐야 할 위험 문의는 Gemini가 6건을 모두 잡았고, Jev는 3건을 놓쳤습니다.
놓친 3건의 확률을 보면 이유가 보입니다.
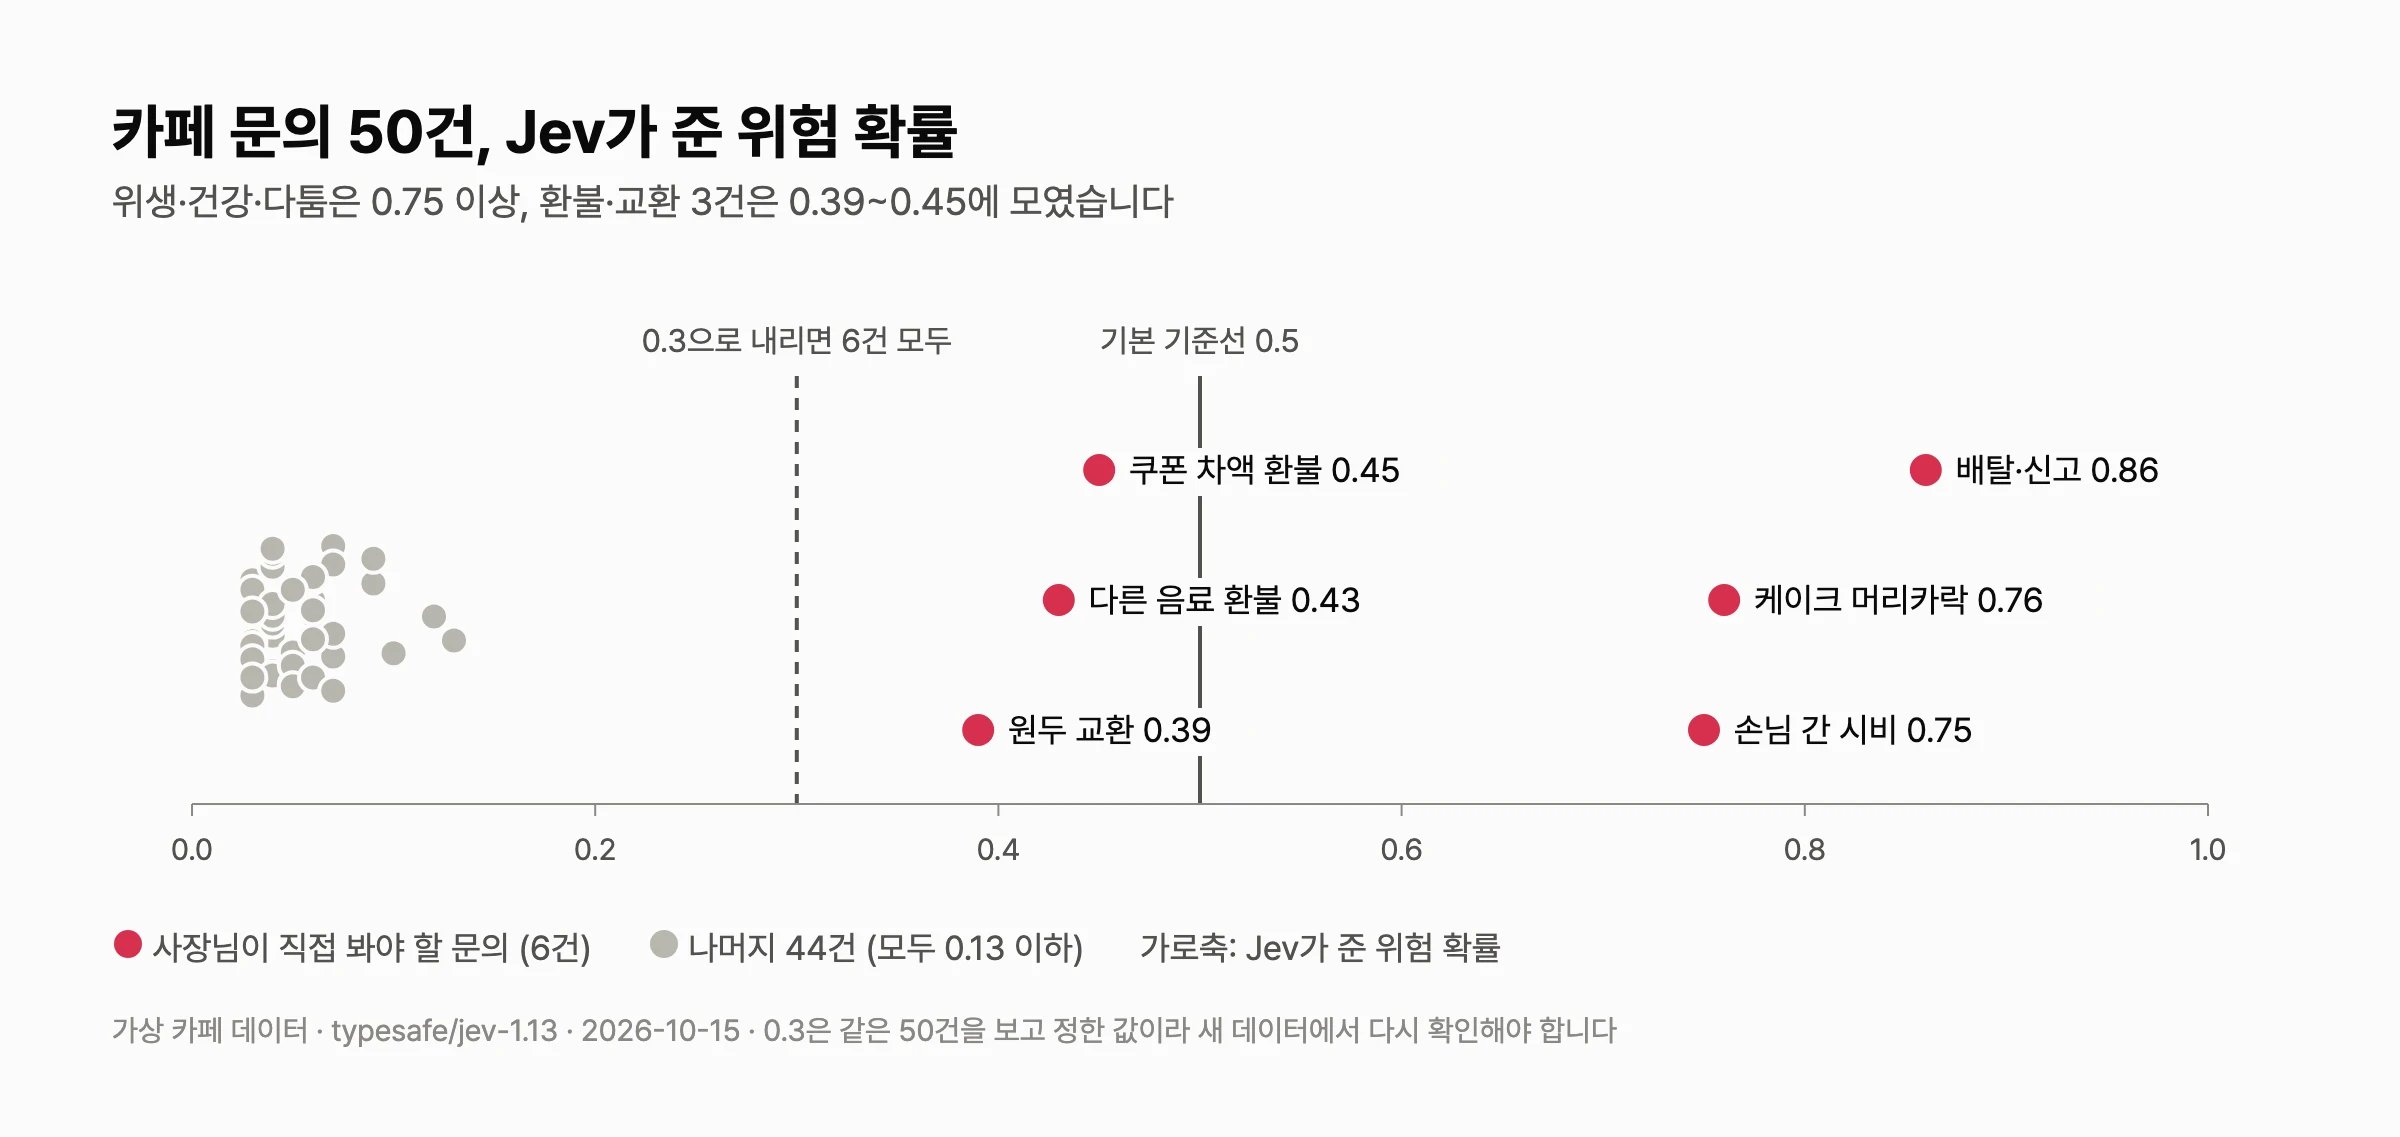
Jev는 위생·건강·다툼은 확실한 위험으로 봤고, 환불·교환은 "애매하다" 쪽에 뒀습니다. 위험하지 않은 44건은 모두 0.13 이하였기 때문에, 기준선을 0.5가 아니라 0.3으로 잡았다면 6건을 모두 잡고 잘못 올린 건도 0건이었습니다.
다만 이 0.3은 같은 50건을 보고 정한 숫자입니다. 새 리뷰에서도 이 선이 맞는지는 아직 모릅니다. 실제로 쓴다면 0.3~0.5 사이를 "사장님 확인" 구간으로 두고, 몇 주 동안 놓친 건이 없는지 보면서 기준선을 조정하는 방식이 맞습니다.
취준생 — 가장 잘 맞았고, 정답이 틀렸을 수도 있습니다
가상 이력서 하나(경영학과, 마케팅 인턴 6개월, SQL 기초, 서울·판교 통근)와 채용공고 30개를 주고 맞는 정도를 0~3단계 점수로 매겼습니다. 30개 중 21개가 정답과 같은 단계였고, 28개는 한 단계 이내였습니다. "잘 맞음"으로 본 공고 9개 중 8개가 Jev 점수 상위 9개에 들었고, 지원할 수 없는 공고(경력 3년 필수, 지방 근무 등)를 높게 친 경우는 없었습니다.
두 단계 이상 차이 난 공고는 2개였습니다. "게임 플레이 경험 필수"인 커뮤니티 매니저와 "경기 파주 근무"인 도서 마케터입니다. 정답은 둘 다 "보통"이었는데, Jev는 필수 조건을 못 채운다고 보고 낮은 점수를 줬습니다. 이력서에 게임 경험이 없고 파주는 통근 가능 지역에 없으니, Jev의 판단이 더 맞을 수도 있습니다.
공공기관 — 순서는 잘 정하고, 거리 계산은 틀렸습니다
Jev는 공식적으로 텍스트만 받습니다. 그래서 CCTV 이미지를 직접 넣지 않고, 비전 모델이 닮은 사람을 이미 골라 뒀다고 가정한 후보 표 40건을 만들었습니다. 각 후보에는 촬영 시각, 마지막 목격 지점에서의 거리, 외모 유사도, 맞는 옷차림, 보이는 행동이 들어 있습니다. 실종자는 시속 2km로 걷는 치매 어르신이고, 예전에 살던 북쪽 동네로 가려고 한 적이 있다고 설정했습니다.
비교 대상은 "외모 유사도가 높은 순서"입니다. 유사도로 상위 8명을 고르면 그중 4명이 시간상 그 자리에 있을 수 없는 사람이었습니다. 마지막 목격보다 이전에 찍혔거나, 15분 만에 3.8km를 가야 하는 경우입니다. Jev의 상위 8명에는 이런 후보가 0명이었고, 먼저 확인해야 할 정답 8명 중 6명이 들었습니다(유사도 순서는 4명).
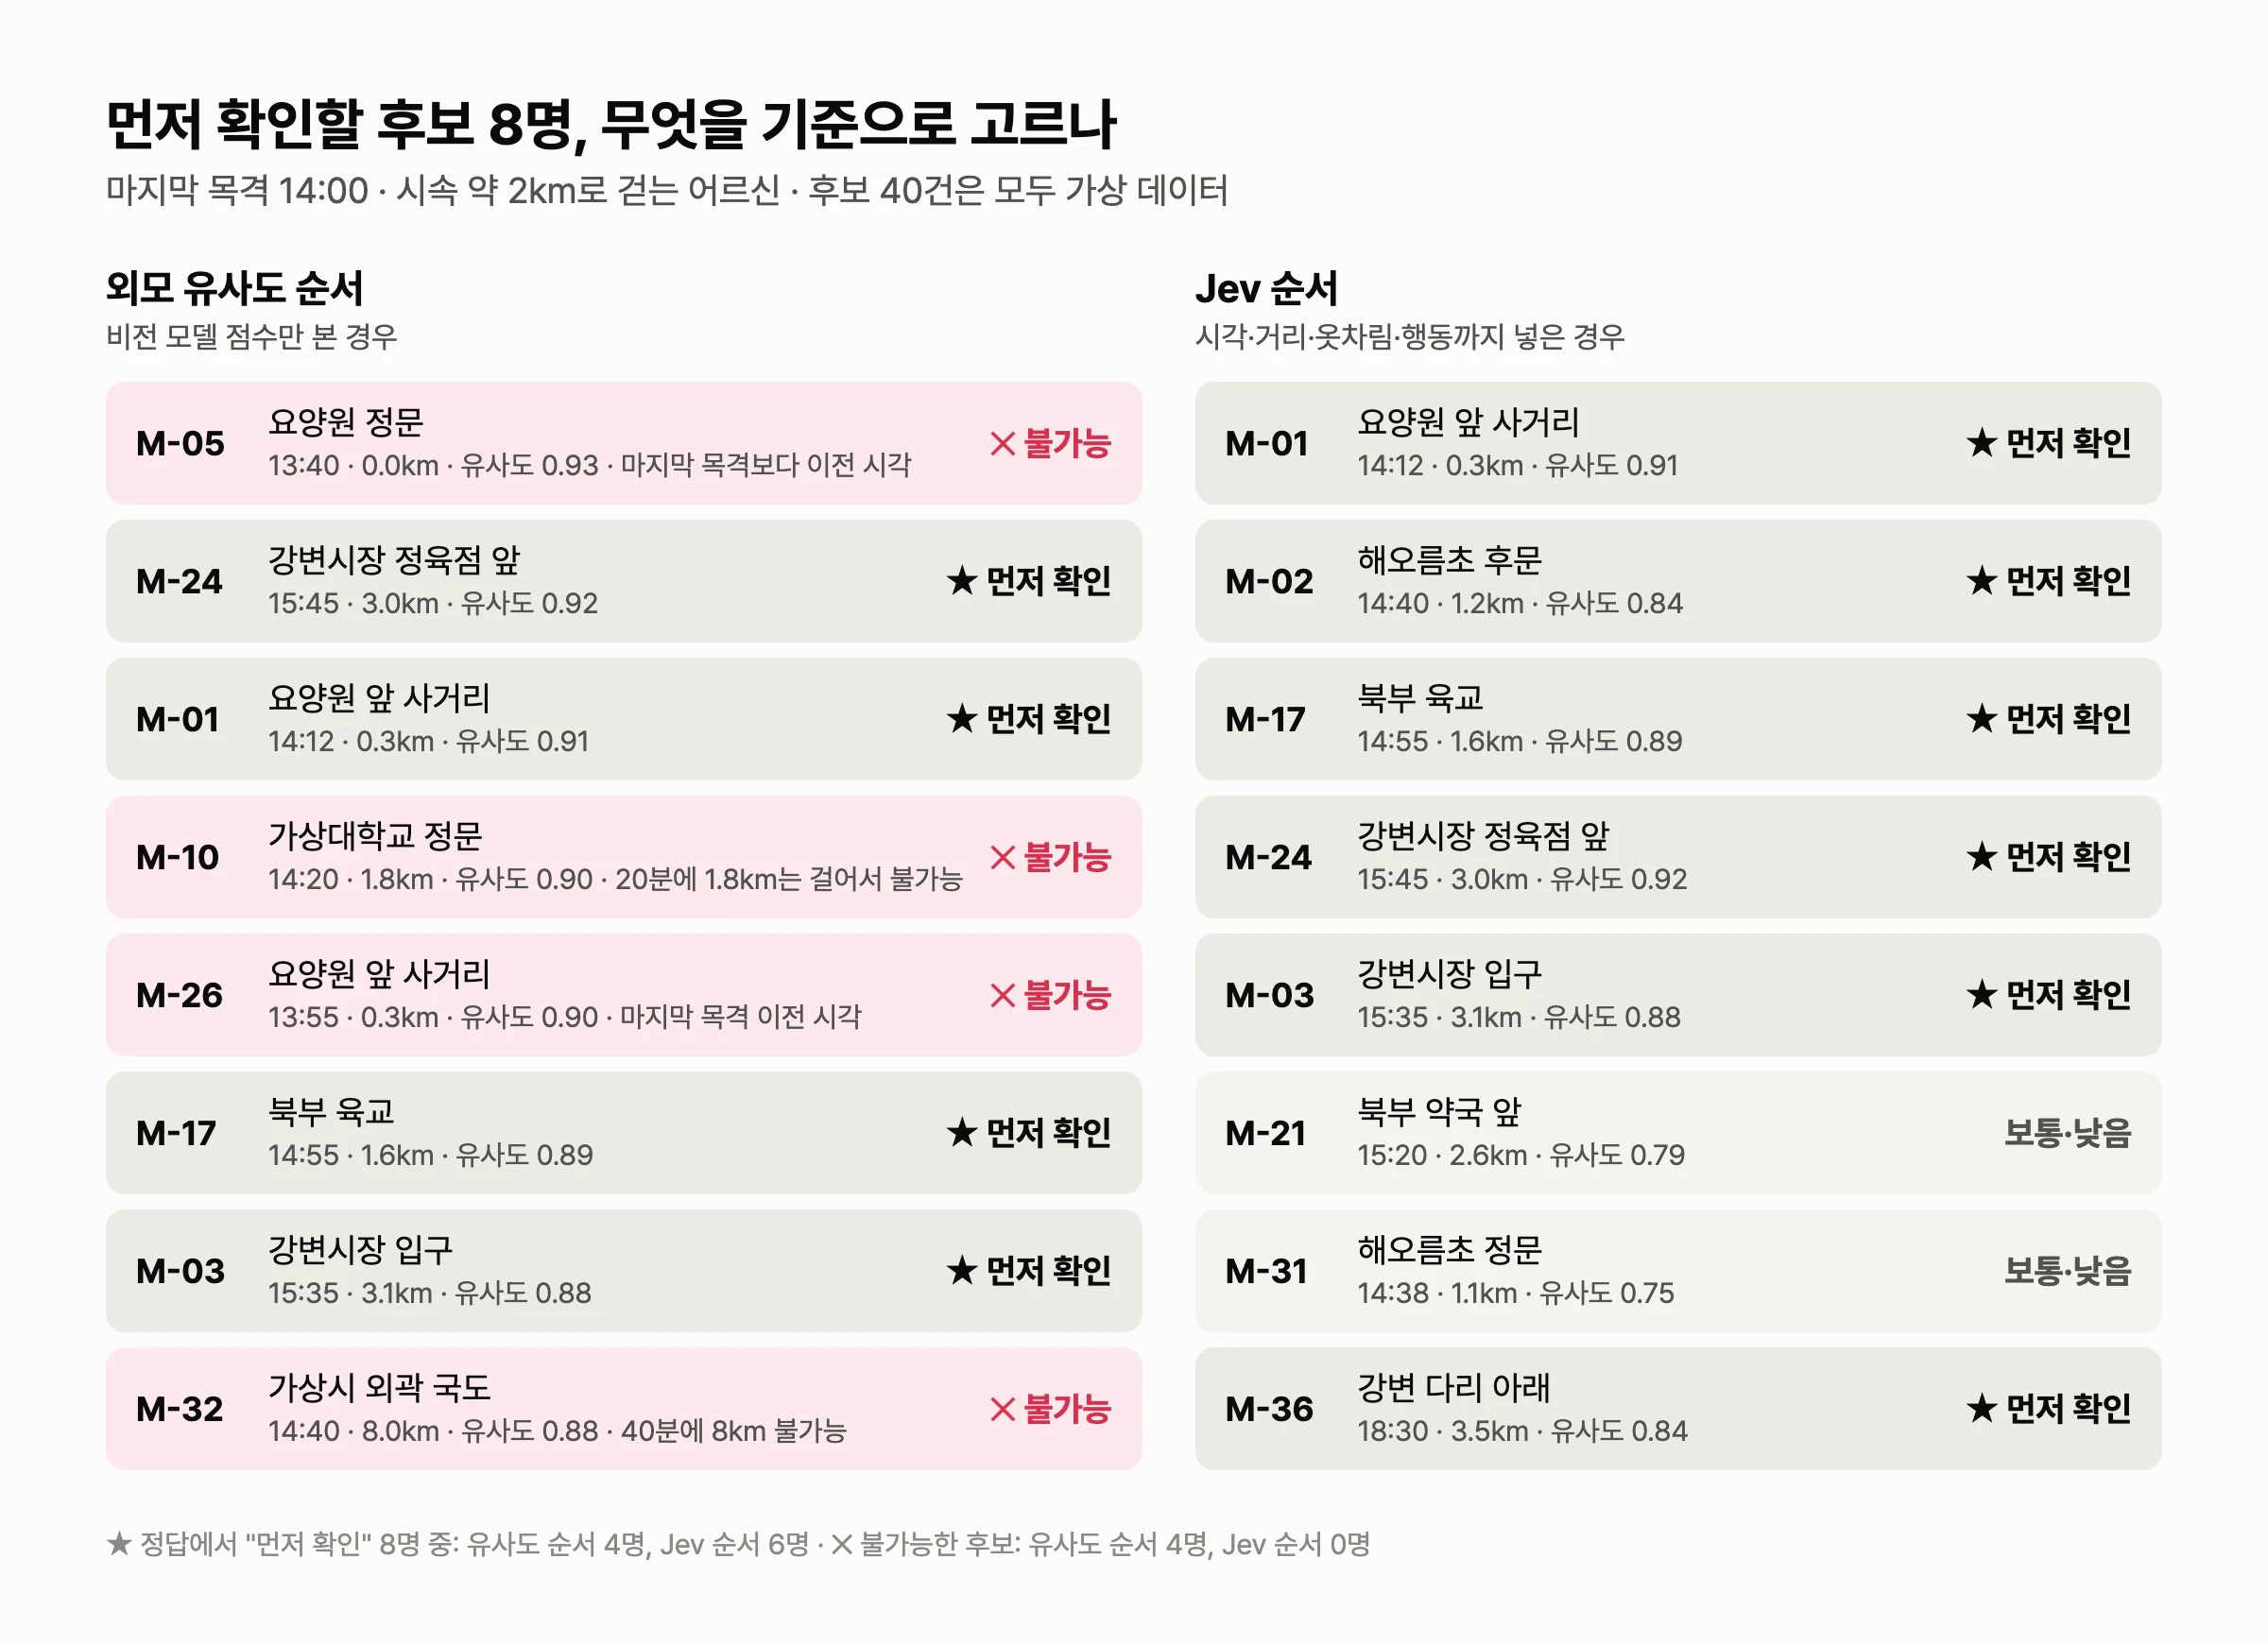
하지만 개별 판단에서는 거리 계산을 틀렸습니다. 20분에 2.8km를 걸어야 하는 후보에게 2.81점(거의 "먼저 확인")을 줬고, 시간·거리상 그 자리에 있을 수 없는 후보 6건을 "제외"가 아니라 1.5~2.8점으로 봤습니다. 순위가 잘 나온 건 다른 조건(옷차림, 방향, 행동)이 함께 작용했기 때문이지, 속도 계산을 제대로 해서가 아닙니다.
배운 점
계산은 코드로, 판단은 Jev로 나눕니다. "20분에 2.8km를 걸을 수 있나"는 나눗셈 한 번이면 끝나는 문제인데 Jev는 틀렸습니다. 해외 사례에서도 잘 만든 구성은 대부분 이렇게 나눕니다. 숫자 계산과 최종 결정은 코드가 하고, Jev는 사람이 문장으로 판단하던 부분만 맡습니다.
기준선은 데이터를 보고 정합니다. 카페 실험에서 0.5라는 기본 기준선이 위험 문의 절반을 놓치게 했습니다. 확률을 돌려준다는 건, 어디서 자를지를 사용자가 정해야 한다는 뜻이기도 합니다. 그러려면 정답이 붙은 데이터가 먼저 있어야 합니다.
선택지에 없는 건 억지로 고릅니다. 코인 사기 댓글은 스팸 선택지가 있었는데도 질문이 됐습니다. 글의 형식(질문하는 말투)에 끌려간 것으로 보입니다. 스팸처럼 놓치면 안 되는 항목은 분류 선택지에만 넣지 말고 "이 댓글이 다른 서비스나 코인을 홍보하는가"처럼 따로 묻는 편이 낫습니다.
정답지 만들기가 일의 대부분입니다. Jev를 돌리는 데는 실험당 10초도 안 걸렸습니다. 시간이 든 건 데이터를 모으고 정답을 붙이는 일이었고, 그 정답도 애매한 경우가 있었습니다. 이번 정답은 AI(Claude)로 붙였고, 사람이 한 건씩 다시 보지는 않았습니다.
한계도 분명합니다. 네 실험 모두 30~100건으로 작고, 세 개는 지어낸 데이터입니다. 한 번씩만 돌렸기 때문에 같은 데이터를 다시 돌렸을 때 답이 얼마나 바뀌는지도 재지 않았습니다.
다음 액션
- 카페 기준선 0.3을 새로 만든 리뷰 50건에 그대로 써서 놓친 건이 없는지 확인합니다
- 실종자 실험에서 시간·거리 조건을 코드로 먼저 거른 뒤 Jev에 넘기는 구성으로 다시 돌립니다
- 댓글 실험에 "홍보·사기인가"를 따로 묻는 질문을 추가하고, 정답을 사람이 다시 확인합니다
- Jev 1.14에서 실험 기능으로 열린 이미지 입력을 실종자 후보 확인에 써 볼 수 있는지 봅니다
다른 직군의 Jev 사례가 궁금하다면 Jev 활용 사례 — 따라 해 볼 3가지와 직군별 사례 37개에서 내 일과 비슷한 사례를 찾아볼 수 있습니다.