LLM에게 글을 쓰게 하지 않고 판단을 시킨다 — TypeSafe Jev 입문
AI를 자동화에 붙일 때 가장 어려운 부분은 문장을 생성하는 일이 아니라, 그 결과를 코드가 안전하게 다음 단계로 넘기는 일입니다. TypeSafe의 Jev는 자유로운 문장 대신 타입이 정해진 판단과 확률을 반환해, 고객 문의 분류·업무 라우팅·검증 같은 자동화의 조건문에 바로 연결하는 모델입니다.
배경 — 자동화에서 LLM의 답변을 다시 해석해야 하는 이유
고객 문의 하나를 자동 처리한다고 해보겠습니다.
Stripe 계정을 연결하려고 3일째 시도하고 있습니다.
연동이 계속 실패해서 매출에도 영향을 받고 있습니다.
가능하면 빨리 도와주세요.
이 문의를 기존 LLM에 넣으면 "기술팀에 전달하는 것이 좋겠습니다"처럼 자연어 답변을 받을 수 있습니다. 하지만 워크플로우가 실제로 필요한 값은 더 단순합니다.
- 담당 부서는
technical인가? - 문의가 긴급한가?
- 고객 불만도는 어느 수준인가?
- 자동 처리해도 될 만큼 확신하는가?
자연어 답변을 코드에서 사용하려면 결과를 다시 파싱해야 합니다. 모델이 표현을 바꾸거나, 선택지에 없는 값을 만들거나, 설명을 덧붙이면 예외 처리가 필요해집니다.
Jev는 이 문제를 출력 형식부터 다르게 설계합니다. TypeSafe는 Jev를 첫 번째 System One 모델로 소개하면서, 구조화된 상태와 질문을 입력받아 소프트웨어가 사용할 수 있는 타입이 있는 판단을 반환한다고 설명합니다. 자세한 내용은 TypeSafe의 공식 발표에서 확인할 수 있습니다.
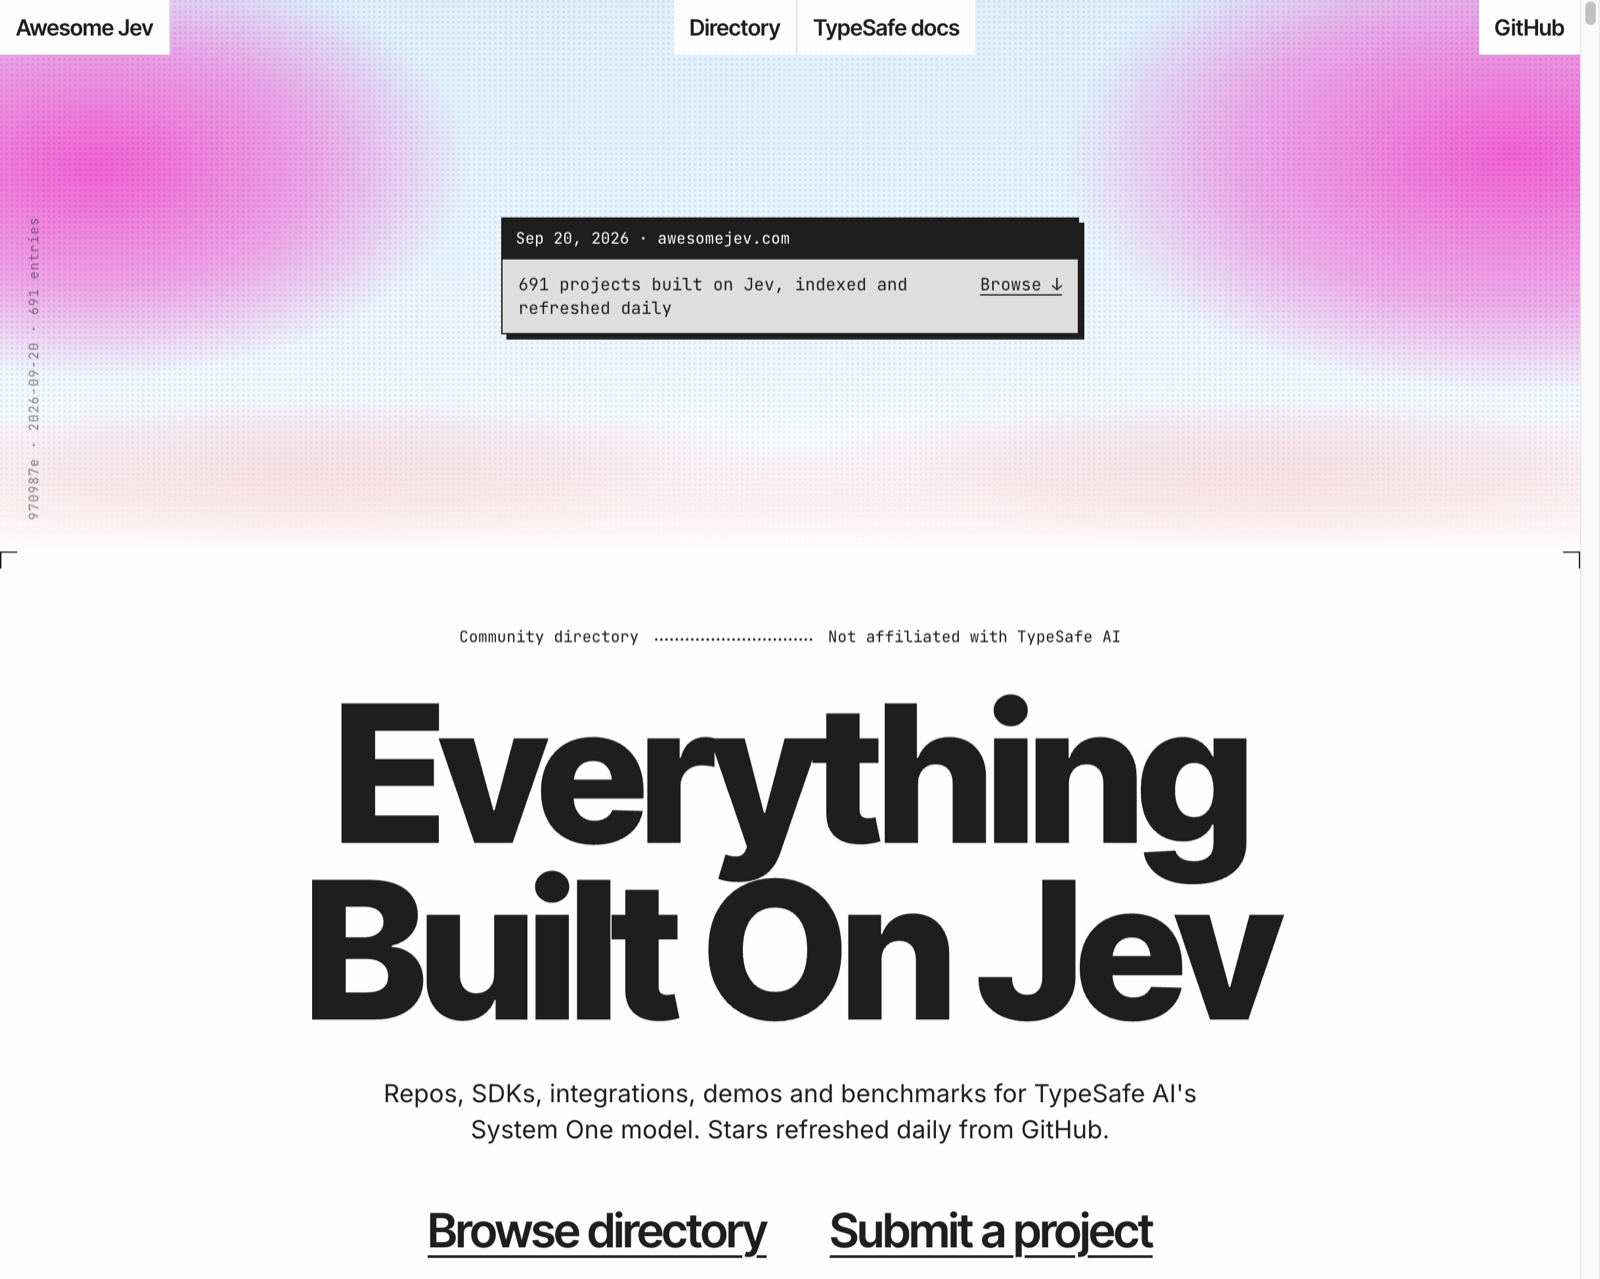
출처: Awesome Jev. Jev의 API 엔드포인트, typed questions, 출력 형태, 지연 시간과 가격 정보를 한 화면에서 확인할 수 있습니다.
Jev는 일반 LLM과 무엇이 다른가요?
일반적인 LLM의 기본 흐름은 다음과 같습니다.
입력된 텍스트 → 생성된 텍스트
Jev의 흐름은 조금 다릅니다.
상태 + 질문 정의 → 타입이 있는 답변 + 확률 + 신뢰도
| 구분 | 일반적인 LLM | Jev |
|---|---|---|
| 주요 출력 | 자연어 문자열 | Choice, Score, Noul 형태의 구조화된 값 |
| 처리 방식 | 토큰을 순차적으로 생성 | 여러 판단을 병렬로 처리하도록 설계 |
| 불확실성 | 별도로 요청하거나 직접 해석 | 확률과 신뢰도를 함께 반환 |
| 잘 맞는 작업 | 대화, 글쓰기, 코드 생성 | 분류, 라우팅, 평가, 검증 |
| 코드 연결 | 결과 파싱과 예외 처리가 필요 | 반환된 값을 조건문과 워크플로우에서 직접 사용 |
TypeSafe의 공식 발표는 Jev의 호출 지연 시간을 70~500ms, 입력 비용을 100만 토큰당 0.042달러로 제시합니다. 이 수치는 공식 발표 기준이며, 실제 서비스에서는 네트워크와 요청 크기에 따라 달라질 수 있습니다.
중요한 점은 Jev가 모든 LLM을 대체한다는 뜻이 아니라는 것입니다. 글을 쓰거나 코드를 생성하거나 긴 설명을 만드는 일은 일반 LLM이 더 적합합니다. Jev는 사람이 코드로 작성하려면 너무 딱딱하지만, 자연어로 맡기기에는 결과 형식이 중요한 판단을 담당합니다.
세 가지 질문 타입으로 판단을 정의합니다
TypeSafe 문서에서 Jev의 기본 질문 타입은 Choice, Score, Noul 세 가지입니다. 각 질문은 같은 상태를 보고 독립적으로 평가하며, 답변은 코드에서 조합할 수 있는 구조로 돌아옵니다. 자세한 설명은 Primitives 문서에 정리되어 있습니다.
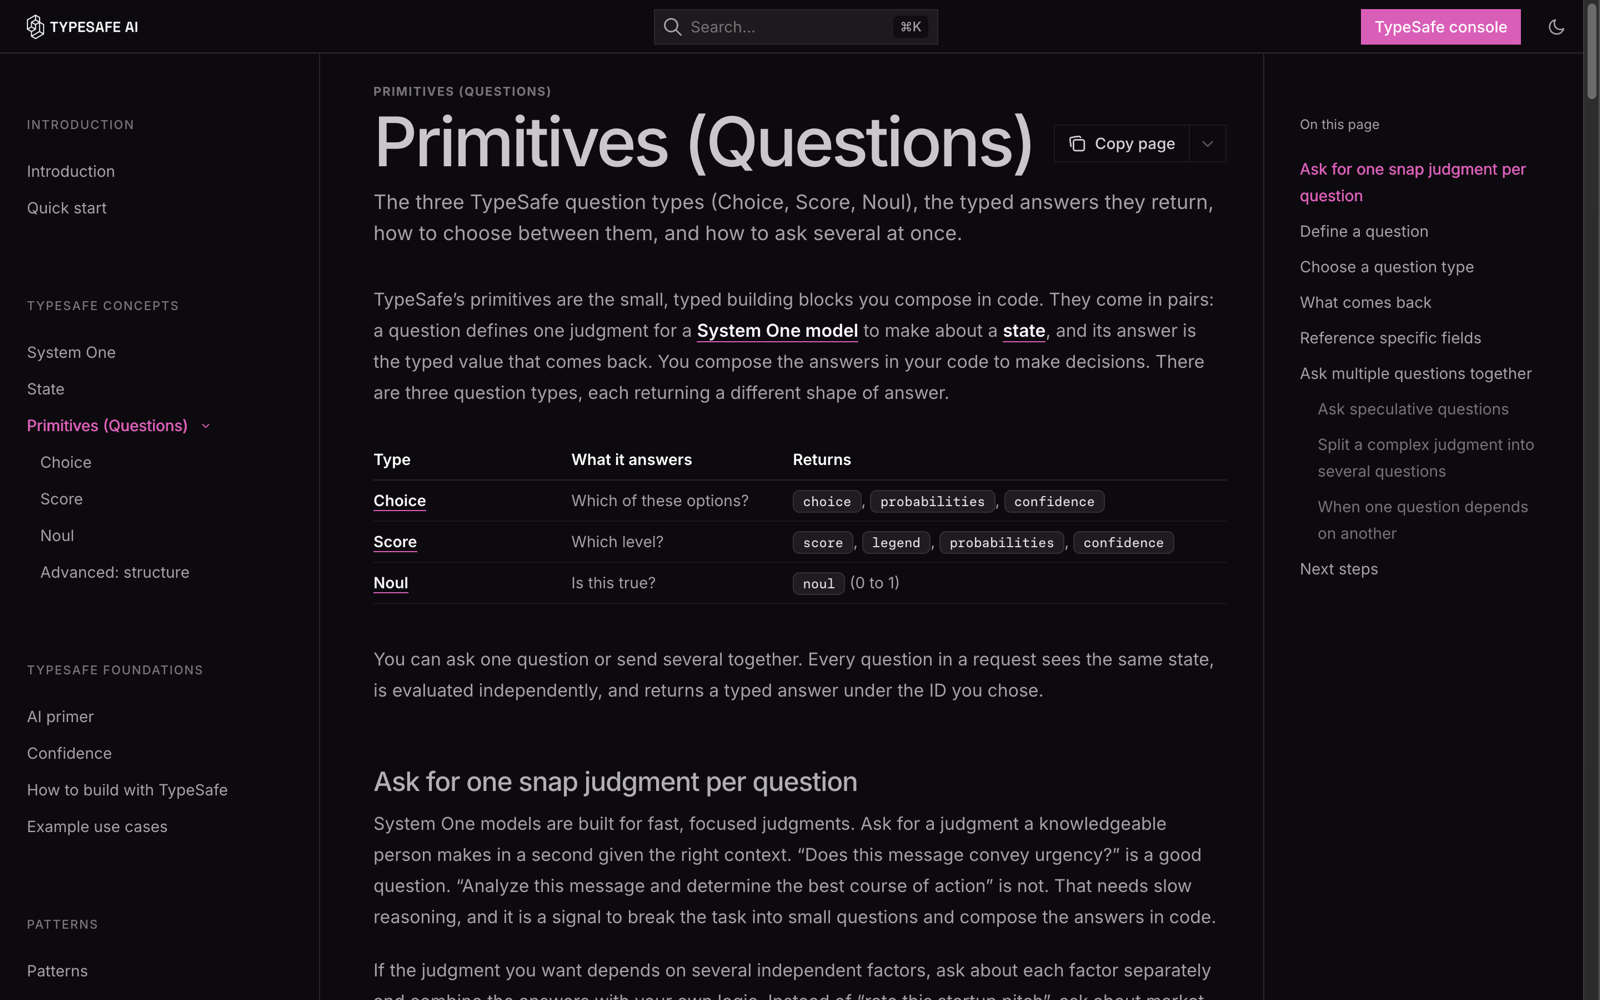
출처: TypeSafe Primitives. Choice, Score, Noul이 각각 어떤 질문과 답변 형태를 갖는지 보여주는 공식 문서 화면입니다.
Choice — 여러 선택지 중 하나 고르기
담당 부서, 문서 종류, 문의 목적처럼 정해진 선택지 중 하나를 골라야 할 때 사용합니다.
Choice(
    instructions="이 고객 문의를 어느 팀이 처리해야 하나요?",
    criteria={
        "billing": "결제 또는 구독 문제",
        "technical": "버그 또는 연동 문제",
        "sales": "가격 또는 계정 문의",
    },
)
Score — 기준에 따라 수준을 평가하기
고객 불만도, 버그 심각도, 리드 품질처럼 순서가 있는 단계로 평가할 때 사용합니다.
Score(
    instructions="고객은 얼마나 불만스러워 보이나요?",
    criteria=[
        "차분하고 중립적임",
        "걱정하고 있지만 예의 바름",
        "매우 화가 났거나 강한 표현을 사용함",
    ],
)
Noul — 어떤 문장이 사실일 확률 구하기
참과 거짓에 가까운 판단에는 Noul을 사용합니다.
Noul(
    instructions="이 문의는 긴급함을 표현하고 있나요?",
)
결과는 0에서 1 사이의 값입니다. 0.9라면 질문의 내용이 참일 가능성이 높다는 뜻이고, 0.5라면 판단이 불확실하다는 뜻입니다. 0.5가 중간 점수라는 의미는 아니므로, 능력이나 감정의 정도를 평가할 때는 Score가 더 적합합니다.
Python에서 여러 판단을 한 번에 요청하기
공식 Python SDK를 사용하면 하나의 상태에 대해 여러 질문을 함께 보낼 수 있습니다.
pip install typesafe-sdk
from typesafe_sdk import Choice, Noul, Score, TypeSafeClient

ticket = """
Stripe 계정을 연결하려고 3일째 시도하고 있습니다.
연동이 계속 실패해서 매출에도 영향을 받고 있습니다.
가능하면 빨리 도와주세요.
"""

client = TypeSafeClient()

response = client.system_one(
    state=ticket,
    questions={
        "department": Choice(
            instructions="이 문의는 어느 팀이 처리해야 하나요?",
            criteria={
                "billing": "결제 또는 구독 문제",
                "technical": "버그 또는 연동 문제",
                "sales": "가격 또는 계정 문의",
            },
        ),
        "frustration": Score(
            instructions="고객은 얼마나 불만스러워 보이나요?",
            criteria=[
                "차분하고 중립적임",
                "걱정하고 있지만 예의 바름",
                "매우 화가 났거나 강한 표현을 사용함",
            ],
        ),
        "is_urgent": Noul(
            instructions="이 문의는 긴급함을 표현하고 있나요?",
        ),
    },
)

print(response.answers["department"].choice)
print(response.answers["department"].confidence)
print(response.answers["is_urgent"].noul)
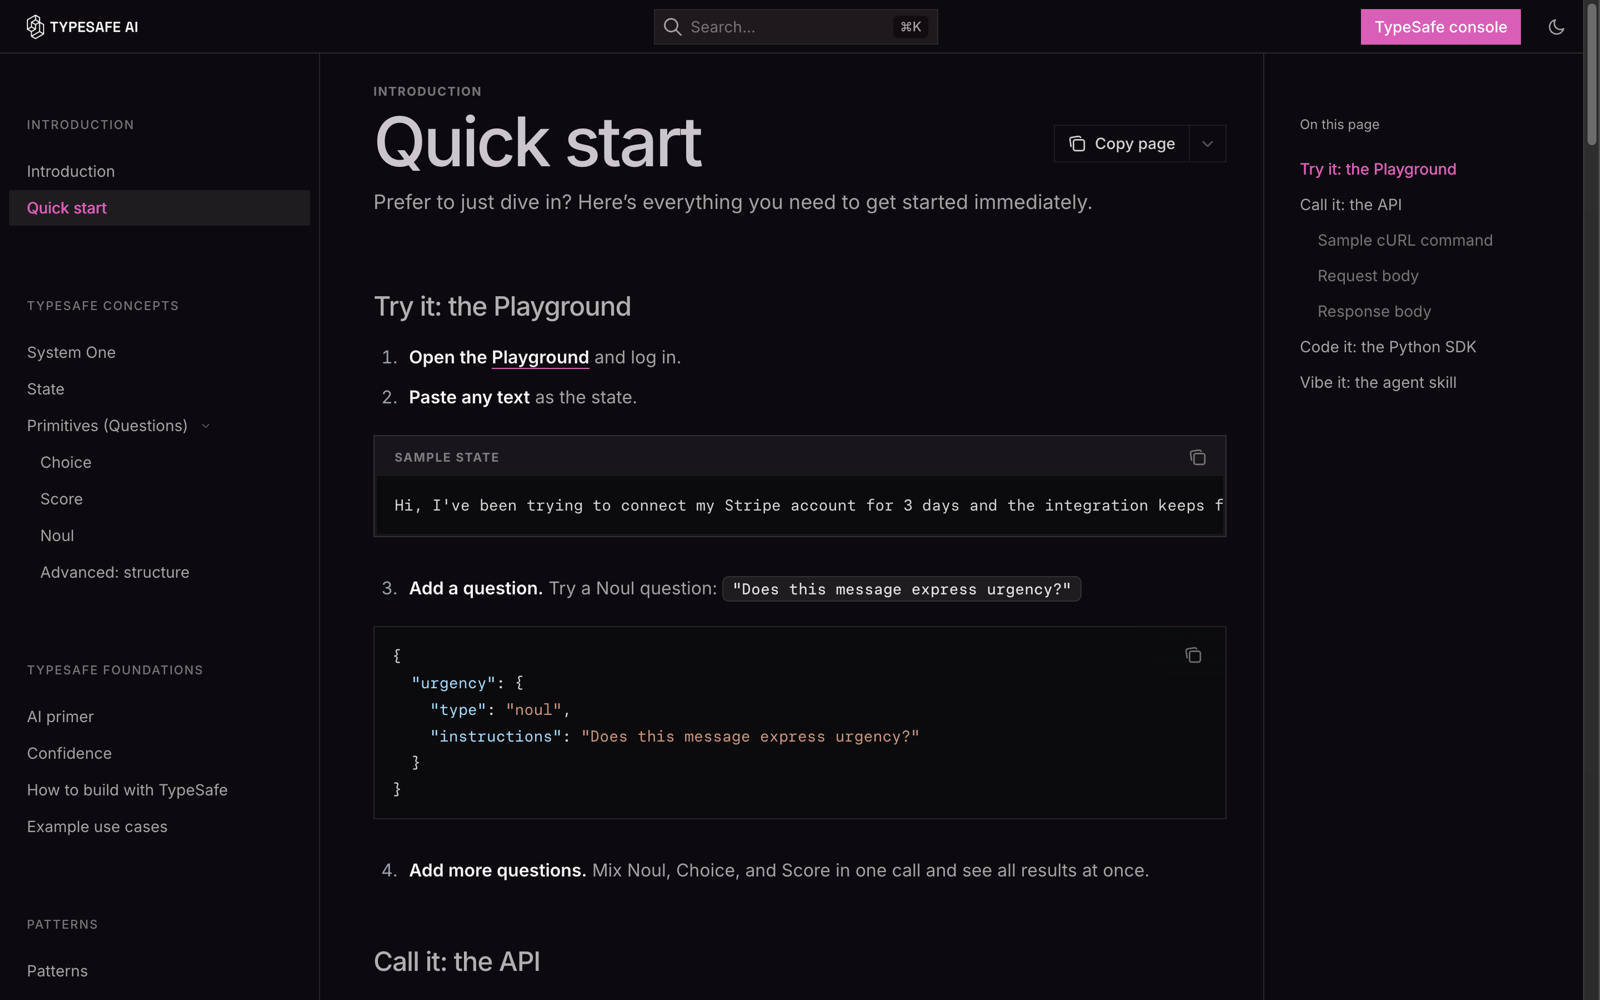
출처: TypeSafe Quick Start. 같은 상태에 Noul, Choice, Score 질문을 함께 보내고 typed answer를 받는 흐름을 보여줍니다.
여기서 중요한 부분은 질문 세 개를 각각 별도의 API 호출로 보내지 않았다는 점입니다. 같은 상태를 기준으로 독립적인 판단을 여러 개 요청하고, 코드에서 필요한 결과만 사용합니다.
TypeSafe는 이 방식을 활용해 여러 질문을 한 번에 보내는 Speculative Fan-Out 패턴과, 여러 평가값을 조합하는 Composite Scoring 패턴을 제안합니다. 관련 패턴은 공식 Patterns 문서에서 확인할 수 있습니다.
신뢰도를 자동화의 두 번째 조건으로 사용하기
선택 결과만 확인하면 AI가 확신하지 못한 판단도 그대로 자동 처리할 수 있습니다. 조건문에 신뢰도를 함께 넣으면 불확실한 요청을 사람에게 넘기는 구조를 만들 수 있습니다.
department = response.answers["department"]

if (
    department.choice == "technical"
    and department.confidence >= 0.75
):
    route_to_engineering()
else:
    send_to_human_review()
이 구조에서 AI는 최종 결정을 독점하지 않습니다. 판단 결과와 확신 정도를 제공하고, 실제 실행 여부는 주변 코드가 결정합니다.
이런 Confidence-Gated Routing은 고객 문의 라우팅뿐 아니라 자동 승인, 콘텐츠 검수, 다른 LLM의 응답 검증에도 적용할 수 있습니다. 신뢰도가 낮을 때 사람에게 넘기는 경로를 처음부터 설계하는 것이 핵심입니다.
어떤 자동화에 잘 맞을까요?
Jev는 다음과 같은 작업에 특히 잘 어울립니다.
- 고객 문의 자동 분류와 담당 부서 라우팅
- 문서 유형과 요청 목적 분류
- 개인정보 또는 민감정보 포함 여부 확인
- 고객 불만도와 긴급도 평가
- 리드 품질 점수화
- 다른 LLM이 작성한 답변의 정책 위반 여부 확인
- AI Agent가 다음에 사용할 도구 선택
- 자동 처리와 사람 검토 사이의 분기
- 대량 데이터에 대한 병렬 평가
실제로 Awesome Jev 커뮤니티 디렉터리에는 공식 SDK뿐 아니라 브라우저 자동화, Claude Code 플러그인, 여러 언어의 클라이언트, 에이전트 도구 등 다양한 프로젝트가 정리되어 있습니다.
Jev가 아직 적합하지 않은 작업
Jev를 사용할 때는 “AI에게 무엇이든 시킨다”보다 “이 판단을 타입으로 정의할 수 있는가?”를 먼저 확인하는 편이 좋습니다.
다음 작업에는 일반 LLM이 더 적합합니다.
- 블로그 글 작성
- 긴 문서 요약
- 자연스러운 대화
- 코드 생성
- 창작 작업
- 자유로운 형식의 설명
- 복잡한 다단계 추론
또한 타입이 올바르게 반환된다고 해서 의미까지 항상 옳다는 뜻은 아닙니다. 질문이 모호하거나 기준이 잘못 정의되어 있으면, 형식은 정상이어도 판단 자체가 틀릴 수 있습니다.
그래서 Jev를 사용할 때는 다음 순서가 중요합니다.
좋은 질문을 만든다
→ 독립적인 판단으로 나눈다
→ 여러 결과를 코드에서 조합한다
→ 확신이 낮으면 사람에게 넘긴다
결론 — Jev는 대화 상대보다 판단 함수에 가깝습니다
Jev의 가장 흥미로운 점은 AI를 “대화 상대”가 아니라 “판단 함수”로 바라본다는 데 있습니다.
기존 LLM 중심의 자동화는 다음과 같은 과정을 거치는 경우가 많습니다.
사용자 입력
→ LLM에게 분석 요청
→ 자연어 응답
→ 응답 파싱
→ 예외 처리
→ 다음 작업 실행
Jev를 활용하면 구조가 이렇게 바뀝니다.
상태
→ 판단 질문 여러 개
→ 타입이 있는 결과와 확률
→ 일반 코드의 조건문과 워크플로우
자유롭게 말할 수 있는 범위를 줄이는 대신, 소프트웨어가 결과를 더 쉽게 통제할 수 있게 만드는 접근입니다. Jev는 현재 초기 공개 단계이므로 실제 업무에 적용할 때는 작은 라우팅이나 검증 작업부터 시작하고, 오판 사례와 사람 검토 비율을 함께 기록하는 것이 좋습니다.
LLM이 생성해야 할 문장과 Jev가 판단해야 할 조건을 나누기 시작하면, AI 자동화 시스템을 더 빠르고 예측 가능하게 설계할 수 있습니다.
다음 액션
처음 시도한다면 고객 문의나 문서 하나를 상태로 넣고, 다음 세 질문을 한 번에 보내보는 것을 권합니다.
- 이 요청의 유형은 무엇인가? → Choice
- 얼마나 긴급하거나 심각한가? → Score
- 사람이 반드시 검토해야 하는 조건인가? → Noul
그 결과를 바로 실행에 연결하지 말고, 먼저 기존 사람이 내린 판단과 비교해보세요. 어떤 질문에서 의견이 갈리는지 확인한 뒤 기준을 다듬으면 Jev를 단순한 분류기가 아니라 실제 워크플로우의 판단 레이어로 사용할 수 있습니다.