
침착맨 댓글 2,153개, 키워드 룰로 충분할까 Jev가 필요할까
이 글과 연결된 글 보기
드래그로 이동 · 휠/두 손가락으로 확대 · 방향키로 글 선택 · 0으로 맞춤. 실선: 본문 링크, 점선: 시리즈·주제의 대표 연결.표시된 글 11편 목록
침착맨 유튜브 댓글 2,153개로 판단 AI Jev와 단순한 규칙(룰)을 맞붙여 봤습니다. 쇼츠로 쓸 장면을 짚은 댓글과 제작진이 지워야 할 댓글을 골라내는 실험입니다. 농담과 밈이 많은 채널이라, 단어만 보는 룰보다 뜻을 읽는 Jev가 훨씬 잘할 거라고 예상했습니다.
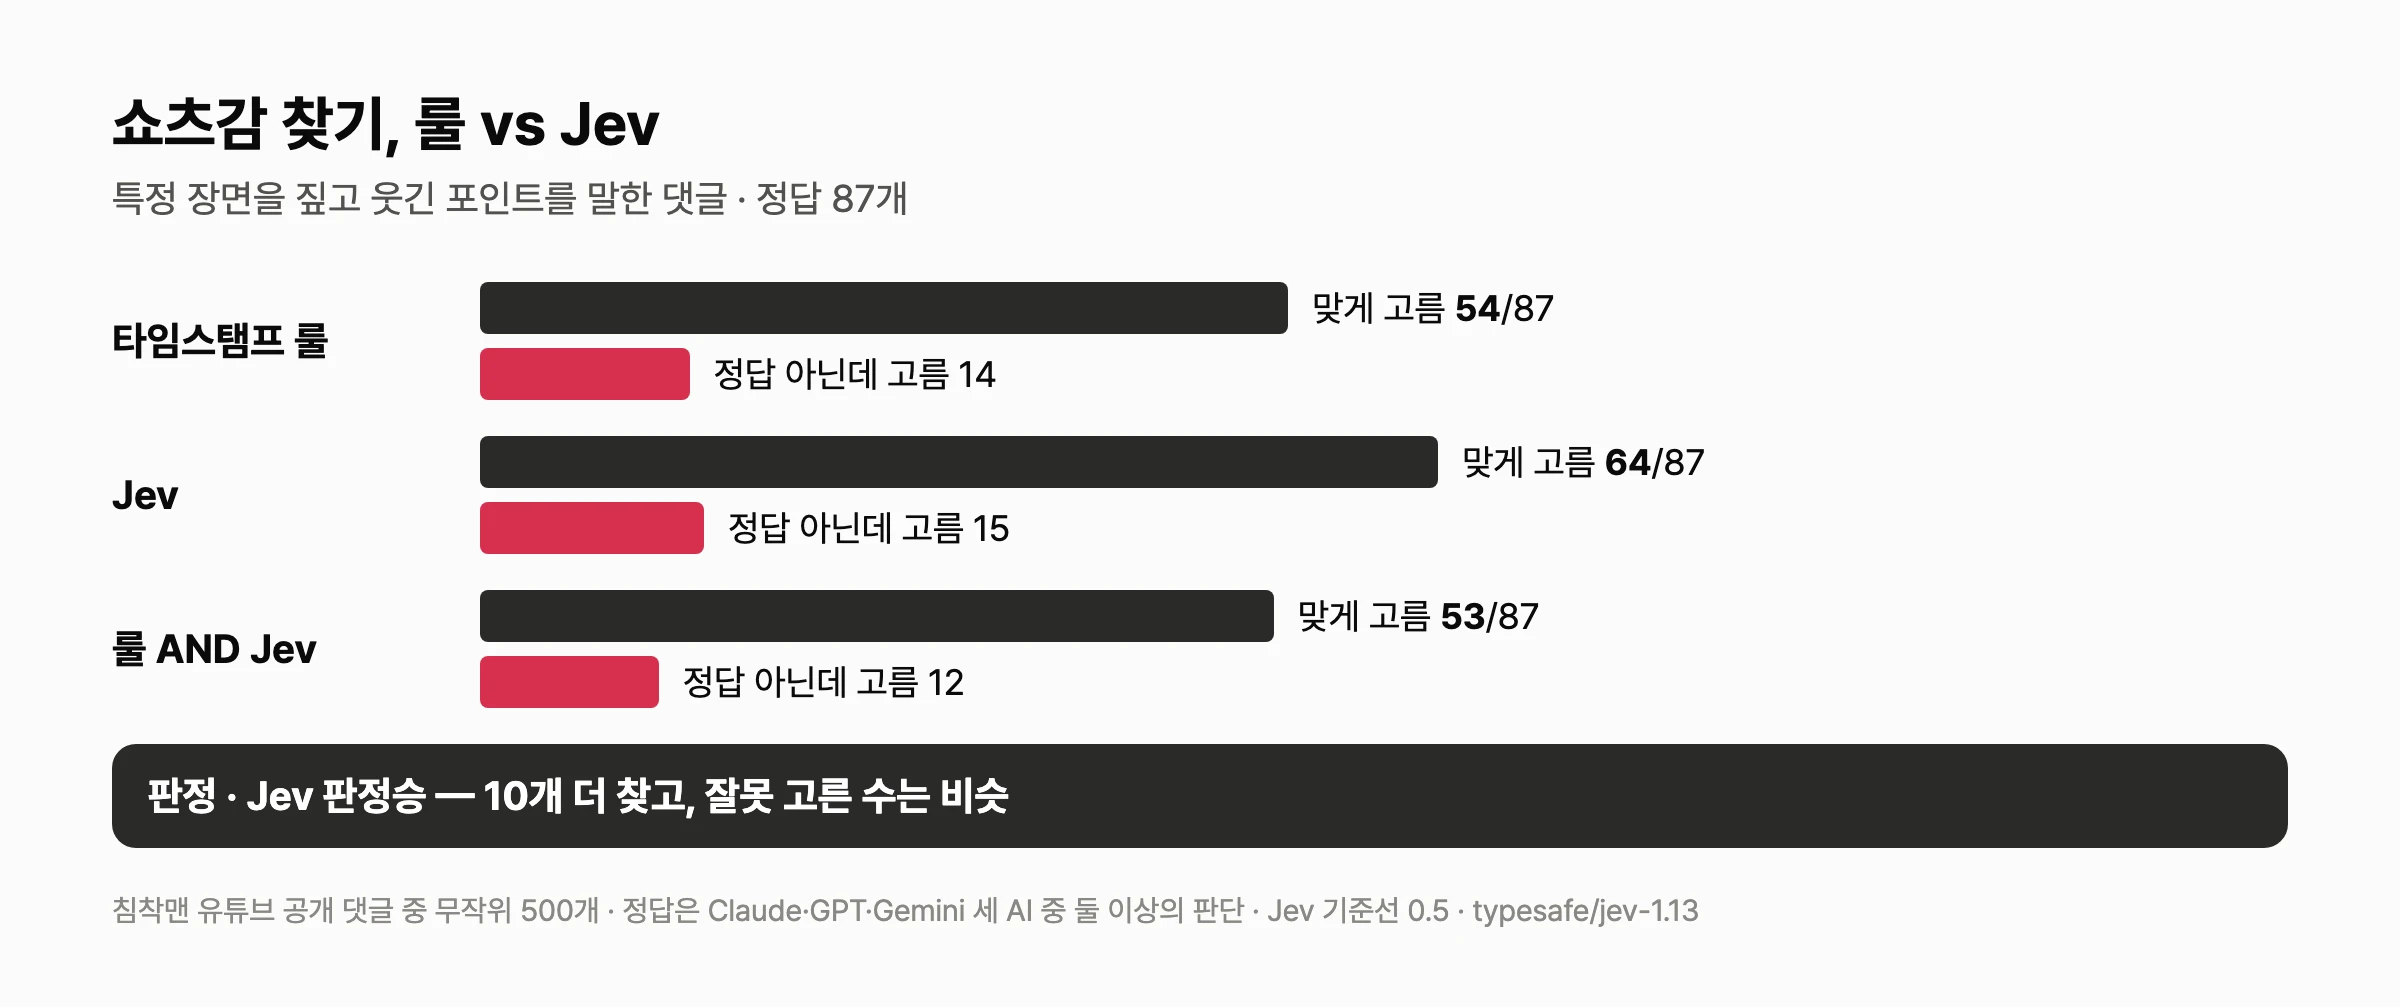
결과는 예상과 달랐습니다. 쇼츠감 찾기는 타임스탬프 룰 한 줄이 꽤 버텨서 Jev가 조금 앞서는 데 그쳤고(정답 87개 중 룰 54개, Jev 64개), 지워야 할 댓글은 이미 걸러진 공개 댓글이라 추릴 게 별로 없었습니다. 비하처럼 보이는 말도 대부분 시청자의 장난이었습니다. 분명했던 건 비용입니다. 같은 일을 일반 AI에 맡기면 27배에서 84배가 들었습니다.
배경 — AI를 붙이기 전에 룰로 되는지부터
댓글·카페 리뷰·채용공고·실종자 후보 220건 실험에서 Jev가 "입력은 LLM처럼, 출력은 룰처럼" 동작한다는 걸 확인했습니다. 자유로운 문장을 읽지만, 답은 정해진 선택지와 확률로만 나옵니다. 그래서 이번에는 같은 일을 룰에게도 시켜 보고 차이를 쟀습니다.
데이터는 침착맨 채널의 최근 영상 5개(10월 10일부터 14일까지)에 달린 공개 댓글 2,153개입니다. 이 실험은 침착맨 채널의 요청이나 협업 없이 진행했습니다. 누구나 볼 수 있는 공개 댓글만 썼고, 댓글 작성자 정보는 저장하지 않았습니다.
어떻게 겨뤘나 — 룰 한 줄과 Jev 질문 하나
미션은 "27:51 우유는 씹어먹으라 그래서 진짜 씹어먹음"처럼 특정 장면을 짚고 웃긴 포인트를 말한 댓글을 찾는 것입니다. 편집자가 쇼츠로 자를 구간을 고를 때 쓸 수 있는 댓글입니다.
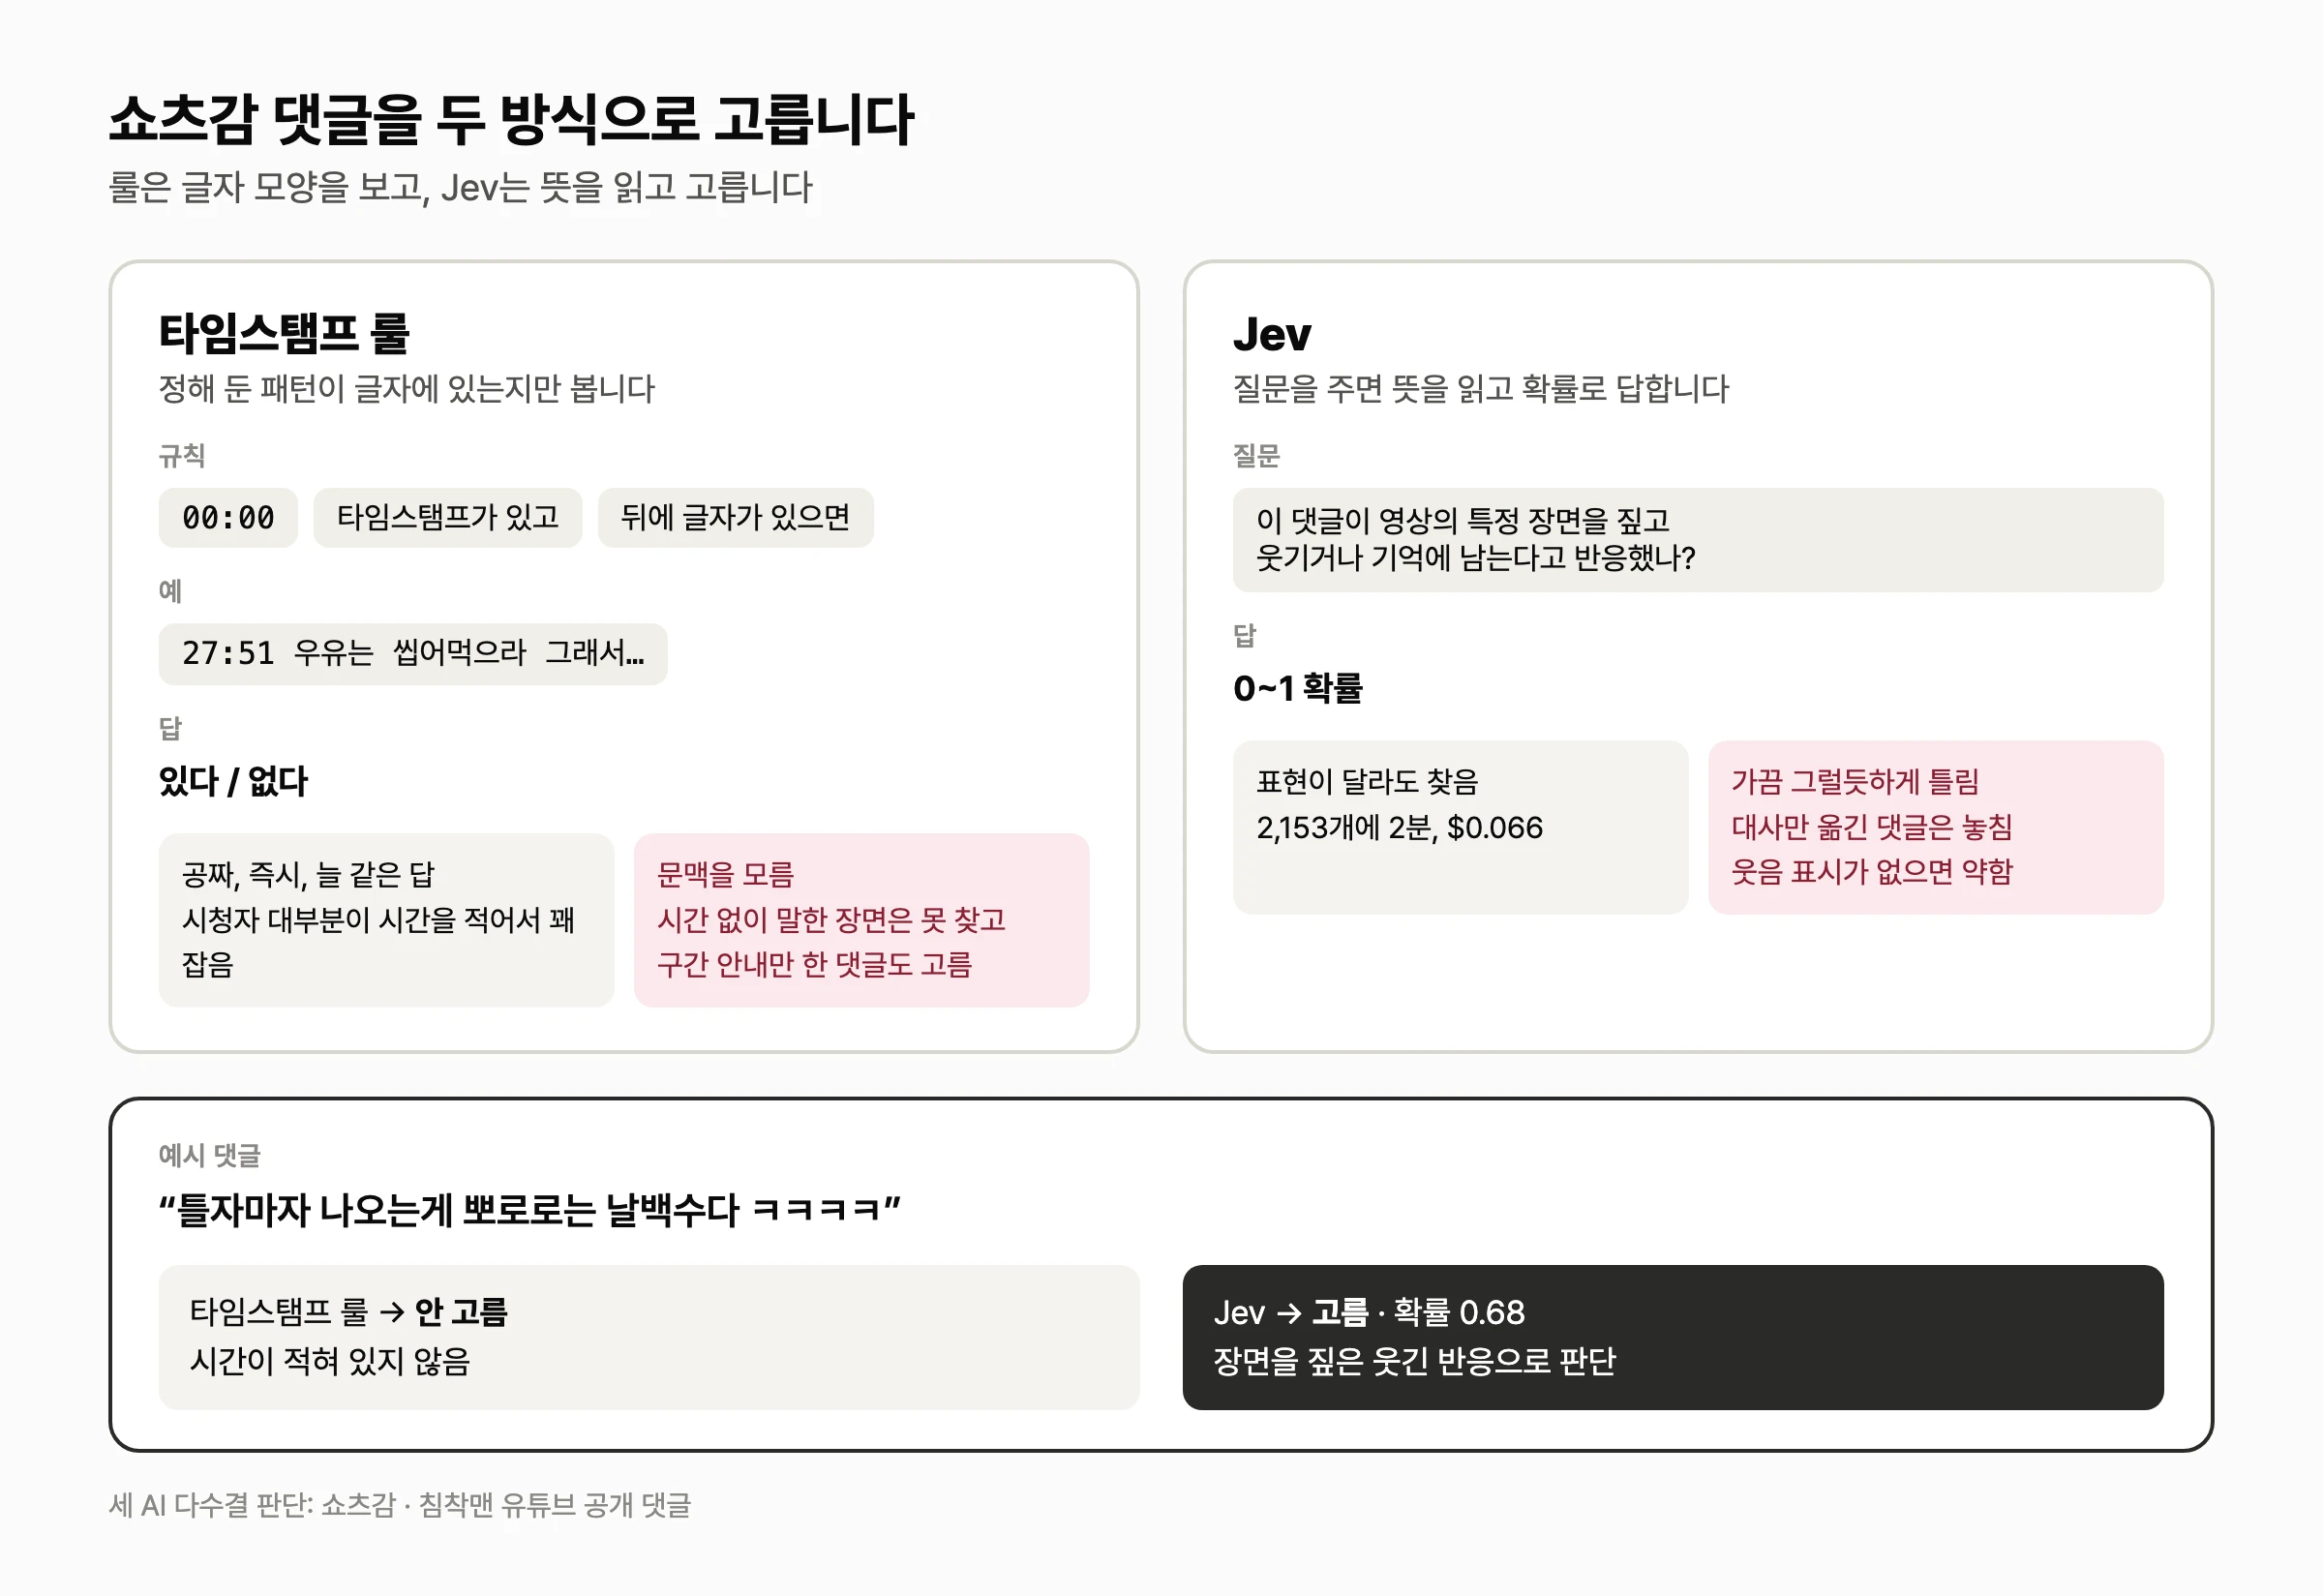
룰은 타임스탬프 뒤에 글자가 있으면 쇼츠 후보로 봤습니다. Jev에는 같은 댓글을 주고 "특정 장면을 짚고 웃기거나 기억에 남는다고 반응했나?"를 물었습니다. 2,153개 전부를 8개씩 병렬로 보내 118초, $0.066이 들었습니다. 모델은 OpenRouter의 typesafe/jev-1.13입니다.
룰 코드 보기
TS = re.compile(r"\b\d{1,2}:\d{2}(?::\d{2})?\b")
shorts = TS.search(text) and len(TS.sub("", text).strip()) >= 2
정답은 세 AI가 매겼습니다. "쇼츠감인가"에는 원래 정해진 정답이 없습니다. 그래서 무작위로 뽑은 댓글 500개를 Claude Sonnet 5.5, GPT-5.5, Gemini 3.5 Flash 세 AI에게 같은 기준으로 판단시키고, 둘 이상이 고른 댓글을 정답으로 삼았습니다. 세 AI의 판단이 모두 같았던 비율은 92%였습니다. 사람이 붙인 정답이 아니라는 점은 감안하고 읽어 주세요.
결과 — Jev 판정승
정답 87개 중 룰은 54개, Jev는 64개를 찾았습니다. 정답이 아닌데 고른 댓글은 룰이 14개, Jev가 15개로 거의 같았습니다. 타임스탬프 룰 한 줄이 생각보다 잘 버텼지만, 같은 실수 수에서 10개를 더 찾은 Jev가 조금 앞섰습니다. 둘을 겹쳐 "룰이 고르고 Jev도 0.3 이상 준 것"만 남기면 53개를 찾고 12개만 더 골랐습니다.
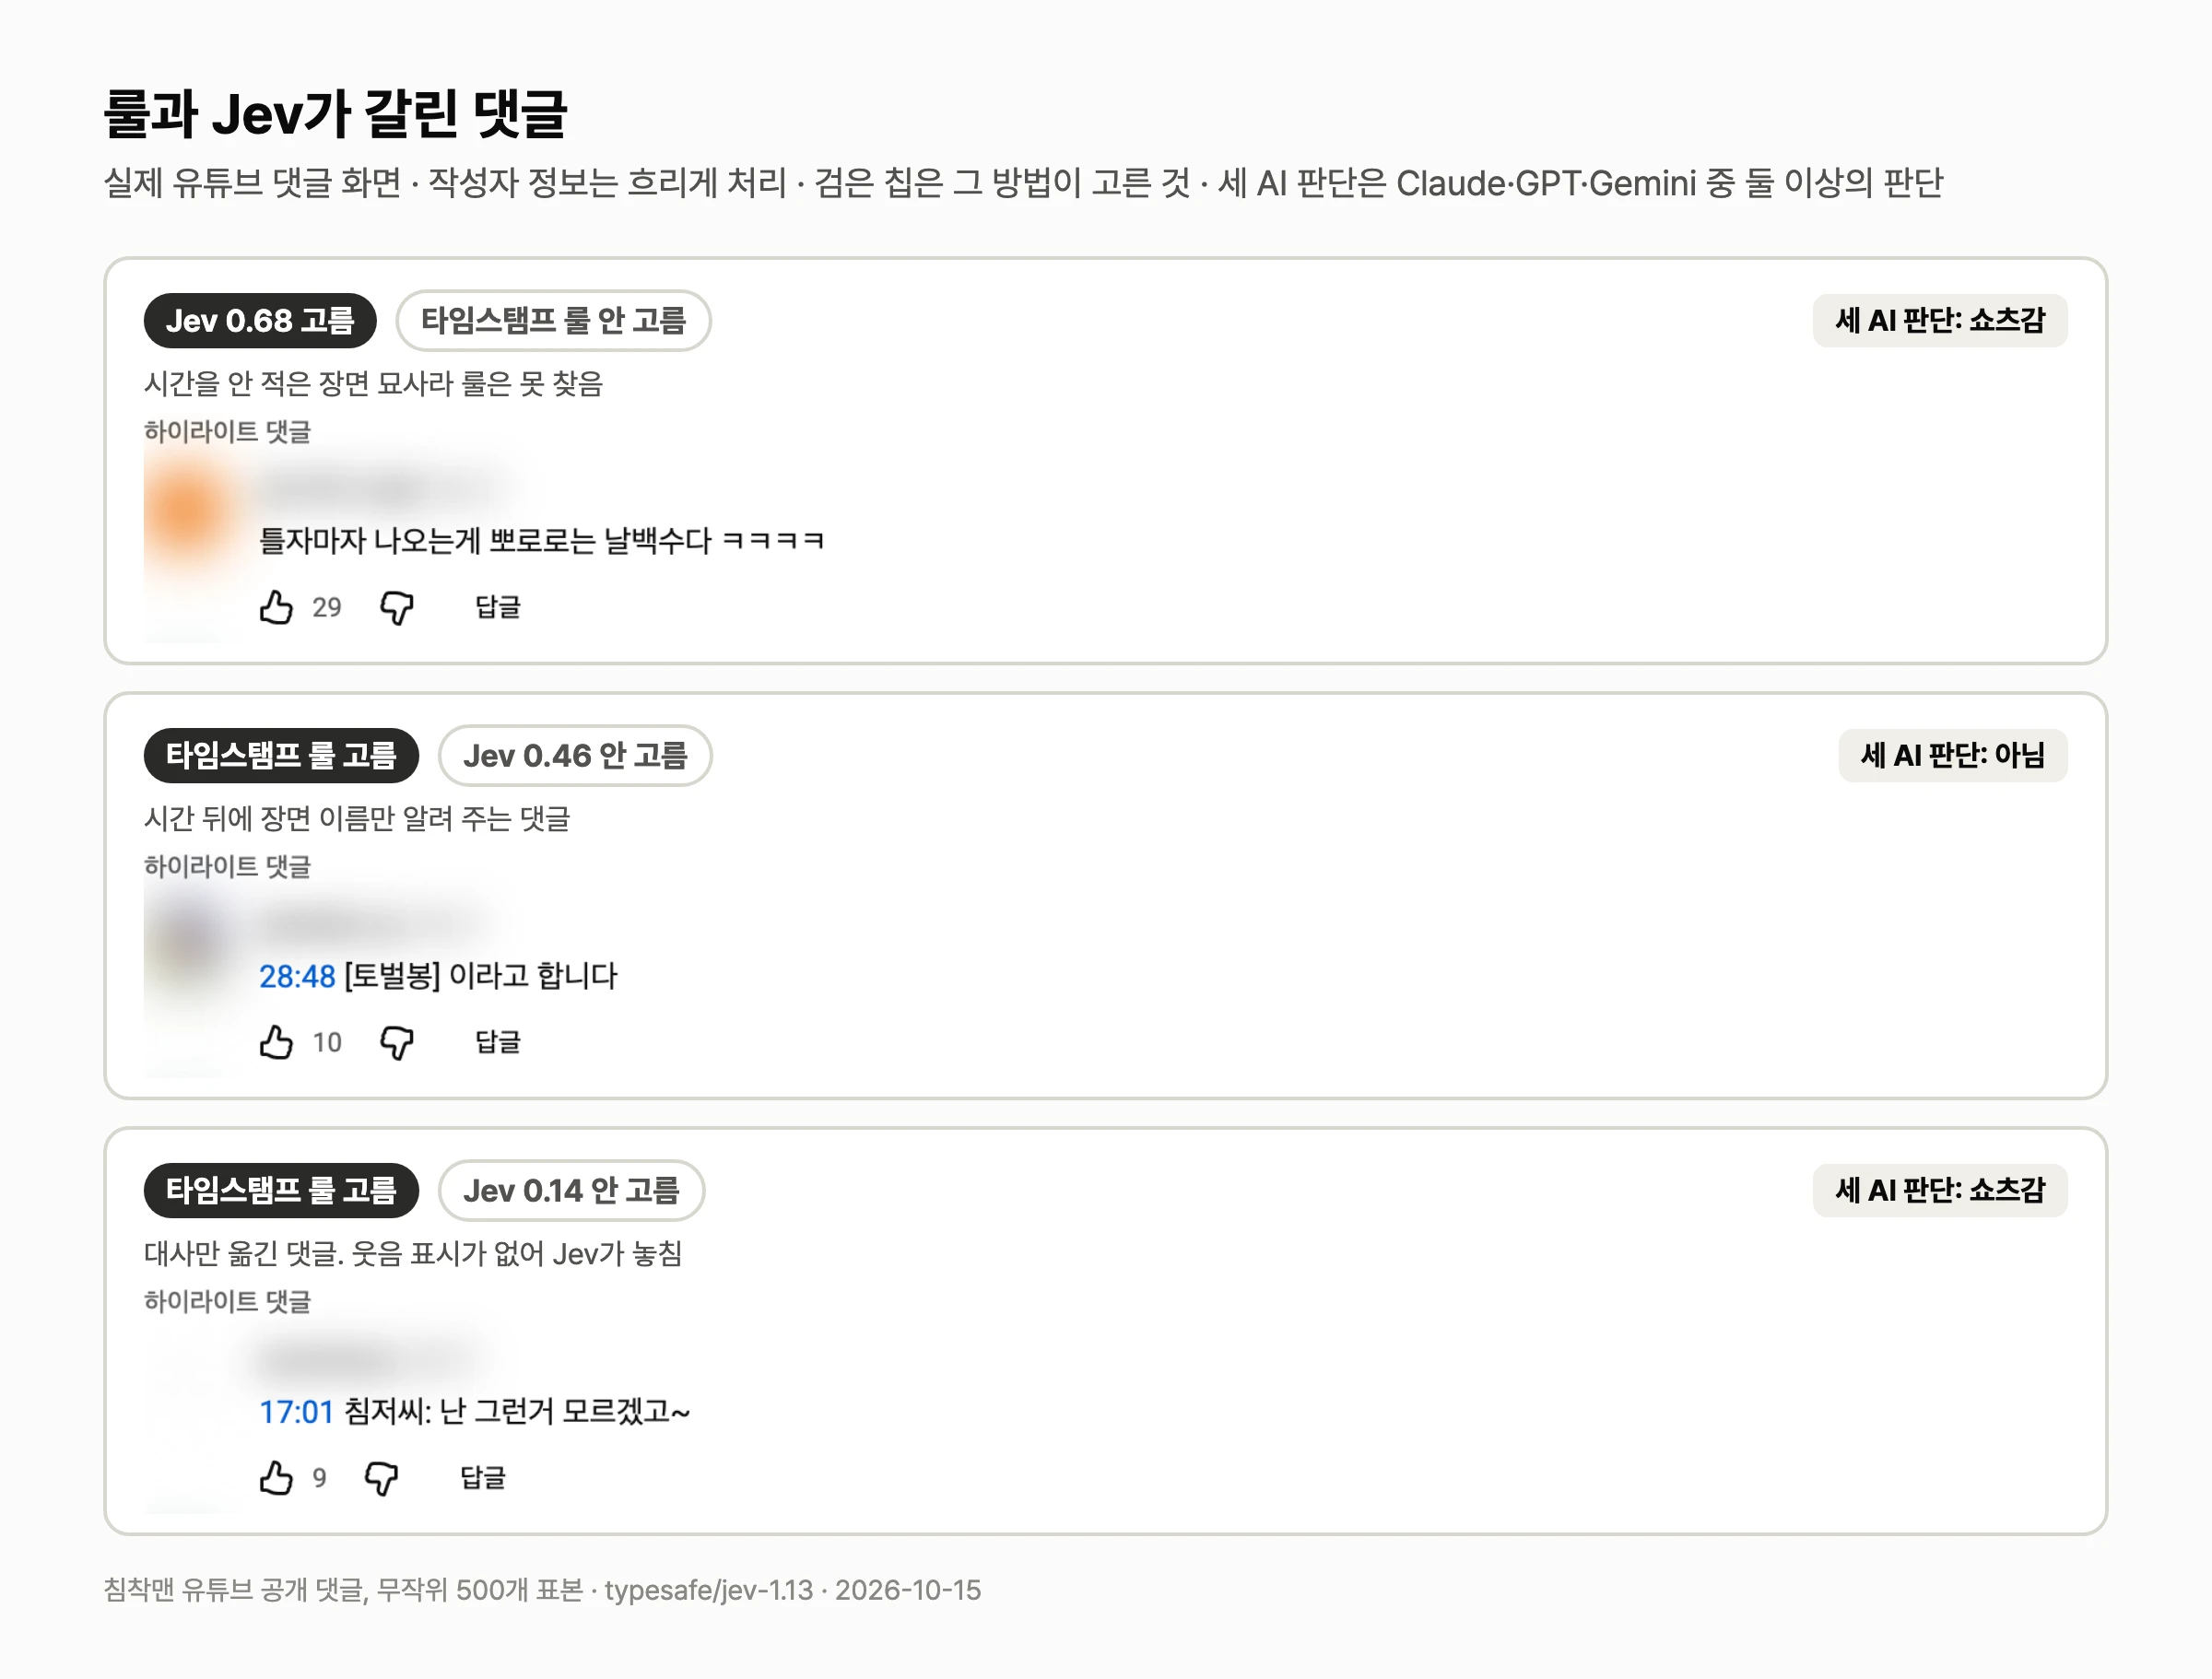
룰은 시간을 안 적은 장면 묘사를 못 찾습니다. 시청자는 웃긴 장면을 말할 때 꼭 시간을 적지 않습니다. 정답 87개 중 33개가 그랬고, 룰은 구조상 하나도 찾지 못했습니다. Jev는 이 33개 중 13개를 찾았습니다. 점수 차이는 대부분 여기서 나왔지만, Jev도 절반 넘게 놓쳤습니다.
Jev는 대사 인용을 놓쳤습니다. "17:01 침저씨: 난 그런거 모르겠고~"처럼 영상 속 대사만 옮긴 댓글에 Jev는 0.14를 줬습니다. 장면을 짚은 반응이지만 웃는다는 표시가 없어서인 것으로 보입니다. 반대로 "28:48 [토벌봉] 이라고 합니다"처럼 시간 뒤에 장면 이름만 알려 주는 댓글은 룰이 골랐지만, 세 AI는 쇼츠감이 아니라고 봤습니다.
그럼 ChatGPT 같은 일반 AI를 쓰면?
정답을 매긴 Claude·GPT·Gemini를 그냥 쓰면 되지 않을까요? 세 AI가 같은 500개를 판단하면서 든 시간과 실제 청구 비용을, 같은 500개를 처리한 Jev와 나란히 놓았습니다.
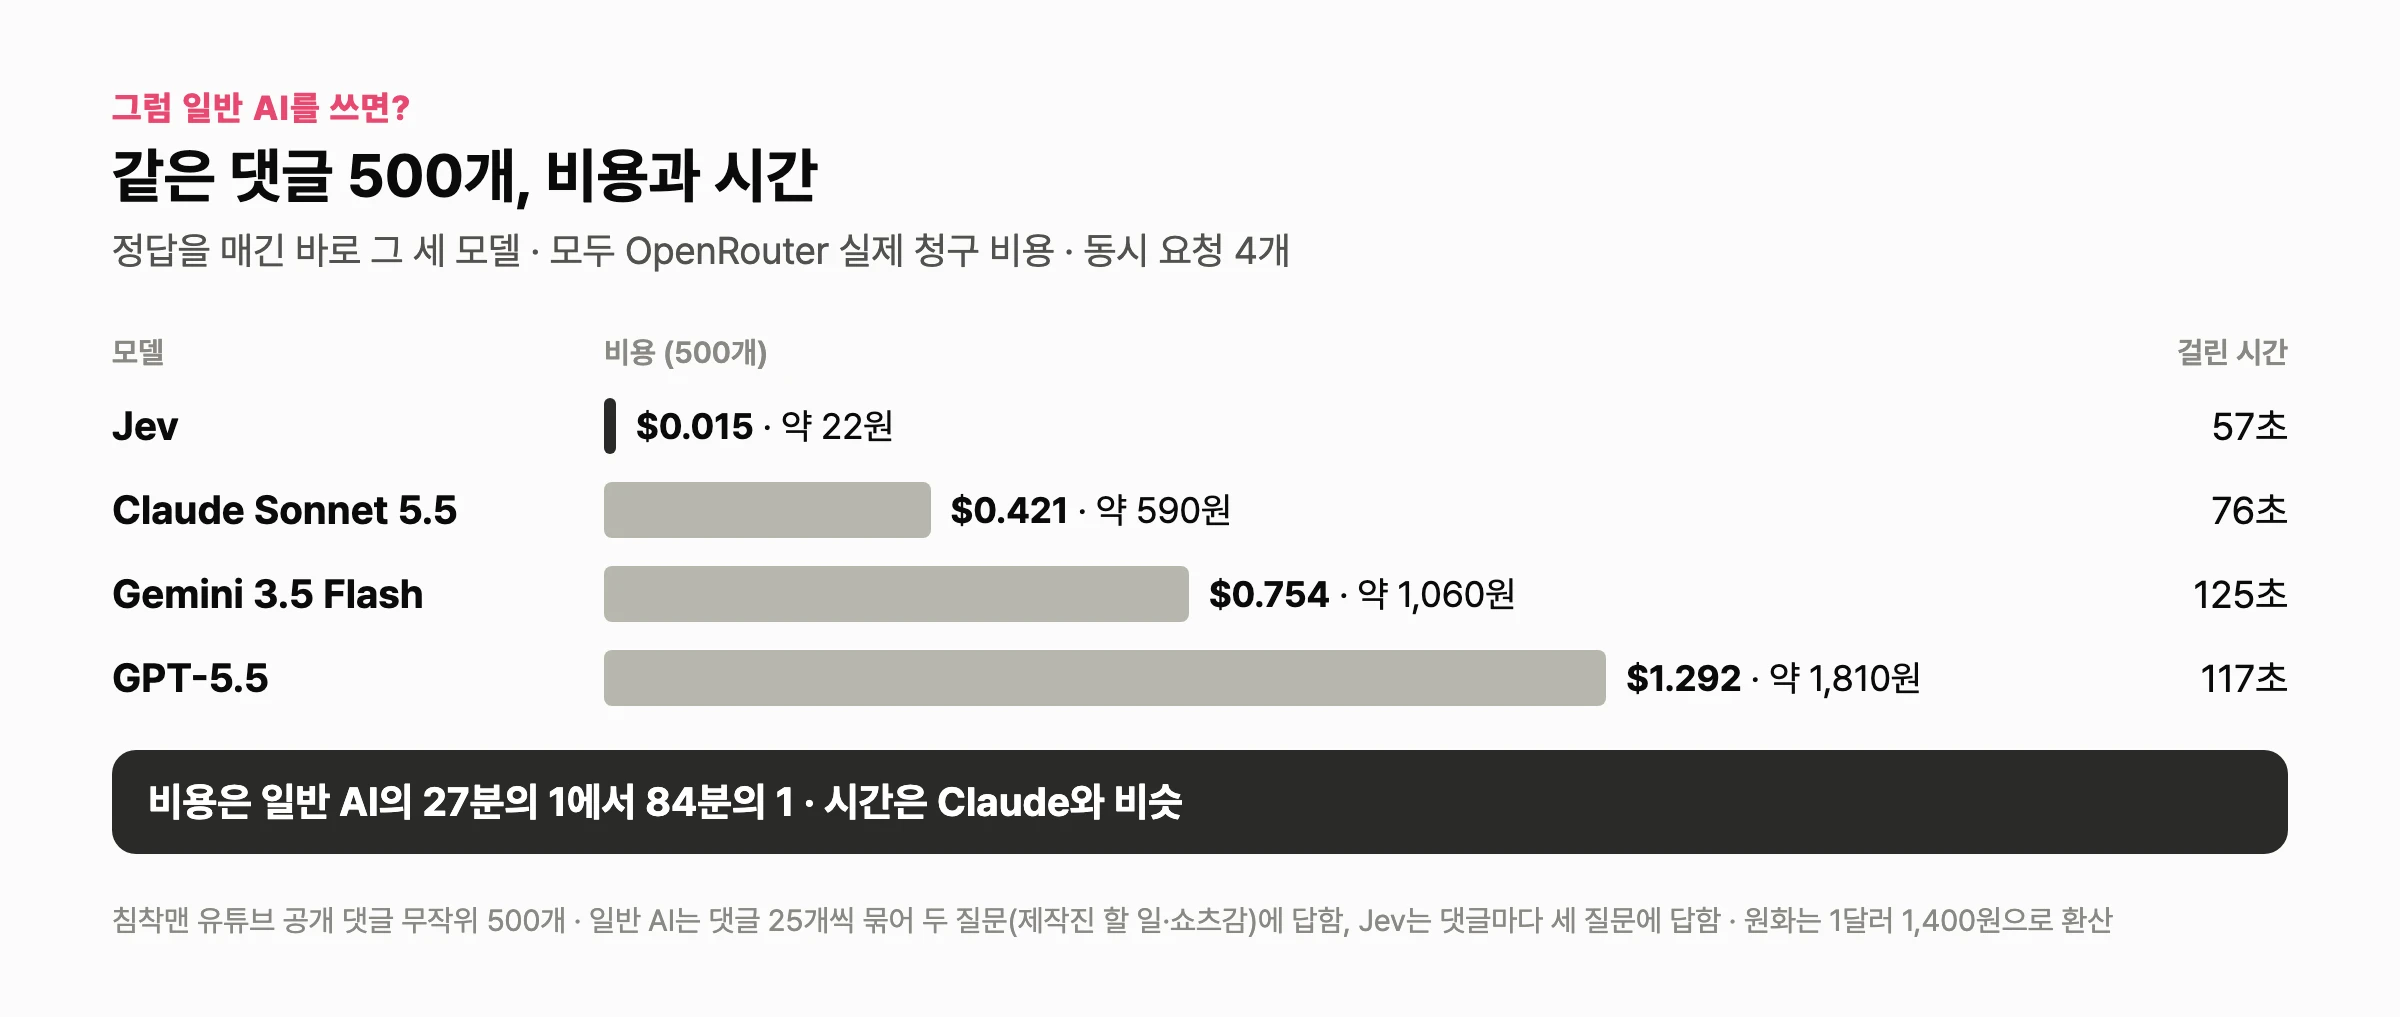
비용은 Jev가 일반 AI의 27분의 1에서 84분의 1이었습니다. 500개에 약 22원이라, 영상 하나의 댓글 1,800개를 매일 돌려도 한 달 커피 한 잔 값이 안 됩니다. GPT로 같은 일을 하면 84배가 듭니다.
시간은 생각보다 차이가 작았습니다. 일반 AI에는 댓글 25개를 묶어 한 번에 물어봤기 때문에, Claude는 76초로 Jev(57초)와 비슷하게 끝났습니다. 조건도 완전히 같지는 않습니다. 이 측정에서 일반 AI는 질문 두 개에, Jev는 질문 세 개에 답했습니다. 판단 하나하나가 중요하고 양이 적다면 일반 AI를, 양이 많고 매일 돌려야 한다면 Jev를 고르는 식으로 나누면 됩니다.
그래서 이렇게 붙이면 됩니다
룰로 타임스탬프 댓글을 먼저 고르고, Jev로 그중 웃긴 반응만 남긴 뒤, 시간을 안 적은 장면 묘사는 Jev로 따로 찾습니다. 룰이 확실하게 잡는 부분은 룰에 맡기고, 룰이 구조상 못 보는 부분에만 Jev를 쓰는 구성입니다.
지워야 할 댓글 찾기는 어려웠습니다
두 번째 미션은 제작진이 지워야 할 댓글(출연자 비하, 스팸, 광고 링크)을 찾는 것이었습니다. 그런데 공개된 댓글은 이미 한 번 걸러진 뒤라, 정말 지워야 할 댓글은 거의 없었습니다. 남은 것 중 비하처럼 보이는 말은 대부분 시청자의 장난이었습니다. 이 채널은 출연자를 놀리는 것 자체가 하나의 놀이라서, 정답을 매긴 세 AI도 Jev도 장난을 비난으로 읽는 경우가 많았습니다. 문장만 봐서는 채널 분위기를 알 수 없으니 정답부터 정하기 어려웠고, 그래서 이 미션은 점수를 매기지 않았습니다.
배운 점
룰을 기준선으로 같이 돌려 봅니다. Jev 숫자만 봤다면 "87개 중 64개"가 좋은지 나쁜지 알 수 없었습니다. 타임스탬프 룰 한 줄도 54개를 찾는다는 걸 같이 봐야 Jev를 어디에 붙일지 보입니다.
비교 표본은 룰과 무관하게 무작위로 뽑습니다. 키워드가 들어간 댓글 위주로 표본을 뽑으면 룰이 잘 잡는 댓글만 모아 놓고 룰을 채점하는 셈이 됩니다.
정답이 분명한 일부터 맡깁니다. 쇼츠감처럼 "장면을 짚고 웃었나"는 세 AI가 92% 같은 판단을 했지만, 장난인지 비난인지는 사람도 채널을 알아야 판단할 수 있었습니다. Jev를 붙일 일은 정답을 문장 하나로 정의할 수 있는 일부터 고르는 게 맞습니다.
마무리
실험을 해 보니 생각보다 어려웠습니다. 유튜브에 공개된 댓글은 이미 한 번 걸러진 상태라, 제작진이 지워야 할 댓글을 추릴 게 별로 없었습니다. Jev가 더 잘 맞는 곳은 라이브 방송에서 광고 도배나 욕설을 빠르게 잡아내는 일로 보입니다. 채팅이 초당 수십 개씩 올라와 사람이 다 볼 수 없고, 빠르고 싸다는 Jev의 장점이 그대로 살아나는 자리입니다. 기회가 되면 해 보겠습니다.
다른 업무에서 Jev가 맞는 일과 안 맞는 일은 Jev 활용 사례 — 따라 해 볼 3가지와 직군별 사례 37개에 정리했습니다.