
LiveKit 사용법: 오픈소스로 한국어 AI 음성 비서 직접 띄우기 (응답 7초 → 3초 줄인 실제 예시)
이 글과 연결된 글 보기
드래그로 이동 · 휠/두 손가락으로 확대 · 방향키로 글 선택 · 0으로 맞춤. 실선: 본문 링크, 점선: 시리즈·주제의 대표 연결.표시된 글 35편 목록
LiveKit은 실시간 음성·영상을 주고받는 오픈소스 서버이고, LiveKit Agents는 그 위에서 듣고 말하는 AI를 만드는 파이썬 프레임워크입니다. 둘 다 무료이고 내 컴퓨터에 직접 띄웁니다. 이번에 맥 한 대에 한국어 음성 비서를 올렸습니다. 받아쓰기와 목소리는 맥 안에서 처리하고 답변 문장만 OpenAI API를 씁니다. 고객 문의를 받아 Slack으로 넘기는 데까지 동작하고, 처음 5~7초 걸리던 응답을 단계별로 재서 3초 안팎으로 줄였습니다.
이 글은 이런 분께 필요합니다
- 전화 상담원이나 음성 비서를 만들고 싶은데, 분당 요금을 내는 유료 서비스부터 붙이기는 부담스러운 분
- LiveKit 이름은 들어 봤지만 서버, Agents, Cloud가 각각 무엇인지 헷갈리는 분
- 음성 AI를 만들어 봤는데 "대답이 너무 늦다"는 말을 들은 분
준비물은 Apple Silicon 맥(M1 이상), Python 3.12 설치 환경, OpenAI API 키입니다. 저희는 M4 맥북에서 테스트했습니다. 받아쓰기에 쓴 mlx-whisper는 맥 전용이라, 윈도우·리눅스라면 그 부분만 faster-whisper로 바꾸면 됩니다.
LiveKit은 무엇이 셀프호스팅되나
LiveKit은 세 층으로 나뉩니다. 이 구분을 알아야 무엇을 무료로 쓰고 무엇이 유료인지 헷갈리지 않습니다.
| 층 | 하는 일 | 이번 글 |
|---|---|---|
| LiveKit 서버 (오픈소스) | 브라우저·앱·전화의 음성을 실시간으로 중계 | 맥에 직접 설치 |
| LiveKit Agents (오픈소스) | 방에 들어와 듣고, 생각하고, 말하는 AI 프로그램 | 파이썬으로 작성 |
| LiveKit Cloud (유료 플랜 있음) | 서버 호스팅, 에이전트 배포, 내장 AI 모델, 전화번호 | 쓰지 않음 |
Cloud에서 파는 전화번호는 2026년 11월 기준 미국 번호만 있고 걸려 오는 전화만 받습니다. 한국 번호로 받으려면 국내 통신사의 070 번호를 따로 연결해야 하고, 이 부분은 글 끝에서 다룹니다.
이번에 만든 것
| 역할 | 무엇을 썼나 | 비용 |
|---|---|---|
| 음성 중계 | LiveKit 서버 1.13 | 무료 |
| 대화 엔진 | LiveKit Agents 1.8 | 무료 |
| 말 끝 감지 | Silero VAD + LiveKit 다국어 턴 감지 모델 | 무료, 로컬 |
| 받아쓰기 | mlx-whisper large-v3-turbo | 무료, 로컬 |
| 답변 | OpenAI gpt-5.4-nano | 사용한 토큰만큼 |
| 목소리 | Supertonic 3 한국어 | 무료, 로컬 (OpenRAIL-M) |
예제 코드는 여기서 내려받습니다. 아래 단계는 이 코드를 기준으로 설명합니다.
Step 1. LiveKit 서버 띄우기
맥은 Homebrew로 설치합니다.
brew install livekit
서버 설정 파일 livekit.yaml을 만듭니다. keys에는 API 키와 비밀값을 한 줄로 적습니다. 아무 문자열이나 되지만, 비밀값은 길고 무작위로 만드세요.
port: 7880
rtc:
  tcp_port: 7881
  port_range_start: 50000
  port_range_end: 60000
  use_external_ip: false
keys:
  APIabc123: 여기에_긴_무작위_비밀값
livekit-server --config livekit.yaml
다른 터미널에서 curl http://127.0.0.1:7880을 실행해 OK가 나오면 서버가 뜬 상태입니다. 같은 네트워크의 다른 기기에서도 쓰려면 bind_addresses와 node_ip에 그 맥의 주소를 넣습니다.
Step 2. 에이전트 환경 만들기
예제 폴더에서 Python 3.12 가상환경을 만들고 필요한 패키지를 설치합니다. Python 3.15처럼 너무 새 버전은 일부 패키지가 아직 맞지 않아서 3.12로 고정했습니다.
uv venv --python 3.12 .venv
uv pip install --python .venv/bin/python "livekit-agents[openai,silero]~=1.8" "livekit-plugins-turn-detector~=1.8" mlx-whisper supertonic python-dotenv
.env.example을 .env로 복사하고 Step 1의 키, OpenAI 키, 문의를 받을 웹훅 주소를 채웁니다. 그다음 말 끝 감지에 쓰는 모델 파일을 미리 받아 둡니다.
.venv/bin/python room_agent.py download-files
uv로 받은 파이썬 확장 파일에 다운로드 표시(quarantine)가 붙어 macOS가 막는 경우입니다. xattr -dr com.apple.quarantine .venv 를 한 번 실행하면 풀립니다.
Step 3. 가장 작은 음성 에이전트 구조
LiveKit Agents 1.8에서 에이전트는 세 덩어리입니다. 서버에 등록하는 AgentServer, 방에 사람이 들어오면 실행되는 entrypoint, 그리고 귀·머리·입을 묶는 AgentSession입니다.
from livekit.agents import Agent, AgentServer, AgentSession, JobContext, cli

server = AgentServer()

class Assistant(Agent):
    def __init__(self):
        super().__init__(instructions="당신은 데이터팝콘의 AI 음성 비서입니다. 한두 문장으로 짧게 답하세요.")

    async def on_enter(self):
        self.session.say("안녕하세요, 데이터팝콘입니다. 어떤 일로 연락 주셨어요?")

@server.rtc_session()
async def entrypoint(ctx: JobContext):
    session = AgentSession(stt=..., llm=..., tts=..., vad=...)
    await session.start(room=ctx.room, agent=Assistant())

if __name__ == "__main__":
    cli.run_app(server)
stt, llm, tts, vad 자리에 무엇을 끼우느냐로 비용과 속도가 정해집니다. 예제의 room_agent.py가 이 구조에 실제 모델을 채운 버전입니다. LiveKit 서버 주소와 키는 .env의 LIVEKIT_URL, LIVEKIT_API_KEY, LIVEKIT_API_SECRET에서 읽습니다.
Step 4. 한국어 받아쓰기와 목소리를 로컬로 붙이기
LiveKit Agents에는 OpenAI, Deepgram 같은 클라우드 플러그인이 기본으로 있습니다. 로컬 모델은 stt.STT와 tts.TTS를 상속한 작은 클래스로 감싸면 똑같이 끼워집니다. 예제의 dp_voice/local_models.py에 두 클래스가 있습니다.
받아쓰기는 말이 끝난 조각을 받아 mlx-whisper로 글자로 바꿉니다. 무음이나 잡음 조각에서 Whisper가 "감사합니다" 같은 문장을 지어내는 일이 잦아서, 너무 짧거나 조용한 조각은 버리고 자주 나오는 지어낸 문장은 걸러 냅니다.
class LocalWhisperSTT(stt.STT):
    def __init__(self):
        super().__init__(capabilities=STTCapabilities(streaming=False, interim_results=False))

    async def _recognize_impl(self, buffer, *, language=NOT_GIVEN, conn_options):
        frame = rtc.combine_audio_frames(buffer)
        pcm = np.frombuffer(frame.data, dtype=np.int16).astype(np.float32) / 32768.0
        # 16kHz로 바꾼 뒤 mlx_whisper.transcribe(..., language="ko") 호출
        ...
목소리는 Supertonic 3을 씁니다. 99M 크기의 온디바이스 TTS라 맥 CPU에서 한 문장을 0.3~0.7초에 만듭니다. 숫자와 영어를 그대로 주면 이상하게 읽어서, 합성 직전에 읽는 법으로 바꾸는 단계를 넣었습니다(dp_voice/korean_tts_text.py).
| 원문 | 실제로 읽는 문장 |
|---|---|
| 30명 정도이고 12월 10시에 가능해요 | 서른 명 정도이고 십이 월 열 시에 가능해요 |
| n8n 교육 문의 감사합니다 | 엔에이트엔 교육 문의 감사합니다 |
| 010-1234-5678 맞으실까요? | 공일공, 일이삼사, 오육칠팔 맞으실까요? |
화면에 남는 대화 기록은 원문 그대로 두고, 소리로 낼 때만 바꿉니다.
Step 5. 문의를 받으면 Slack으로 넘기기
LiveKit Agents에서는 메서드에 @function_tool()을 붙이면 AI가 대화 중에 부르는 도구가 됩니다. 함수 설명(docstring)이 그대로 AI에게 가는 사용 설명서입니다.
@function_tool()
async def leave_inquiry(self, context: RunContext, message: str, topic: str = "기타",
                        name: str = "", company: str = "", contact: str = "") -> str:
    """확인받은 문의를 담당자에게 전달합니다. 고객에게 내용을 확인받은 뒤 한 번 호출하세요."""
    async with httpx.AsyncClient(timeout=10) as client:
        res = await client.post(os.environ["INQUIRY_WEBHOOK_URL"], json={"text": ...})
    return "전달 완료" if res.is_success else "전달 실패"
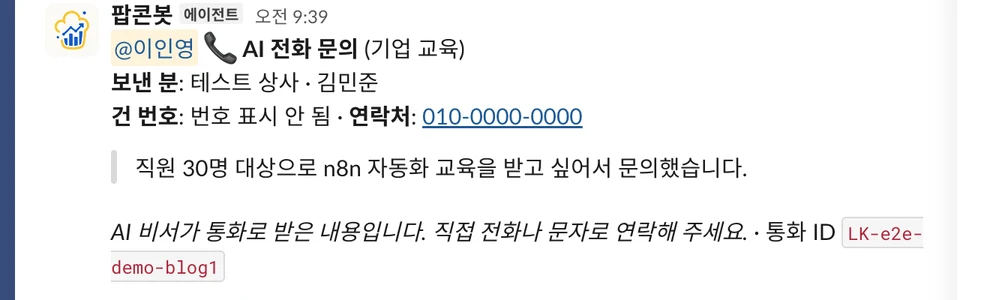
예제는 Slack Incoming Webhook 형식으로 보내서, n8n이나 Make 웹훅 주소를 넣어도 그대로 받습니다. 실제 시험 통화에서 비서가 남긴 문의는 이렇게 올라왔습니다. 저희는 홈페이지 문의 위젯과 같은 Slack 채널로 모아서 받습니다.
통화를 끝내는 end_call 도구도 하나 둡니다. 끝낸 뒤에 AI가 "감사합니다"를 또 말하는 일이 있어서, 끝낼 때 StopResponse를 던져 추가 발화를 막았습니다.
Step 6. 브라우저로 통화해 보기
전화번호가 없어도 브라우저에서 바로 통화해 봅니다. 예제의 token_server.py가 방 입장 토큰을 만들고, web/index.html이 LiveKit 공식 자바스크립트 SDK로 마이크를 연결합니다.
.venv/bin/python room_agent.py start
.venv/bin/python token_server.py
http://localhost:8091 을 열고 "통화 시작"을 누른 뒤 마이크를 허용하면 비서가 먼저 인사합니다. 마이크 권한은 https나 localhost에서만 열리므로, 같은 맥에서 열면 가장 간단합니다. 말한 내용과 비서의 답은 자막으로 함께 보입니다.
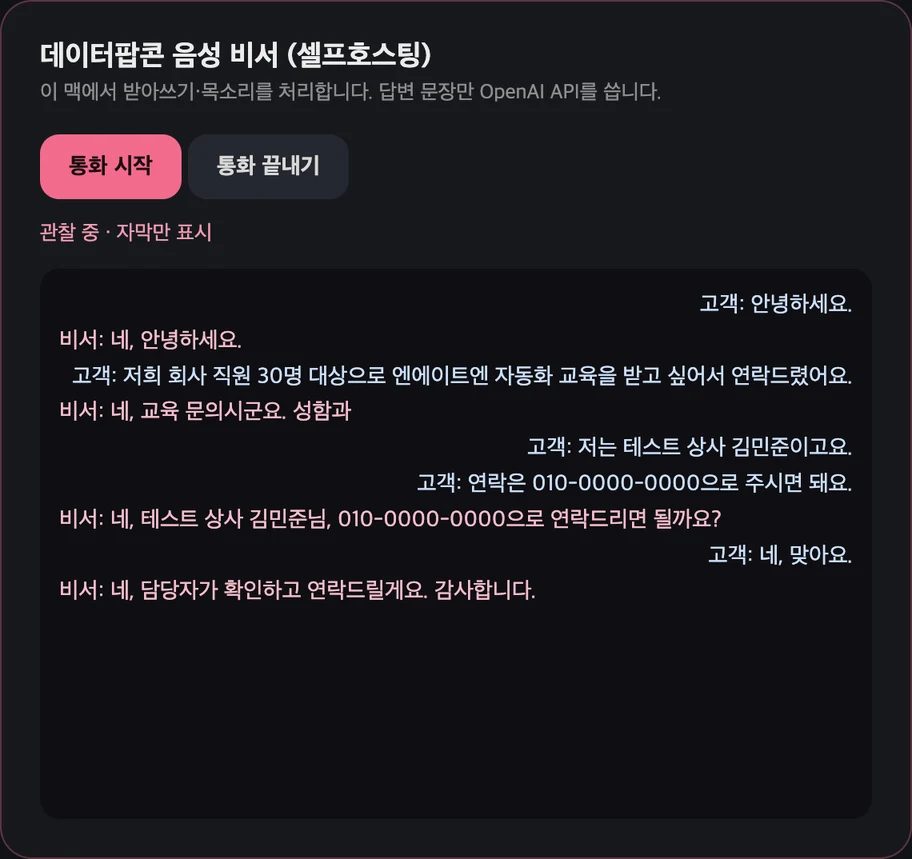
사람이 매번 말하기 번거로워서 e2e_test.py도 만들었습니다. 합성 음성 '고객'이 방에 들어가 세 마디를 말하고, 비서 목소리를 녹음해 단계별 지연을 잽니다. 아래 수치는 모두 이 스크립트로 잰 값입니다.
Step 7. 응답 5~7초를 3초 안팎으로 줄이기
처음 만든 버전은 고객 말이 끝나고 비서가 입을 떼기까지 5~7초가 걸렸습니다. 통화에서 이 정도면 상대가 "여보세요?"를 한 번 더 합니다. 에이전트 로그의 단계별 지표(metrics_collected 이벤트)로 어디서 기다리는지부터 쟀습니다.
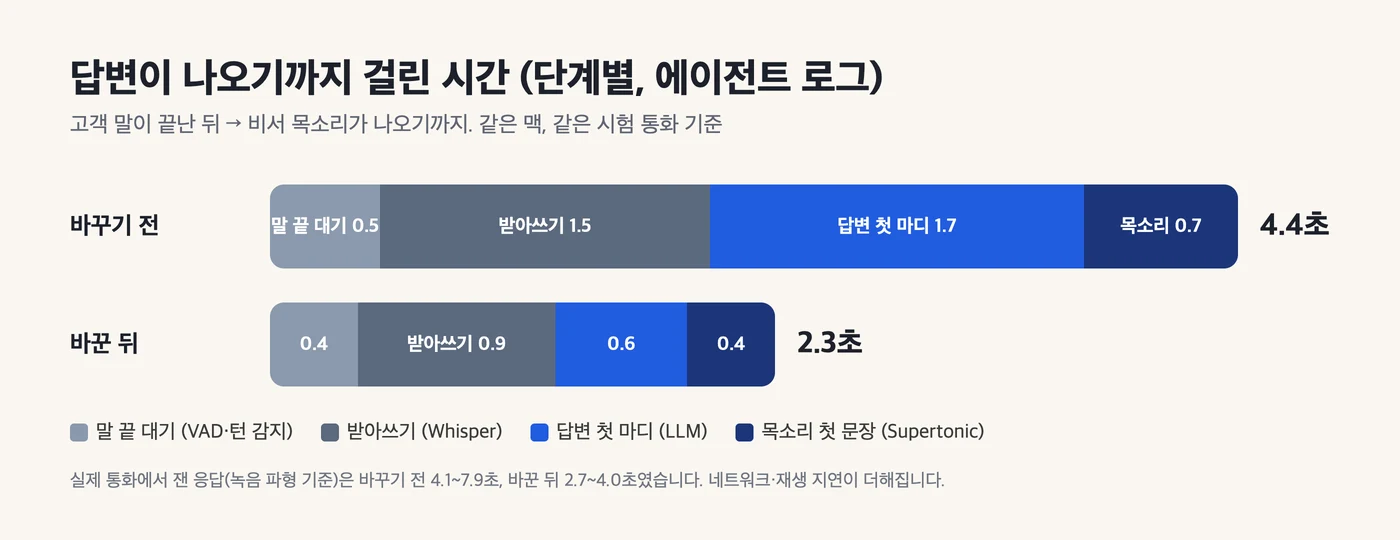
바꾼 내용은 다섯 가지입니다.
- 답변 모델을 바꿨습니다. gpt-5.4-mini의 첫 토큰은 0.7~1.4초였고, 같은 프롬프트로 gpt-5.4-nano는 0.5초 안팎이었습니다. 짧게 받아 주는 상담 대화에서는 답변 품질 차이를 크게 느끼지 못했습니다. 로컬 Ollama(qwen3 8B)도 시험했는데, 맥이 바쁠 때 10초 넘게 걸려 답변만 API로 돌렸습니다.
- 말 끝 판단을 똑똑하게 했습니다. 쉼 기준을 0.3초로 짧게 잡아 말하는 도중에도 조각별로 미리 받아쓰고, "말이 끝났나"는 LiveKit 다국어 턴 감지 모델이 문장 내용으로 판단합니다. 한국어를 지원하고 로컬에서 돕니다.
from livekit.plugins.turn_detector.multilingual import MultilingualModel

session = AgentSession(
    ...,
    turn_handling={
        "turn_detection": MultilingualModel(),
        "endpointing": {"min_delay": 0.4, "max_delay": 1.8},
        "preemptive_generation": {"enabled": True, "preemptive_tts": True},
    },
)
- 답변 첫 문장을 미리 합성합니다. 위 설정의
preemptive_tts가 턴이 확정되기 전에 첫 문장 목소리를 만들어 둡니다. Supertonic의 합성 단계도 5에서 4로 줄였습니다. - 모델을 한 번만 올립니다. 처음엔 통화마다 새 프로세스를 띄우는 기본 방식이라, 새 통화가 들어올 때마다 받아쓰기·목소리 모델을 다시 올리느라 진행 중인 통화가 20초 넘게 멈춘 적이 있습니다.
AgentServer(job_executor_type=JobExecutorType.THREAD)로 바꿔 모델을 워커 안에서 한 번만 올리고 통화끼리 나눠 씁니다. - 받아쓰기 모델을 데워 둡니다. 밤새 쉰 뒤 첫 받아쓰기가 13초 걸린 일이 있어서, 90초마다 짧은 무음을 한 번씩 받아쓰게 했습니다.
남은 가장 큰 몫은 받아쓰기입니다. whisper-large-v3-turbo는 짧은 말에도 0.91.2초의 고정 비용이 있습니다. whisper-small로 바꾸면 0.30.5초로 줄지만 받아쓰기 오류가 늘어서, 지금은 정확도를 택했습니다.
실제 통화 예시
합성 음성 고객과 비서가 나눈 55초 통화입니다. 고객이 기업 교육을 문의하고, 비서가 이름·회사·연락처를 받은 뒤 내용을 확인받고 Slack으로 넘기는 흐름입니다.
들어 보면 고객이 "안녕하세요." 하고 잠깐 쉬는 사이 비서가 "네, 안녕하세요"로 먼저 받습니다. 사람 상담원처럼 들리기도 하지만, 말을 끊는다고 느끼는 분도 있습니다. 턴 감지 대기(min_delay)를 늘리면 줄어드는 대신 응답이 그만큼 늦어집니다.
한국 전화번호로 받으려면
브라우저 대신 전화로 받으려면 번호가 있어야 합니다. 앞에서 본 것처럼 LiveKit Cloud 번호는 미국용이라, 국내에서는 070 번호를 주는 통신사에 붙입니다. 저희가 AI 전화 상담원 글에서 쓴 한국AI통신은 공식 문서에서 LiveKit Agents 코드를 LiveKit 서버나 SIP 없이 070 번호로 바로 실행하는 방법을 안내합니다. 같은 Agent와 AgentSession을 그대로 넘기는 구조라 이 글의 코드를 거의 그대로 씁니다.
이 부분은 아직 번호를 개통하지 않아 실제 통화로는 시험하지 못했습니다. 개통한 뒤 결과를 이어서 정리하겠습니다. 피클 같은 AI 비서 앱이 회사 번호로 대신 전화를 거는 방식은 피클 가이드에 정리해 두었습니다.
자주 막히는 곳
| 증상 | 원인 | 해결 |
|---|---|---|
library load disallowed by system policy | 내려받은 확장 파일의 quarantine 표시 | xattr -dr com.apple.quarantine .venv |
방에 들어가도 비서가 안 들어옴, 로그에 worker is at full capacity | 맥 CPU 부하가 기본 기준(70%)을 넘어 워커가 일을 거절 | AgentServer(load_fnc=lambda: 0.0, load_threshold=1.0) (동시 통화가 적을 때만) |
| 첫 대답이 10초 이상 걸림 | 모델이 식었거나, 통화마다 모델을 다시 올림 | 스레드 실행기 + 주기적 데우기 (Step 7의 4·5번) |
| 같은 말을 조각조각 반복함 | LLM 요청이 타임아웃 뒤 재시도되며 앞부분을 또 말함 | SessionConnectOptions(llm_conn_options=APIConnectOptions(max_retry=0)) |
| 숫자·영어를 이상하게 읽음 | TTS가 숫자·영문을 한국어로 읽지 못함 | 합성 직전 읽기 정규화 (Step 4) |
| 조용한데 "감사합니다"가 받아써짐 | Whisper가 무음에서 문장을 지어냄 | 짧고 조용한 조각 버리기, 지어낸 문장 거르기 |
| 고객 말 중간에 비서가 끼어듦 | 쉼을 말 끝으로 판단 | 턴 감지 모델 사용, min_delay 조정 |
정리
LiveKit은 음성 중계 서버와 에이전트 프레임워크를 무료로 내주고, 받아쓰기·답변·목소리는 원하는 모델을 끼우게 해 줍니다. 이번 예시는 받아쓰기와 목소리를 로컬에 두고 답변만 API로 써서, 통화 한 건에 드는 외부 비용이 답변 토큰 몇 원 수준입니다. 응답 속도는 모델을 바꾸는 것보다 "어디서 기다리는지"를 재는 데서 줄었습니다. 같은 맥에서 4.4초 걸리던 단계별 합이 2.3초로, 실제 통화 응답은 2.7~4.0초가 됐습니다.
다음은 070 번호를 붙여 실제 전화로 받는 단계입니다. 예제 코드는 여기에서 받아 Step 1부터 따라 하면 됩니다.