교회들은 성경의 어디를 설교할까? 유튜브 설교 14편을 성경 3만 1천 절 위에 찍어본 MVP 기록
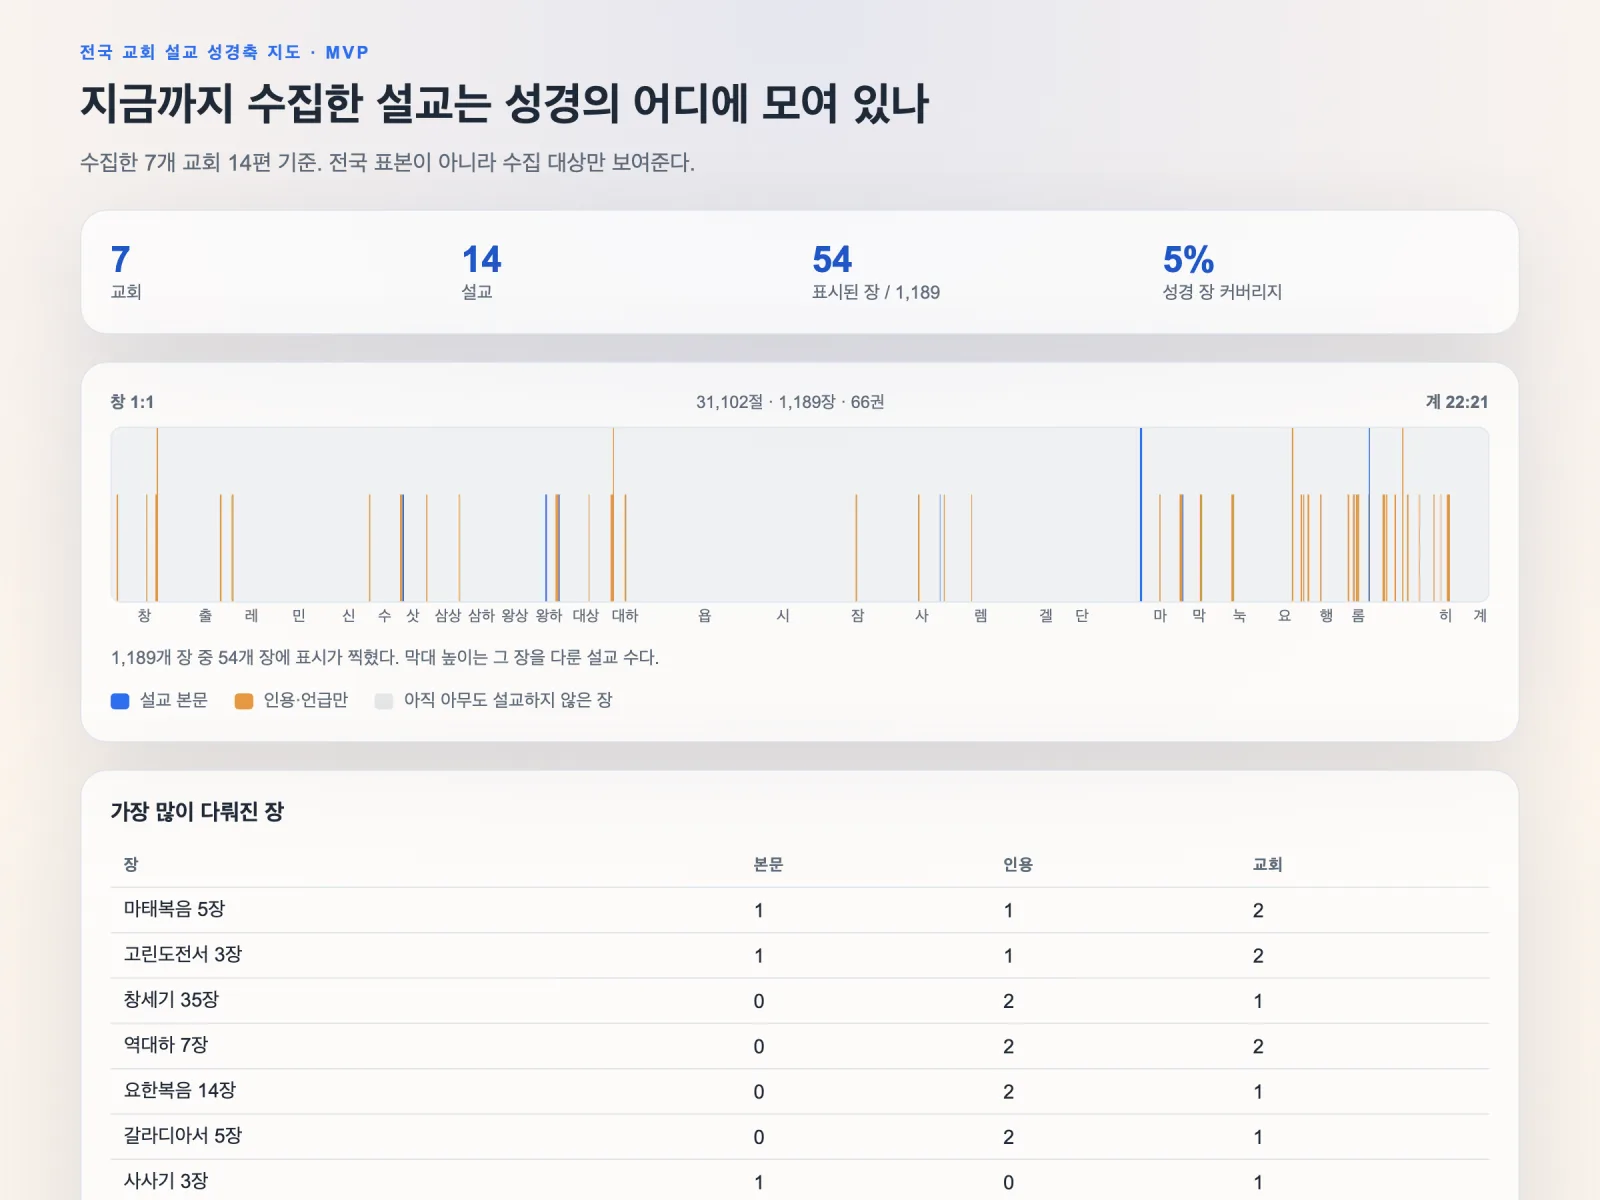
7개 교회의 유튜브 설교 14편을 성경 한 줄 축 위에 찍어보니 1,189장 중 54장이 채워졌습니다. 수집부터 집계, 화면, 배포까지 파이프라인은 끝까지 돌고, 14편 중 7편은 "오늘 설교 본문이 어디인지"까지 확정됩니다. 나머지 7편은 제목에 본문이 없어 아직 인용 구절만 쌓입니다. 이 글은 설교 1편짜리 PoC를 여러 교회를 누적하는 지도로 넓히면서 무엇을 먼저 실측했고, 로드맵을 에이전트들에게 어떻게 나눠 설계시켰고, 공개 전에 무엇을 고쳤는지 정리한 기록입니다. 결과는 설교 성경축 지도에서 볼 수 있습니다.
배경: 설교 1편은 그렸는데, 교회 전체는 못 그렸다
출발점은 설교 한 편을 분석하는 PoC였습니다. 유튜브 설교 URL을 넣으면 한국어 자막을 받아 설교 본문과 인용 구절을 뽑고, 성경 전체 31,102절을 한 줄로 늘어놓은 축 위에 아크 차트로 그려줍니다. 베이직교회의 마태복음 28장 설교 한 편으로 검증했고, 잘 동작했습니다.
하고 싶은 건 그다음이었습니다. 여러 교회의 설교를 계속 모아서, 예를 들어 어느 교회가 어느 주일에 히브리서 12장 12절을 설교했다면 그 자리에 체크를 하나 찍고, 그 체크가 쌓인 모습을 보는 것입니다. 그런데 코드를 열어보니 PoC는 설교 한 편에 묶여 있었습니다. 문맥 인용 규칙은 특정 영상 ID일 때만 켜졌고, 교회·설교자·날짜는 베이직교회 제목 규칙(_교회_목사_YYYYMMDD)에서만 읽혔고, 제목에서 본문을 못 찾으면 예외를 던졌습니다.
목표: 설교 한 편을 축 위의 체크 하나로 만든다
성경 축은 이미 PoC에 있었습니다. 66권의 장·절 수 데이터로 창세기 1장 1절을 1번, 요한계시록 22장 21절을 31,102번으로 매기는 인덱스입니다. 예로 든 히브리서 12장 12절은 30,225번입니다. 새로 만들 것은 축이 아니라 그 위에 쌓는 방법이었습니다.
그래서 목표를 세 가지로 잡았습니다.
- 어떤 교회 설교 URL을 넣어도 파이프라인이 멈추지 않는다. 못 찾은 것은 에러가 아니라 상태로 남긴다
- 설교를 여러 편 저장하고, 교회별로 축 위에 누적해서 보여준다
- 로컬이 아니라 URL로 볼 수 있게 배포한다
구현 1: 코드보다 먼저 유튜브를 40편 실측했다
설계 전에 실제 설교 영상이 어떻게 생겼는지부터 봤습니다. yt-dlp로 "주일예배 설교"를 검색해 영상 40편(채널 16곳)의 제목과 길이를 모으고, 그중 14편(10개 채널)은 한국어 자막이 있는지 하나씩 확인했습니다. 추측으로 설계했다면 틀렸을 부분이 네 군데 나왔습니다.
| 관찰 | 수치 | 설계에 준 영향 |
|---|---|---|
| 한국어 자동자막 | 14편 중 14편 | 음성 인식(Whisper)은 주 경로가 아니라 보조 경로로 충분 |
| 업로더가 직접 올린 한국어 자막 | 14편 중 1편 | 자동자막의 성경 고유명사 오인식 보정이 필요 |
| 제목에 설교 본문이 있는 채널 | 16곳 중 4곳 | 제목만으로는 본문을 못 찾는다. 자막 초반부에서 추론해야 한다 |
| 예배 전체 라이브 녹화 | 5시간 넘는 영상 2편 | 설교 구간을 먼저 찾아야 찬양·광고 중 인용이 섞이지 않는다 |
제목 형식도 교회마다 달랐습니다. 본문이 괄호 안에 있거나, 구분자 뒤에 붙거나, 여러 구절이 쉼표로 이어지거나, 아예 없었습니다. 구분자로 알파벳 소문자 l을 쓰는 채널도 있었고, 날짜 표기만 6종이 넘었습니다.
…『내 인생의 사사기는 안전한가?』(삿 3:1~11)_…            ← 괄호 안
… / 김병삼 목사 | 역대하 7:14                              ← 구분자 뒤
… | 하나님의 사람 | 열왕기하 1:1~3, 8 | …                   ← 쉼표 목록
꿈의교회 주일설교 l 어디로 가야 할지 막막할 때 l …         ← 소문자 l 구분자, 본문 없음
새로운 출발을 위해 주시는 말씀 | 이찬수 목사 | …            ← 본문 없음
처음 정리할 때는 "영어 제목을 쓰는 채널이 많다"고 적었는데, 틀린 관찰이었습니다. 유튜브 검색 결과에는 같은 영상의 제목이 영어로 자동 번역돼 내려왔고, 영상 하나하나의 메타데이터를 받아보니 16곳 모두 원래 한글 제목이었습니다. 제목을 분석할 때는 검색 목록이 아니라 영상 메타데이터를 봐야 합니다.
여러 교회 설교를 모아 재배포하는 미디어 채널도 있었습니다. 채널 하나가 교회 하나라는 가정은 처음부터 깨져 있었던 셈입니다. 이 실측이 없었다면 Whisper 전사 비용을 핵심 비용으로 잡고, 제목 파서만 고치면 된다고 판단했을 것입니다.
구현 2: 로드맵은 에이전트 5명에게 따로 설계시키고 3명이 채점했다
로드맵은 Claude Code의 워크플로우 기능으로 여러 에이전트에게 나눠 맡겼습니다. 같은 자료(현재 코드 요약, 실측 결과, 반드시 다뤄야 할 제약 12개)를 주고 관점만 다르게 한 설계자 5명이 병렬로 로드맵을 짰습니다. 그다음 프로젝트 오너, 시니어 엔지니어, 회의적인 운영자 관점의 심사자 3명이 다섯 설계를 모두 읽고 채점했습니다.
1위는 "설교 1편 → 한 채널 → 5개 교회 → N개 교회"로 조금씩 넓히는 점진 확장형이었습니다. 다른 설계에서 쓸 만한 아이디어는 골격에 옮겨 붙였습니다. 데이터 플랫폼 설계에서는 추출기 버전별 재처리 규칙을, 제품 화면 설계에서는 "첫 화면에 한 문장으로 결론을 보여준다"는 원칙을 가져왔습니다.
| 설계 관점 | 심사 합계 |
|---|---|
| 점진 확장 | 133 |
| 추출 일반화 | 126 |
| 리스크 우선 | 126 |
| 데이터 플랫폼 | 124 |
| 제품 화면 | 118 |
가장 쓸모 있었던 단계는 마지막 비평가였습니다. 합성된 초안에는 "참조 파서가 열왕기하 10: 25-31처럼 콜론 뒤 공백이 있으면 실패한다"는 문장이 있었습니다. 비평가가 파서를 직접 실행해 보고 이 주장이 틀렸다고 지적했고, 수정 단계에서 다시 실행해 정상 파싱을 확인했습니다. 진짜 실패는 en-dash 범위, 쉼표 목록, 절 없는 장 단위 참조 세 가지였습니다. 코드에 대한 주장을 다른 에이전트가 실행으로 검증하게 한 구조가 없었다면, 틀린 작업이 로드맵에 들어갔을 것입니다.
작업 중 사용량 한도에 걸려 합성 단계에서 한 번 멈췄습니다. 다시 실행했을 때 이미 끝난 설계 5개와 심사 3개는 저장된 결과를 그대로 쓰고, 남은 합성·비평·수정만 새로 돌았습니다. 에이전트가 쓴 토큰은 두 번 실행을 합쳐 약 190만, 걸린 시간은 약 1시간이었습니다.
구현 3: 하드코딩 3곳을 규칙 묶음으로 빼니 다른 교회 설교 4편이 통과했다
첫 구현 단계의 목표는 "어떤 설교를 넣어도 멈추지 않는다"였습니다. 베이직교회 설교 한 편에만 맞춘 문맥 규칙과 인용 분류 규칙은 영상 ID별 규칙 묶음(rule pack)으로 옮겼습니다. 규칙 묶음이 없는 영상은 기본 경로로만 분석합니다. 덕분에 기존 설교의 골든 테스트(구절 10건, 아크 8건)는 한 글자도 바뀌지 않았습니다.
본문을 못 찾는 경우는 예외 대신 상태로 바꿨습니다. 설교마다 reviewStatus(extracted 또는 needs_review)와, 본문을 어떤 방법으로 찾았는지 남기는 primaryResolution을 붙였습니다. 본문이 없어도 인용 구절은 그대로 축에 쌓입니다. 설교 ID도 "날짜 + 본문"에서 "영상 ID + 구간 번호"로 바꿨습니다. 같은 날 같은 본문을 설교한 두 교회가 같은 ID로 충돌하는 문제를 피하기 위해서입니다.
전사 원문은 결과에서 뺐습니다. 이전에는 분석 결과에 설교 자막 전체가 들어 있어서 API 응답과 테스트 픽스처가 설교 전문을 담고 있었습니다. 결과 타입에서 자막 필드를 지우자 골든 픽스처가 179KB에서 8KB로 줄었습니다. 이제 저장·공개되는 것은 구절 참조, 짧은 근거 문장, 유튜브 타임스탬프뿐입니다.
다른 교회 실제 설교 4편으로 확인했습니다. 수정 전 코드로 같은 4편을 다시 돌려보면 3편은 본문을 못 찾아 500 에러였고, 제목 괄호에 본문이 있던 강남중앙교회 1편은 통과했지만 교회 이름이 "알 수 없음"이었습니다. 수정 후에는 네 편 모두 통과했고 교회 이름도 채워졌습니다. 강남중앙교회 설교는 사사기 3장 1~11절로 확정됐고, 나머지 세 편은 needs_review로 저장되면서 인용 구절을 각각 12건, 5건, 1건 남겼습니다.
구현 4: MVP는 파일 저장, 장 단위 집계, 화면 두 개로 충분했다
"뼈대만 먼저"라는 방향에 맞춰 DB, 교회 자동 발견, 주간 수집 워커는 모두 뒤로 미뤘습니다. 설교는 명령 한 줄로 수집해 교회별 JSON 파일로 저장합니다.
npm run collect -- "https://www.youtube.com/watch?v=영상ID"
집계는 1,189개 장을 칸으로 삼고, 규칙을 두 가지 정했습니다. 한 설교 안에서 같은 장이 여러 번 나와도 그 장에는 1회만 셉니다. 긴 설교 한 편이 교회 전체보다 크게 보이지 않게 하려는 규칙입니다. 그리고 같은 장을 본문으로 설교한 것과 지나가며 인용한 것이 겹치면 본문이 이깁니다.
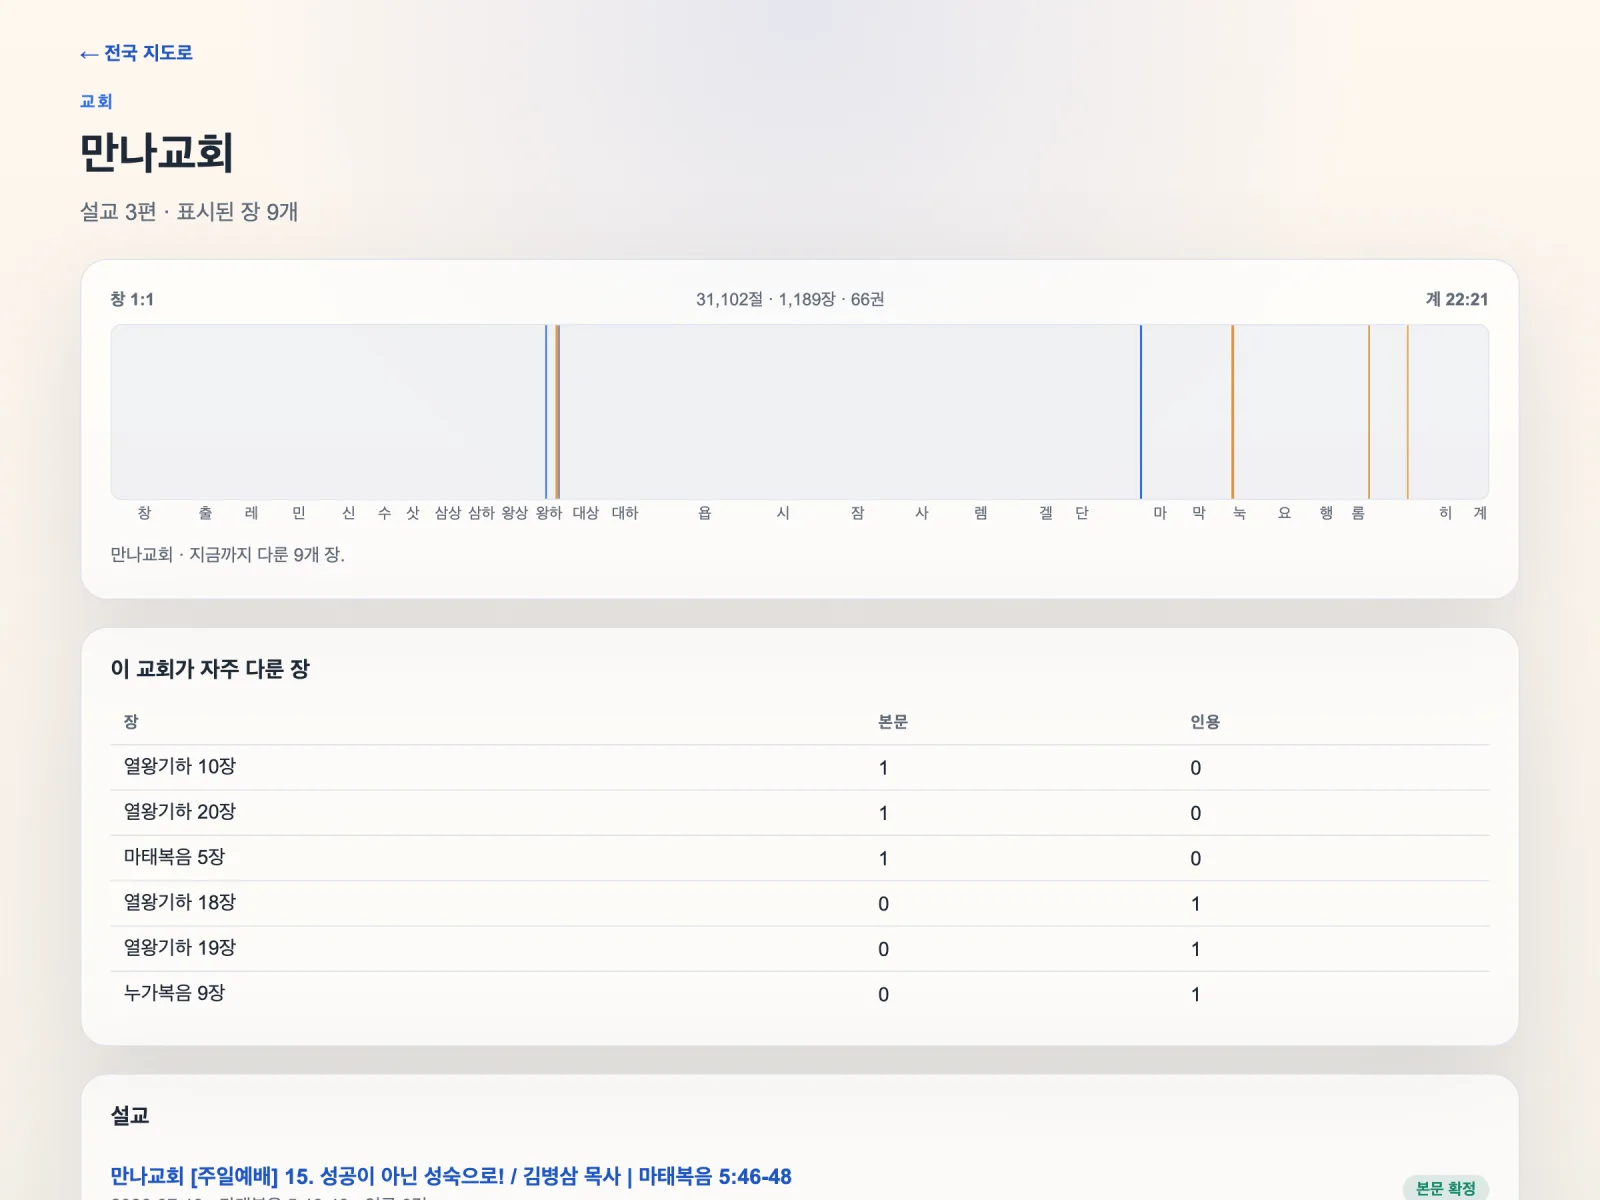
화면은 두 개입니다. 전국 지도는 수집한 교회·설교 수, 1,189장 중 표시된 장, 절 수에 비례한 66권 축, 많이 다뤄진 장, 교회 목록을 보여줍니다. 교회 페이지는 그 교회만의 축과 설교 목록입니다.
구현 5: 로컬에서 되던 두 가지가 Vercel에서는 깨진다
로컬에서는 잘 되던 MVP를 Vercel에 올리기 전에 두 군데를 고쳤습니다. 첫째, 페이지가 요청 시점에 data/sermons 폴더를 파일로 읽고 있었습니다. 서버리스 함수에는 이 폴더가 딸려가지 않을 수 있어서, 수집할 때 전체 설교를 all.json 하나로 묶어 커밋하고 페이지는 그 파일을 import하게 바꿨습니다. 전국 지도는 빌드 때 정적 페이지로 만들어집니다.
둘째, 설교 한 편을 실시간 분석하는 기능은 서버에서 yt-dlp 실행 파일을 호출합니다. Vercel에는 이 파일이 없습니다. 그래서 VERCEL=1 환경에서는 분석 API가 503을 돌려주고, 분석 페이지는 "로컬에서 수집해 커밋하면 다음 배포에 반영된다"는 안내로 바뀝니다. 수집은 로컬에서, 보기는 배포판에서 하는 구조입니다.
배포에서는 예상 못 한 일이 두 가지 있었습니다. 먼저 preview로 올리려고 vercel deploy를 실행했는데, 새 프로젝트의 첫 배포는 --prod 없이도 production으로 올라갔습니다. 로그인해야 볼 수 있는 preview URL을 기대했지만, 결과는 누구나 접속 가능한 프로젝트 기본 도메인이었습니다. 이 서비스는 공개할 생각이었기 때문에 그대로 두었습니다.
두 번째는 그 뒤의 배포가 전부 멈춘 것입니다. vercel ls에는 처음에 상태가 UNKNOWN으로, 나중에는 Blocked로만 보였고 vercel inspect도 이유를 알려주지 않았습니다. 배포 API를 직접 조회하니 readyStateReason에 이유가 있었습니다.
npx vercel@latest api /v13/deployments/<배포 URL>
# readyStateReason: The deployment was blocked because the commit author
#                   doesn't have permission to create deployments for this project.
저희 팀은 Vercel Hobby 플랜이고, CLI 배포에도 로컬 저장소의 커밋 작성자 정보가 함께 올라갑니다. 차단된 배포의 커밋 작성자는 개인 업무 이메일이었습니다. 같은 팀 블로그 프로젝트의 최근 배포 6건을 확인해 보니 4건은 Vercel 계정 이메일로 작성한 커밋에서, 2건은 커밋 정보 없이 나가 있었습니다. 그래서 계정 이메일 명의의 빈 커밋을 만들고 배포하자 바로 READY가 됐습니다. 같은 작성자의 첫 배포만 통과한 이유는 확인하지 못했습니다.
git commit --allow-empty --author="팀 이름 <Vercel 계정 이메일>" -m "chore: trigger Vercel deployment"
npx vercel@latest deploy --prod
구현 6: 공개 전에 고친 네 가지
링크를 걸어 공개하기 전에 화면을 다시 보니, 14편 중 12편이 "본문 미확정"이었고 만나교회 설교 2편은 인용 구절이 0건이었습니다. 교회 이름도 "만나 미디어교회", "HANSUNG PRESBYTERIAN CHURCH"처럼 유튜브 채널 이름이 그대로 나왔습니다. 공개 전에 네 가지를 고쳤습니다.
첫째, 제목에서 구분자 뒤에 따로 적힌 구절을 읽게 했습니다. |, /, ·, 양쪽에 공백이 있는 -와 소문자 l로 제목을 나누고, 조각 하나가 통째로 성경 구절로 읽히면 그것을 본문으로 삼습니다. 3:1-9의 하이픈은 공백이 없어서 나뉘지 않습니다. 열왕기하 1:1~3, 8 같은 쉼표 목록은 첫 범위를 본문으로 봅니다. 이것만으로 본문 확정이 2편에서 7편이 됐습니다.
둘째, 인용 구절 0건의 원인은 자동자막이었습니다. 설교자가 분명히 "열왕기하 18장 13절"이라고 읽었는데 자막에는 "열왕기아 18장 13절"로 적혀 있었습니다. 이런 오인식을 추측으로 모으는 대신, 14편 자막 전체에서 "처음 보는 단어 + N장 M절" 패턴을 뽑아 확인했습니다. 몇 분 만에 7가지가 나왔습니다.
| 자막에 적힌 말 | 실제 책 | 원인 |
|---|---|---|
| 열왕기아, 일왕기와 | 열왕기하 | 자막 오인식 |
| 역대아, 역대학 | 역대하 | 자막 오인식 |
| 요호수아 | 여호수아 | 자막 오인식 |
| 갈라디아 | 갈라디아서 | 실제로 쓰는 약칭인데 사전에 없음 |
| 역대기하 | 역대하 | 실제로 쓰는 다른 이름인데 사전에 없음 |
자막 오인식은 뒤에 장 번호가 올 때만 고치는 교정표로, 약칭은 책 이름 사전에 추가했습니다. "역대학"처럼 평범한 말과 겹칠 수 있는 단어도 장 번호가 붙을 때만 바뀝니다. 인용 0건이던 만나교회 설교 2편은 본문을 포함해 4건, 2건이 됐고, 오륜교회 설교 1편은 2건에서 6건이 됐습니다.
셋째, 채널 이름과 교회 이름을 잇는 작은 목록을 만들었습니다. "만나 미디어교회"는 만나교회, "HANSUNG PRESBYTERIAN CHURCH"는 한성교회, "오륜교회 oryunchurch"는 오륜교회로 표시합니다. 이 목록이 없으면 교회 하나가 채널 이름별로 여러 페이지로 갈라집니다.
넷째, 공개 화면을 한국어 독자에 맞췄습니다. 표와 막대 설명에 "Genesis 35" 대신 "창세기 35장"을 쓰고, 첫 화면 하단의 개발용 수집 명령은 데이터 출처 설명으로 바꿨습니다. 페이지 제목과 공유 미리보기도 "설교 성경축 지도"로 정했습니다.
결과
| 항목 | 값 |
|---|---|
| 수집한 교회 / 설교 | 7곳 / 14편 |
| 표시된 장 | 1,189장 중 54장 (약 5%) |
| 본문 확정 | 14편 중 7편 (공개 전 수정 이전 2편) |
본문 미확정(needs_review) | 14편 중 7편 |
| 추출한 구절 언급 | 85건 |
| 저장 데이터 | 약 100KB (전사 원문 0건) |
| 테스트 | 56건 → 108건, 기존 골든 결과 무변경 |
| 배포 | 전국 지도·교회 페이지 200, 분석 API 503(의도) |
배운 점
가장 큰 한계는 여전히 본문 추출입니다. 남은 7편(분당우리교회 4편, 오륜교회 2편, 한성교회 1편)은 제목에 본문이 아예 없습니다. 인용 구절은 쌓이지만, 원래 보고 싶던 그림은 "어느 교회가 어느 본문을 설교했나"의 누적이라 이 7편을 풀어야 서비스의 첫 문장이 성립합니다.
코드보다 데이터를 먼저 본 것이 두 번 설계를 바꿨습니다. 실측 전에는 자막이 없을 때를 대비한 음성 인식 경로를 중심에 두었을 것입니다. 실제로는 자동자막이 14편 모두에 있었고, 진짜 문제는 제목 형식과 5시간짜리 예배 녹화였습니다. 자막 오인식도 마찬가지였습니다. 추측으로 교정표를 만들었다면 "열왕기아"나 "일왕기와"는 떠올리지 못했을 것입니다.
여러 에이전트에게 설계를 나누는 방식은 "더 많은 아이디어"보다 "틀린 주장을 걸러내는 장치"로 쓸모가 있었습니다. 설계자 한 명이 쓴 로드맵이었다면 파서가 공백을 못 읽는다는 틀린 전제로 작업 항목이 하나 생겼을 것입니다. 같은 이유로 "수정 전에는 무엇이 안 됐다"는 기록도 원래 코드로 다시 돌려봐야 합니다. 처음에는 "4편 모두 500 에러"라고 적었는데, 확인해 보니 3편이었습니다.
작은 함정도 있었습니다. 검색 목록의 제목은 번역본일 수 있습니다. zsh에서 물음표가 들어간 유튜브 URL을 따옴표 없이 넘기면 glob으로 해석돼 수집 명령이 바로 실패합니다. 개발 서버를 켜둔 채 next build를 돌리면 .next 폴더를 덮어써서 개발 서버 화면이 하얗게 비어버립니다. Vercel 배포가 Blocked일 때는 목록 화면이 아니라 배포 API의 readyStateReason을 봐야 이유가 보입니다.
다음 액션
다음 목표는 남은 7편의 본문을 찾는 것입니다. 제목에 본문이 없는 설교는 자막 초반 10분에서 "오늘 본문은", "함께 읽겠습니다" 같은 표현 근처의 구절을 후보로 올리고, 근거 문장과 함께 저장하는 방식을 붙일 예정입니다.
그다음은 교회 수를 늘리는 단계입니다. 5시간짜리 예배 녹화에서 설교 구간만 잘라내는 기능과, 교회와 채널을 따로 관리하는 목록을 먼저 만들고, 주간 수집을 자동으로 돌리는 순서로 넓혀 갑니다.