가입자가 한 달 만에 86만 명 늘었다? 국민연금 데이터 25개월치 쌓아 보니 보인 것
이 글과 연결된 글 보기
드래그로 이동 · 휠/두 손가락으로 확대 · 방향키로 글 선택 · 0으로 맞춤. 실선: 본문 링크, 점선: 시리즈·주제의 대표 연결.표시된 글 11편 목록
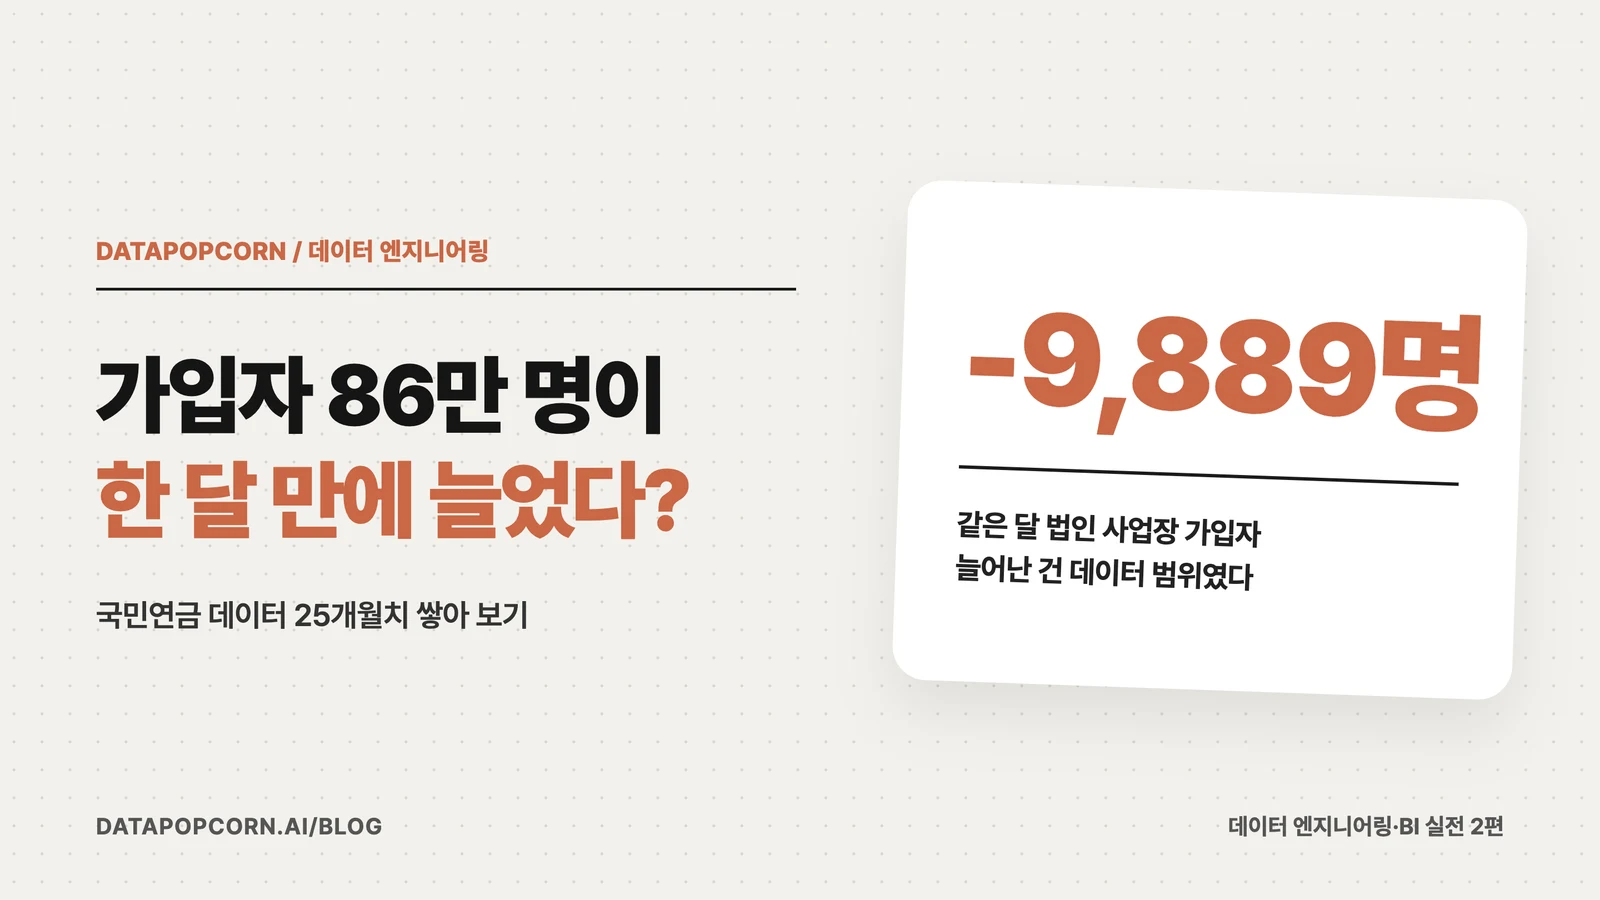
국민연금 가입 사업장 데이터를 25개월치 쌓아 월별 가입자 합계를 그려 보면, 2025년 6월분에서 한 달 만에 86만 3천 명이 늘어납니다. 그런데 법인 사업장만 따로 보면 같은 달 가입자는 오히려 9,889명 줄었습니다. 늘어난 86만 명은 이 달부터 데이터에 새로 들어온 개인사업장 4만 3천여 곳의 가입자였습니다. 이 글을 따라 하면 과거 파일을 자동으로 받아 월별 스냅샷으로 쌓고, 이런 범위 변경을 그래프를 그리기 전에 먼저 찾아낼 수 있습니다.
이 글은 이런 분께 필요합니다
- 1편에서 국민연금 사업장 데이터 한 달치를 열어 본 분
- 데이터를 "한 번 받기"는 해 봤지만, 매달 쌓이는 데이터를 어떻게 보관해야 하는지는 막막한 분
- 면접에서 "백필(backfill)이 뭔가요", "같은 작업을 다시 돌리면 어떻게 되나요" 같은 질문에 답할 경험이 필요한 분
1편 마지막에 카카오, 쿠팡, 카카오뱅크의 2026년 9월 숫자를 봤지만 "사람이 늘고 있다"고는 말할 수 없었습니다. 한 달치 스냅샷이었기 때문입니다. 이번 편에서는 지난 파일을 받아 쌓습니다. 이미 지나간 기간의 데이터를 한꺼번에 채워 넣는 작업을 백필이라고 부릅니다.
Step 1. 과거 파일이 얼마나 있는지 확인하기
공공데이터포털 데이터 페이지 아래쪽 "주기성 과거 데이터" 목록에 지난 파일이 남아 있습니다. 2026년 10월 28일 기준으로 126개였고, 가장 오래된 건 "국민연금 가입 사업장 내역 2015년 12월"이었습니다. 10년치가 남아 있는 셈입니다.
이번 실습에서는 최근 25개 파일만 받습니다. 2024년 10월 21일 등록분부터 최신 파일까지이고, 기준월로는 2024년 9월부터 2026년 9월까지입니다. 파일 하나가 106~116MB라서 25개를 합치면 원본만 2.8GB입니다. 10년치를 다 받으면 노트북 디스크가 먼저 부족해집니다. 필요한 기간만 받는 것도 설계입니다.
목록을 손으로 하나씩 누르는 대신, 포털 페이지가 목록을 불러올 때 쓰는 요청을 그대로 호출했습니다. 브라우저 개발자 도구의 네트워크 탭에서 페이지가 어떤 주소로 목록을 받아 오는지 확인할 수 있습니다.
import re, urllib.parse, urllib.request

BASE = "https://www.data.go.kr"
PK = "15083277"
DETAIL_PK = "uddi:4f8f48cf-344b-471f-b7f2-c2aa98c210a7"
HEADERS = {"User-Agent": "Mozilla/5.0", "X-Requested-With": "XMLHttpRequest",
           "Referer": f"{BASE}/data/{PK}/fileData.do"}

def post(path, data):
    req = urllib.request.Request(BASE + path, data=urllib.parse.urlencode(data).encode(), headers=HEADERS)
    with urllib.request.urlopen(req, timeout=60) as r:
        return r.read().decode("utf-8")

html = post("/tcs/dss/selectHistAndCsvData.do", {"publicDataPk": PK, "publicDataDetailPk": DETAIL_PK})
files = re.findall(r'data-public-pk="(uddi:[0-9a-f-]+)"\s+data-public-detail-sn="\d+">\s*([^<]+?)\s*</a>'
                   r'\s*</td>\s*<td>([0-9-]+)</td>', html)
print(len(files), files[0][1:], files[-1][1:])
126 ('국민연금공단_국민연금 가입 사업장 내역_20260923', '2026-09-23') ('국민연금 가입 사업장 내역 2015년 12월', '2019-08-05')
한 가지 알아둘 점이 있습니다. 이 주소는 공식 오픈 API가 아니라 포털 화면이 내부적으로 쓰는 요청입니다. 포털이 화면을 바꾸면 예고 없이 깨질 수 있습니다. 그래서 수집 코드에서는 결과 개수와 형식을 매번 확인하고, 깨지면 바로 멈추게 만들어 두는 편이 안전합니다.
Step 2. 원본 보관 규칙 세 가지 정하기
다운로드 코드를 짜기 전에 보관 규칙부터 정했습니다. 백필은 한 번 하고 끝나는 게 아니라, 다음 달부터는 같은 코드가 새 파일을 하나씩 더 받게 됩니다. 그래서 규칙이 먼저입니다.
- 폴더는 파일 이름이 아니라 기준월로 나눕니다. 1편에서 봤듯 파일 날짜와
자료생성년월은 한 달 어긋납니다. 받은 파일을 열어자료생성년월이 하나뿐인지 확인한 뒤, 그 값으로raw/ym=2026-09/같은 폴더에 넣습니다. 한 파일에 기준월이 두 개 이상 섞여 있으면 저장하지 않고 멈춥니다. - 원본은 바이트 그대로 압축만 합니다. 인코딩 변환이나 컬럼 정리는 원본이 아니라 사본에서 합니다. gzip으로 압축하면 2026년 9월분 115MB가 36MB가 됐고, 25개월치 2.8GB가 848MB로 줄었습니다.
- 받은 기록을 manifest에 남깁니다. 기준월, 파일 이름, 등록일, 행 수, 바이트 수, sha256 해시를 한 줄씩 적습니다. 같은 파일을 다시 받았을 때 내용이 바뀌었는지는 해시로 확인합니다.
Step 3. 다시 돌려도 결과가 같은 백필 스크립트
전체 코드는 아래 재현 자료에 있고, 핵심 흐름은 이렇습니다.
for detail_pk, name, reg in list_files():
    if not (START_REG <= reg <= END_REG) and reg != "9999-12-31":  # 최신 파일은 항상 포함
        continue
    if name in done_files and name != "최신 파일":  # 이미 받은 과거 파일은 내려받지도 않는다
        continue
    body = download(detail_pk)
    lines = body.decode("cp949").splitlines()
    yms = {line.split(",", 1)[0] for line in lines[1:] if line}
    if len(yms) != 1:
        raise ValueError(f"{name}: 기준월이 하나가 아님")
    ym = yms.pop()                                   # 파일 안의 자료생성년월
    if ym in done:
        continue
    with gzip.open(f"raw/ym={ym}/nps.csv.gz", "wb") as f:
        f.write(body)                                # 원본 바이트 그대로
    manifest.writerow([ym, name, reg, len(lines) - 1, len(body), hashlib.sha256(body).hexdigest()])
    time.sleep(2)                                    # 포털에 부담 주지 않게
python backfill.py 2024-10-01 2026-10-31
이 스크립트의 첫 버전은 done_files 줄이 없었습니다. 이미 받은 기준월인지는 파일을 받아서 열어 봐야 알 수 있었기 때문입니다. 그런데 실제로 돌리다가 중간에 작업이 끊겼고, 다시 실행하니 이미 받은 7개월치 파일을 처음부터 다시 내려받았습니다. 건너뛰기는 했지만 다운로드는 다 한 겁니다. 그래서 manifest에 적힌 파일 이름으로 먼저 걸러, 이미 받은 과거 파일은 아예 요청하지 않게 고쳤습니다. 최신 파일만은 매달 내용이 바뀌므로 받아서 기준월로 판단합니다.
이렇게 몇 번을 다시 돌려도 결과가 같은 성질을 멱등성이라고 부릅니다. 데이터 엔지니어 면접에서 자주 나오는 단어인데, 직접 끊겨 보고 고쳐 보면 설명하기가 훨씬 쉬워집니다.
Step 4. 분석용 사본은 parquet으로
원본은 CP949 CSV라서 매번 읽을 때마다 변환이 필요합니다. 그래서 기준월마다 한 번만 UTF-8로 바꾸고, 컬럼 이름과 타입을 정리한 parquet 사본을 staging/ym=YYYY-MM/ 폴더에 만듭니다.
con.sql(f"""
COPY (
  SELECT 자료생성년월 AS ym, 사업장명 AS workplace_name, 사업자등록번호 AS bizno6,
         "사업장가입상태코드 1 등록 2 탈퇴" AS status_code, 우편번호 AS zipcode,
         "사업장형태구분코드 1 법인 2 개인" AS biz_type,
         사업장업종코드 AS industry_code, 적용일자 AS joined_on,
         CAST(가입자수 AS INTEGER) AS members,
         CAST(신규취득자수 AS INTEGER) AS new_members,
         CAST(상실가입자수 AS INTEGER) AS lost_members
  FROM read_csv('{tmp_utf8_csv}', header = true, all_varchar = true)
) TO 'staging/ym={ym}/nps.parquet' (FORMAT parquet)
""")
1편에서 큰따옴표로 감싸야 했던 사업장가입상태코드 1 등록 2 탈퇴 같은 컬럼이 여기서 status_code가 됩니다. 업종코드와 우편번호는 계속 문자로 둡니다. 25개월치를 parquet으로 바꾸는 데 M3 맥북에서 1분이 채 안 걸렸습니다.
parquet 사본은 언제든 원본에서 다시 만들 수 있습니다. 그래서 컬럼을 잘못 정리했다면 staging 폴더를 지우고 다시 돌리면 됩니다. raw와 staging을 나눠 두는 이유가 이것입니다.
Step 5. 그래프 전에 월별 합계부터 찍어 보기
이제 25개월치를 한 번에 읽을 수 있습니다. 바로 추세 그래프를 그리고 싶지만, 그 전에 월별 행 수와 가입자 합계를 표로 먼저 봅니다.
con.sql("CREATE VIEW s AS SELECT * FROM read_parquet('staging/*/nps.parquet')")
print(con.sql("""
SELECT ym,
       COUNT(*) FILTER (WHERE status_code = '1')                    AS 등록사업장,
       COUNT(*) FILTER (WHERE status_code = '1' AND biz_type = '2') AS 개인사업장,
       SUM(members) FILTER (WHERE status_code = '1')                AS 전체가입자,
       SUM(members) FILTER (WHERE status_code = '1' AND biz_type = '1') AS 법인가입자
FROM s WHERE ym BETWEEN '2025-04' AND '2025-07'
GROUP BY ym ORDER BY ym
"""))
┌─────────┬────────────┬────────────┬────────────┬────────────┐
│   ym    │ 등록사업장 │ 개인사업장 │ 전체가입자 │ 법인가입자 │
├─────────┼────────────┼────────────┼────────────┼────────────┤
│ 2025-04 │     512488 │          0 │   10626221 │   10626221 │
│ 2025-05 │     512326 │          0 │   10625255 │   10625255 │
│ 2025-06 │     554822 │      43636 │   11488319 │   10615366 │
│ 2025-07 │     555595 │      43972 │   11512895 │   10632208 │
└─────────┴────────────┴────────────┴────────────┴────────────┘
2025년 5월분까지는 개인사업장이 한 곳도 없습니다. 6월분부터 개인사업장 43,636곳이 들어오면서 전체 가입자가 10,625,255명에서 11,488,319명으로 863,064명 늘었습니다. 같은 기간 법인 사업장 가입자는 10,625,255명에서 10,615,366명으로 9,889명 줄었습니다.
포털 설명에도 단서가 있습니다. 제공 범위가 "가입자 수 3인 이상 법인사업장, 가입자 수 10인 이상 개인사업장(2025.7.이후)"이라고 적혀 있습니다. 2025년 7월에 등록된 파일, 즉 기준월 2025년 6월분부터 개인사업장이 추가됐다는 뜻입니다. 이걸 모르고 전체 합계로 그래프를 그렸다면 "2025년 여름에 고용이 폭발했다"는 틀린 결론이 나옵니다.
시리즈에서는 이렇게 정리하겠습니다. 25개월 추세를 볼 때는 법인 사업장만 쓰고, 개인사업장은 2025년 6월분부터 따로 봅니다. 이 규칙은 6편 데이터 품질 검사에서 자동으로 걸리게 만듭니다.
Step 6. 회사 하나의 25개월, 그리고 다음 문제
이제 1편의 질문으로 돌아갑니다. 같은 이름의 사업장을 25개월 동안 따라가 봤습니다.
| 사업장명 | 2024-09 | 2026-09 | 변화 |
|---|---|---|---|
| 네이버 주식회사 | 4,443 | 5,183 | +740 (+16.7%) |
| 주식회사 카카오뱅크 | 1,599 | 1,798 | +199 (+12.4%) |
| 주식회사 카카오 | 3,911 | 3,788 | -123 (-3.1%) |
| 쿠팡 주식회사 | 11,266 | 10,947 | -319 (-2.8%) |
쿠팡 주식회사는 중간 흐름이 더 흥미롭습니다. 2025년 12월분 12,260명까지 늘었다가 이후 9개월 연속 줄었습니다. 시작과 끝만 비교하면 이 흐름이 보이지 않습니다.
그런데 쿠팡 주식회사를 따라가다 문제가 하나 더 나왔습니다. 2026년 6월분까지는 우편번호가 05510이었는데, 7월분부터 05050으로 바뀌었습니다. 사업장명과 우편번호로 사업장을 구분했다면 쿠팡 주식회사는 22개월짜리 사업장 하나와 3개월짜리 사업장 하나로 쪼개집니다. 1편에서 6자리 사업자번호를 키로 쓸 수 없었는데, 이번엔 우편번호도 바뀔 수 있다는 걸 확인했습니다.
위 표도 정확히는 "회사"가 아니라 "그 이름을 쓰는 사업장 한 곳"의 숫자입니다. 같은 회사가 여러 사업장으로 나뉘어 있으면 회사 전체 숫자와 다릅니다. 사업장을 어떤 키로 이어 붙이고, 회사 단위로 어떻게 묶을지는 5편 데이터마트 설계에서 다룹니다.
막힐 때
| 증상 | 원인 | 해결 |
|---|---|---|
| 다시 실행할 때마다 다운로드가 오래 걸림 | 파일을 받아 열어 봐야 기준월을 알 수 있음 | manifest의 파일 이름으로 먼저 거른다 (Step 3) |
| 목록이 0개로 나옴 | 포털 내부 요청 형식이 바뀜 | 개발자 도구 네트워크 탭에서 목록 요청을 다시 확인한다 |
기준월이 하나가 아님 에러 | 파일 하나에 여러 달이 섞임 | 저장하지 말고 원본을 직접 열어 확인한다 |
| 디스크가 부족함 | 원본 CSV를 압축 없이 보관 | gzip으로 보관하면 약 3분의 1이 된다 |
| 2025년 6월에 그래프가 계단처럼 튐 | 개인사업장이 새로 포함됨 | 25개월 추세는 법인 사업장(biz_type = '1')만 쓴다 |
재현 자료
아래 파일을 GitHub에 공개해 두었습니다. manifest의 sha256으로 제가 받은 파일과 같은지 확인할 수 있습니다.
backfill.py: 과거 파일 목록 조회, 기준월 확인, gzip 보관, manifest 기록build_monthly.py: raw → staging parquet 변환manifest.csv: 이번 실습에서 받은 25개 파일의 기준월, 행 수, 해시
다음 편
3편에서는 수집 주기가 완전히 다른 데이터를 다룹니다. 국민연금 데이터는 한 달에 한 번 바뀌지만, 서울 실시간 도시데이터는 5분마다 바뀌고 지난 값은 남지 않습니다. 직접 쌓지 않으면 사라지는 데이터를 어떻게 모으는지, 스케줄러가 왜 필요한지를 보여드립니다.