Pluto는 어떻게 혼자 스타크래프트를 배웠을까요?
Pluto는 단일 신경망으로 테란·저그·프로토스의 운영과 전투를 모두 플레이하는 스타크래프트: 브루드워 AI입니다. 자기 자신과 대국하는 셀프플레이 강화학습으로 배웠으며, 약 3억 1,500만 파라미터의 모델을 CPU에서 실행할 수 있습니다. 이 프로젝트를 살펴보면 AI의 판단 능력이 모델 크기뿐 아니라 보상, 기억, 행동 제약, 실행 타이밍에 의해 만들어진다는 것을 알 수 있습니다.
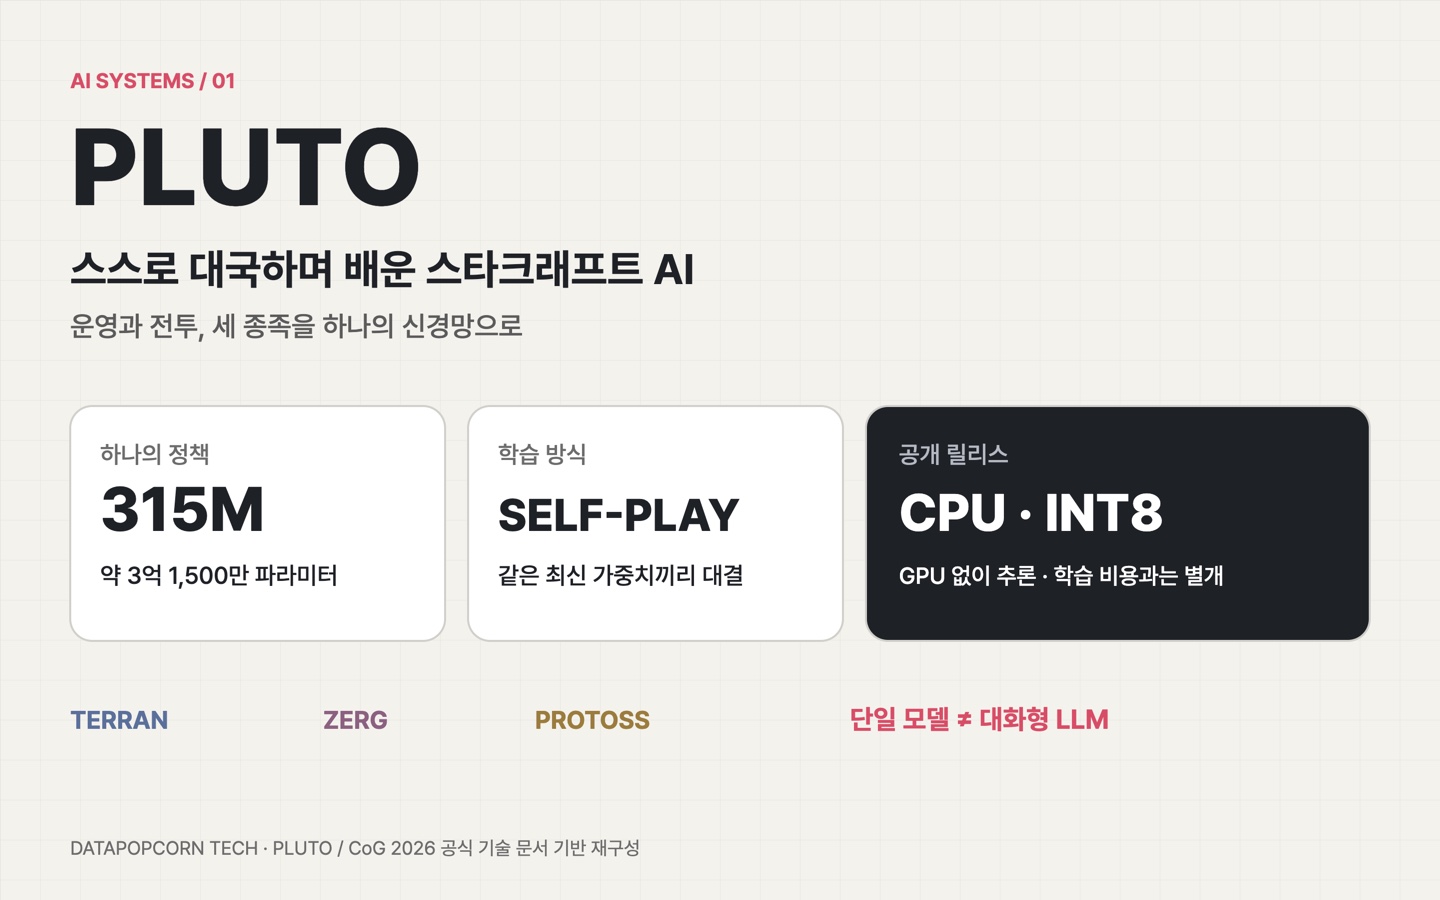
공식 기술 문서와 공개 릴리스에 근거해 DataPopcorn이 제작한 설명 이미지입니다. 실제 게임 화면이 아닙니다.
스타크래프트에서는 지금 일꾼을 더 생산할지, 병력을 모을지, 확장을 가져갈지 결정해야 합니다. 동시에 전투 중인 유닛을 움직이고, 정찰로 발견한 상대의 건물을 기억해야 합니다. 한 가지 판단만 잘해서는 이기기 어렵습니다.
Pluto의 흥미로운 점은 이런 판단을 하나의 모델로 묶었다는 데 있습니다. 이 글은 공식 GitHub README, CoG 2026 대회 제출 기술 문서, 2026년 9월 CPU 릴리스를 바탕으로 정리했습니다. 직접 실행하거나 성능을 재측정한 리뷰는 아니며, 대회 버전과 공개 버전의 차이를 구분해서 설명합니다.
운영과 전투를 같은 신경망이 맡습니다
스타크래프트의 플레이는 크게 매크로와 마이크로로 나눌 수 있습니다. 매크로는 자원 채취, 일꾼 생산, 건물 건설, 기술 개발, 확장 같은 운영입니다. 마이크로는 공격 대상 선택, 이동, 후퇴, 스킬 사용 같은 전투 조작을 뜻합니다.
드라군을 추가 생산할지는 매크로에 가깝고, 체력이 낮은 드라군을 뒤로 빼는 것은 마이크로에 가깝습니다. 실제 경기에서는 두 판단이 계속 얽힙니다. 전투에서 병력을 잃으면 생산 계획이 바뀌고, 확장에 자원을 투자하면 당장 싸울 병력이 줄어듭니다.
개발자의 기술 설명에 따르면 Pluto는 운영과 전투를 별도의 고정 전략 스크립트로 처리하지 않습니다. 동일한 가중치가 세 종족과 모든 종족 조합의 경기를 플레이합니다. 행동을 결정할 때마다 여러 미래를 탐색하는 대신, 신경망을 한 번 실행해 하나의 행동을 출력합니다.
여기서 신경망은 대화형 LLM을 뜻하지 않습니다. 게임 상태를 입력받아 다음 조작을 선택하는 정책 네트워크(policy network)입니다. Transformer가 들어 있다는 사실만으로 언어모델이라고 부를 수는 없습니다.
리플레이 없이 배우지만, 보상은 사람이 설계합니다
강화학습은 행동의 결과로 얻는 보상을 바탕으로 더 좋은 행동을 선택하도록 모델을 바꾸는 방법입니다. 셀프플레이는 그 연습 상대도 AI 자신이라는 뜻입니다. Pluto는 PPO 계열의 actor-critic 방식으로 처음부터 학습했다고 설명합니다.
Actor는 현재 상황에서 어떤 행동을 할지 선택하고, critic은 상황의 가치를 평가해 학습을 돕습니다. PPO 계열의 업데이트는 경험을 바탕으로 정책을 개선하면서 한 번에 지나치게 바뀌지 않도록 조절합니다. 다만 공개 문서는 이를 “PPO-style”이라고 표현하므로, 특정 공개 PPO 구현과 동일하다고 단정할 수는 없습니다.
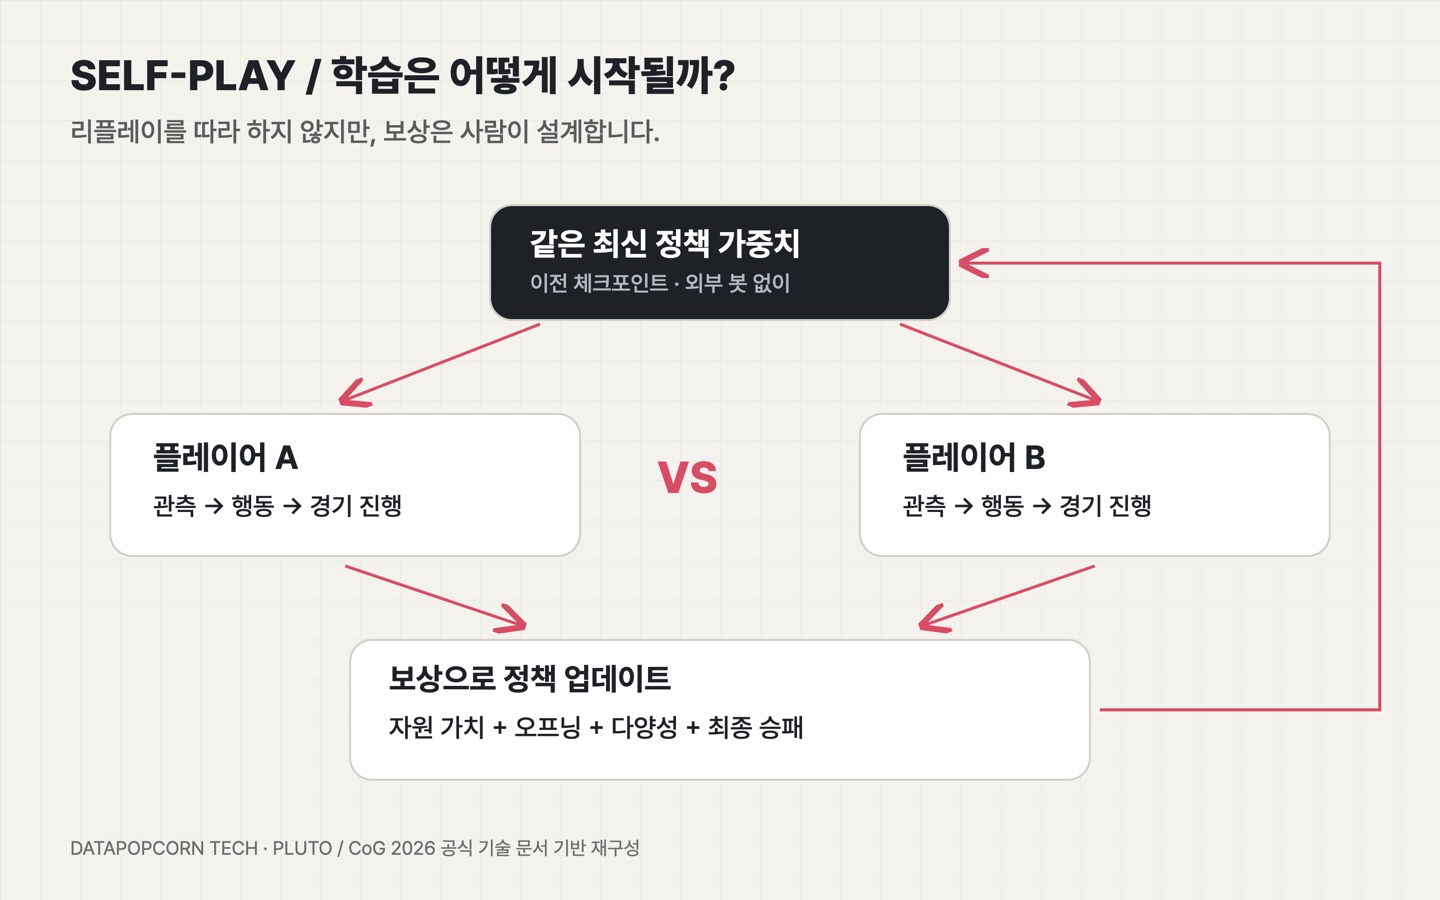
CoG 2026 기술 문서의 학습 방식을 단순화한 개념도입니다. 실제 학습 코드의 모듈 구성을 재현한 그림은 아닙니다.
Pluto는 인간 리플레이나 모방학습, 외부 봇을 사용하지 않았다고 명시합니다. 과거 버전의 자신을 상대하는 방식도 아닙니다. 모든 학습 경기에서 양쪽 플레이어가 같은 최신 가중치를 사용합니다.
승패만 알려주기에는 학습의 출발점이 너무 멉니다
스타크래프트는 최종 보상을 받기까지 시간이 오래 걸립니다. 아무것도 모르는 모델이 무작위로 조작하다가 생산과 전투를 익히고 우연히 승리하기를 기다리기는 어렵습니다. Pluto는 이를 해결하기 위해 중간 보상을 설계했습니다.
| 보상 | 학습에서 하는 역할 |
|---|---|
| 자원 가치 기반 점수 | 유닛의 미네랄·가스 비용을 바탕으로 생산과 상대 유닛 파괴를 유도합니다. 학습 초반의 주된 신호입니다. |
| 오프닝 보상 | 주어진 빌드오더를 느슨하게 따르도록 유도합니다. |
| 다양성 보상 | 덜 등장하는 유닛과 기술을 시도하도록 작은 보상을 줍니다. |
| 최종 승패 | 승리 +1, 패배 -1을 부여합니다. 학습 후반의 가장 강한 신호입니다. |
기술 문서에 따르면 이 보상은 모두 한쪽의 이득이 다른 쪽의 손해가 되는 제로섬 방식으로 적용됩니다. 따라서 “인간 플레이를 따라 배우지 않았다”는 말은 맞지만, “사람이 아무 지식도 넣지 않았다”는 말은 정확하지 않습니다. 무엇을 시도하고 무엇을 잘했다고 평가할지에는 설계자의 판단이 들어갑니다.
빌드오더는 강제 실행되는 스크립트가 아닙니다
학습에는 사람이 작성한 빌드오더 목록이 사용됩니다. 모델은 그 내용이 아니라 라벨을 전달받고, 해당 방향을 따를 때 보상을 얻습니다. 정해진 순서대로 반드시 실행해야 하는 규칙은 아닙니다.
문서에는 4Pool 라벨을 받아도 실제로는 9드론 스포닝풀을 선택할 수 있고, CCFirst 라벨에서도 배럭이나 팩토리를 먼저 건설할 수 있다는 예가 나옵니다. “반드시 이렇게 플레이하라”가 아니라 “이런 방향도 시도해 보라”에 가깝습니다. 스크립트 없는 플레이와 사람의 학습 유도는 함께 존재할 수 있습니다.
게임 화면 대신 구조화된 상태를 읽습니다
Pluto는 게임 화면의 픽셀을 보고 마우스를 움직이는 시스템이 아닙니다. 스타크래프트와 프로그램을 연결하는 BWAPI를 통해 게임 상태를 전달받습니다. 주요 입력은 다음과 같습니다.
| 입력 | 내용 |
|---|---|
| 유닛 | 종류, 위치, 체력, 속도, 현재 명령, 상태 등 |
| 지도 | 128×128 건설 타일 격자의 지형, 시야, 점유 상태 등 |
| 전역 정보 | 미네랄, 가스, 인구수, 상대 종족, 오프닝 조건 등 |
| 행동 이력 | 자신이 수행한 최근 4개 행동 |
| 기억 | 경기 전체에 걸쳐 유지하는 신경망 내부 상태 |
유닛은 각각 하나의 토큰, 즉 모델이 처리하는 정보 묶음으로 표현됩니다. 언어모델이 단어 조각을 토큰으로 다룬다면, 여기서는 유닛 속성을 하나의 단위로 다룹니다. 자신의 유닛에는 에너지와 생산·연구 상태 등 추가 정보도 들어갑니다.
정찰한 정보는 신경망이 기억해야 합니다
공식 문서상 Pluto에는 전장의 안개가 적용됩니다. 안개 속 상대 유닛을 그대로 관찰하는 방식이 아닙니다. 더 흥미로운 부분은 모델 바깥에서 마지막으로 본 상대 유닛, 확장, 기술을 별도의 장부에 기록하지 않는다는 점입니다.
정찰 유닛이 상대 스타게이트를 보고 죽었다고 생각해 보겠습니다. 이후 판단에 필요한 정보는 현재 관측에 없으므로 과거의 기억에 남아 있어야 합니다. Pluto는 정찰 정보를 기억하는 일 자체를 신경망에 맡깁니다. 이 요구가 모델 구조로 이어집니다.
Transformer와 GRU로 현재 관측과 과거를 연결합니다
Pluto는 공간 정보, 유닛 간 관계, 시간에 따른 기억을 함께 처리합니다. 지도를 다루는 합성곱 인코더, 유닛을 다루는 Transformer, 상태를 이어가는 GRU, 별도의 기억 장치가 결합돼 있습니다.
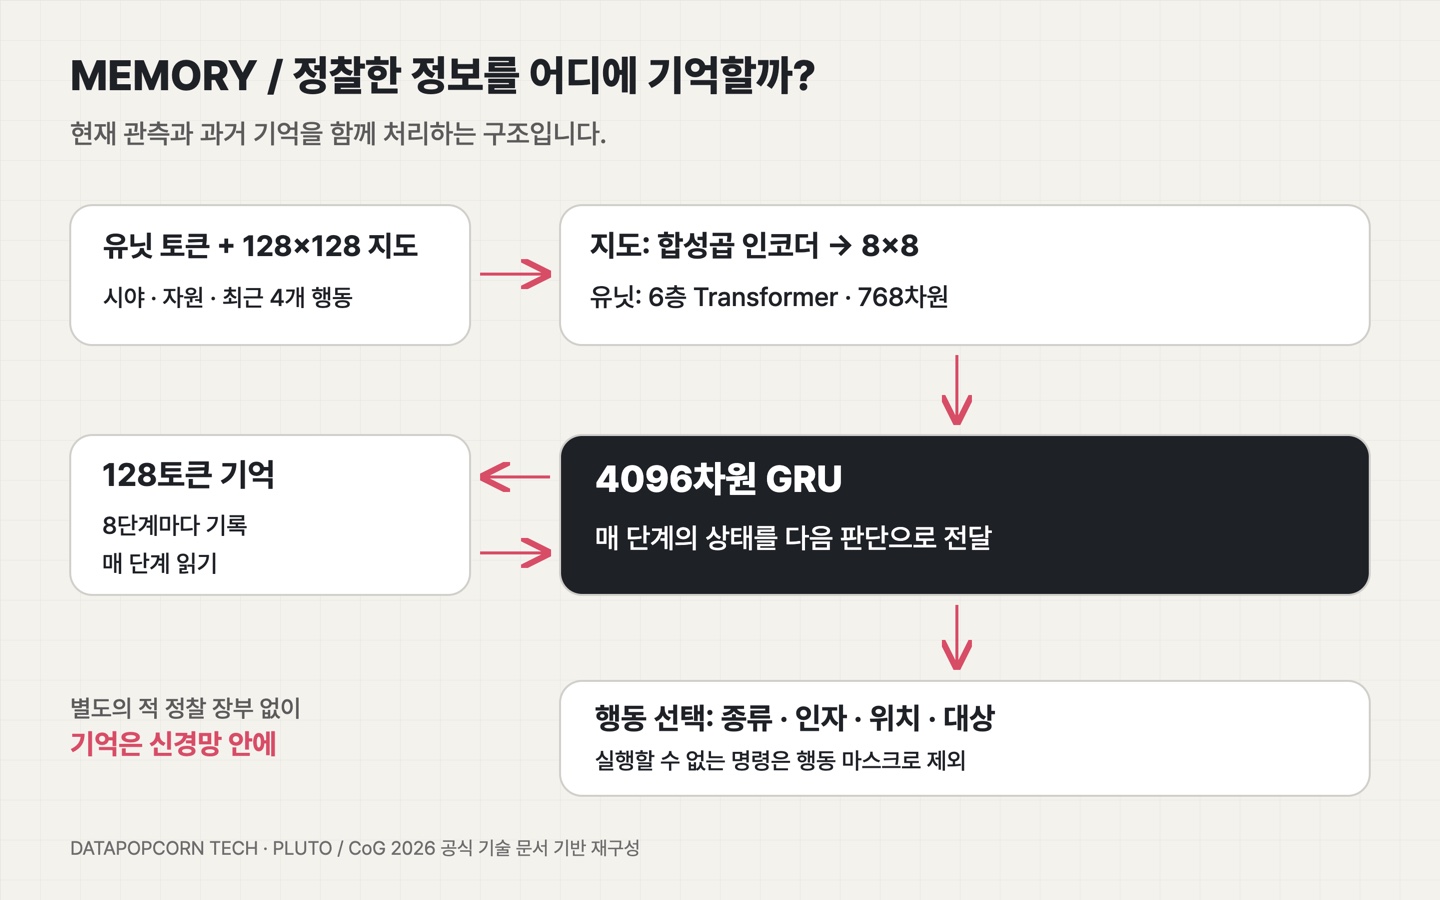
CoG 2026 기술 문서 기반의 단순화한 구조도입니다. 모든 입력·출력 연결과 학습용 critic은 생략했습니다.
공식 설명에 따르면 지도는 합성곱 인코더를 거쳐 8×8로 압축됩니다. 위치별 공간 특징이 더해진 유닛 토큰은 768차원의 6층 Transformer에서 처리됩니다. 4096차원의 GRU는 유닛과 지도에 대한 cross-attention을 사용하면서 단계 사이의 상태를 이어갑니다.
별도의 느린 기억은 128개 토큰 캐시를 다루는 Transformer입니다. 여기에 8단계마다 GRU 상태가 기록되고, GRU는 매 단계 이 기억을 읽습니다. “지금 보이는 것”과 “이전에 봤던 것”을 함께 판단하기 위한 구조입니다.
이 장치가 있다고 해서 정찰 정보를 항상 정확히 기억하거나 완벽한 장기 계획을 세운다고 단정할 수는 없습니다. 구조가 어떤 능력을 가능하게 하는지와 실제로 얼마나 잘 수행하는지는 다른 검증 문제입니다.
초당 약 4개 행동이지만 인간과 같은 인터페이스는 아닙니다
모델은 6게임 프레임마다 한 번, 단계당 하나의 행동을 선택합니다. 유닛 선택도 하나의 행동이며, 이동이나 공격 명령은 이후 단계에서 내립니다. 대회 기술 문서는 이를 게임 시간 기준 초당 약 4개 행동으로 설명합니다.
행동 출력은 순서대로 다섯 부분을 선택합니다. 무엇을 할지, 어떤 유닛·기술·생산 항목인지, 대략 어디인지, 그 영역의 정확히 어디인지, 어떤 유닛을 대상으로 할지입니다. 해당 행동에 필요 없는 뒷부분은 적용되지 않습니다.
또한 행동 마스크(action mask)를 적용합니다. 현재 선택 상태에서 실행할 수 없는 명령을 선택 대상에서 제외하는 장치입니다. 모델에게 모든 명령을 무작정 시도하게 두는 대신 게임의 실행 가능 조건을 반영합니다.
반응 지연만 같다고 대결 조건까지 같지는 않습니다
기술 문서상 명령은 판단에 사용한 관측으로부터 4프레임 뒤 적용됩니다. 6프레임의 판단 간격을 고려하면 새로운 상황에 대한 반응에는 4–10프레임, 약 170–420ms가 걸립니다. 그렇다고 인간 인터페이스의 모든 제약을 재현한 것은 아닙니다.
- 한 번에 선택할 수 있는 유닛 수에 12기 제한이 없습니다.
- 가상 카메라가 없어 화면을 옮길 필요가 없습니다.
- 탐색한 지도 전체 범위의 관측 가능한 정보를 한꺼번에 처리하고 행동할 수 있습니다.
따라서 “반응 속도가 사람과 비슷하니 조건도 같다”는 결론은 피해야 합니다. 게임에 표시되는 APM을 모델의 의사결정 횟수와 동일하게 해석하는 것도 적절하지 않습니다. 전장의 안개, 관측 범위, 조작 제약을 각각 구분해서 봐야 합니다.
상대별 적응은 신경망 재학습과 다릅니다
Pluto는 상대별 승패 기록을 파일에 저장하고, 그 기록을 바탕으로 다음 경기의 오프닝을 고릅니다. 이때 밴딧(bandit) 방식이 사용됩니다. 밴딧은 잘되는 선택지를 활용하면서 다른 선택지도 시험하는 문제를 다루는 방법입니다.
어떤 상대에게 특정 오프닝이 잘 통했다면 이후 선택에 그 결과를 반영하는 식입니다. README는 상대별 빌드 통계 파일을 매 경기 다시 읽는다고 설명합니다. 이것이 공개 문서에 나온 경기 간 적응입니다.
오프닝 선택이 바뀌는 것과 신경망 자체가 재학습되는 것은 다릅니다. 사용자의 PC에서 한 판 할 때마다 3억 개가 넘는 파라미터를 다시 학습한다고 해석해서는 안 됩니다. 학습 단계의 정책 업데이트와 실행 단계의 선택 전략은 분리해 읽어야 합니다.
CPU 배포에서 중요한 것은 계산량과 타이밍입니다
2026년 9월 공개 릴리스는 CPU 추론을 지원합니다. 모델 가중치는 int8 형식이며, 32비트 BWAPI 모듈과 별도의 64비트 추론 엔진이 공유 메모리로 통신합니다. 오래된 32비트 게임 안에 추론 엔진 전체를 넣는 대신 프로세스를 분리한 구조입니다.
README에 따르면 실행 중 네트워크 연결을 만들지 않습니다. 주요 실행 조건은 브루드워 1.16.1, BWAPI 4.4.0, 64비트 Windows 또는 Wine, AVX2 지원 x86-64 CPU입니다. 6코어 이상과 약 2GB의 여유 메모리를 권장하며, AVX-VNNI 지원 CPU를 강하게 권장합니다.
개발자가 제시한 추론 시간은 최근 데스크톱 CPU에서 단계당 약 20ms, 유닛 200기가 있는 상황의 i5-12500T에서는 약 60ms입니다. 대규모 후반 전투에서는 최대 약 3배 길어질 수 있습니다. 이 수치는 직접 측정한 벤치마크가 아니며, CPU에서 실행된다는 사실이 학습에도 GPU가 필요 없었다는 뜻은 아닙니다.
공개 버전은 늦은 계산을 기다리는 방식으로 바뀌었습니다
현재 공개 버전은 기본적으로 CPU 계산이 늦으면 다음 프레임에서 결과를 기다립니다. 학습 때 기대한 행동 타이밍을 유지하기 위해 게임 진행이 느려지는 쪽을 택합니다. README의 기본 프레임 예산은 40ms입니다.
반면 대회 제출 문서는 44ms의 프레임 예산을 설명하며, 계산이 늦으면 명령이 늦게 적용되거나 단계가 건너뛰어질 수 있다고 명시합니다. 대회에 제출한 설정은 추론을 8개 스레드에 고정했지만, 현재 공개 버전은 기본적으로 최대 6개를 사용하고 벤치마크로 조정할 수 있습니다. 서로 다른 버전의 숫자를 섞으면 안 되는 이유입니다.
공개 릴리스 설명에 따르면 모델·가중치·추론 엔진은 대회와 같고 BWAPI 모듈은 새 빌드입니다. BWRL_STRADDLE=1은 늦은 결정을 나중 프레임으로 넘기는 대회 동작을 복원합니다. 같은 가중치를 쓰더라도 실행 환경과 지연 처리 방식이 달라지면 플레이가 달라질 수 있습니다.
실시간 AI에서는 모델의 판단뿐 아니라 결과가 도착하는 시점도 성능의 일부입니다. 학습 때 없었던 지연이 생기면 모델이 익힌 행동의 전제가 달라집니다.
대회 우승과 공개 소스의 범위는 따로 봐야 합니다
Pluto는 CoG 2026 공식 결과에서 결승 상대 PurpleWave를 4대 1로 꺾고 우승했습니다. 공식 기록으로 확인할 수 있는 성과입니다. 다만 해당 대회 조건에서 다른 봇을 상대로 거둔 결과이지, 모든 인간 프로게이머나 모든 실행 환경에 대한 결론은 아닙니다.
현재 GitHub 저장소는 바이너리 릴리스 저장소라고 명시돼 있습니다. 실행 파일과 모델 가중치를 받아 플레이하는 것과, 학습 코드를 수정해 같은 모델을 재현하는 것은 다른 일입니다. GitHub에 있다는 이유만으로 완전한 오픈소스 학습 프로젝트라고 소개하는 것은 피하는 편이 정확합니다.
이번에 확인한 공식 문서만으로는 전체 학습 시간과 연산 비용, 학습 경기 수, 전체 하이퍼파라미터를 확정할 수 없습니다. 재현 가능한 학습 소스코드와 절차, 바이너리·가중치의 상업적 이용 및 재배포 허용 범위도 별도 확인이 필요합니다. 공개 다운로드 가능 여부와 재사용 권한은 같은 질문이 아닙니다.
모델 하나보다 전체 시스템을 보는 사례입니다
Pluto를 살펴보며 가장 눈에 남는 것은 “혼자 배웠다”는 표현 뒤에 있는 설계입니다. 인간 리플레이가 없어도 보상과 입력을 설계해야 합니다. 정찰 정보를 활용하려면 기억 장치가 필요하고, 실시간으로 행동하려면 계산 지연까지 다뤄야 합니다.
Pluto는 신경망이 스타크래프트에서 이겼다는 사실을 넘어, 학습한 판단을 실제 환경에서 일관되게 실행하려면 무엇을 함께 설계해야 하는지 보여줍니다. 다른 AI 에이전트를 볼 때도 입력, 보상, 기억, 행동 제약, 실행 타이밍을 나눠 살펴보면 모델 이름만으로는 보이지 않던 차이가 드러납니다.
더 깊게 살펴보고 싶다면 대회 기술 문서의 Model과 Training signal부터 읽는 것을 권합니다. 직접 실행하려는 경우에는 이전 대회 설명보다 현재 GitHub README와 해당 릴리스의 설치 조건을 우선 확인하는 편이 안전합니다. 바이너리는 서명돼 있지 않으므로, 배포 출처와 릴리스에 게시된 SHA-256도 함께 확인해야 합니다.
참고 자료
- Pluto GitHub README: 현재 실행 조건, 설치, 로그와 상대별 기록
- CoG 2026 제출 기술 문서: 모델 구조, 입력·행동, 학습 보상
- CPU 공개 릴리스: 대회 버전과의 차이, 바이너리와 체크섬
- CoG 2026 공식 결과: 대회 성과와 리플레이
문서 확인 기준: 2026년 9월 27일. 본문의 세 설명 이미지는 위 공식 자료를 바탕으로 DataPopcorn이 직접 제작했습니다.