설교 말씀 찾기: 유튜브 자동 자막 3,101편으로 '그 말씀, 어느 설교였지?'를 찾는 서비스를 만든 과정
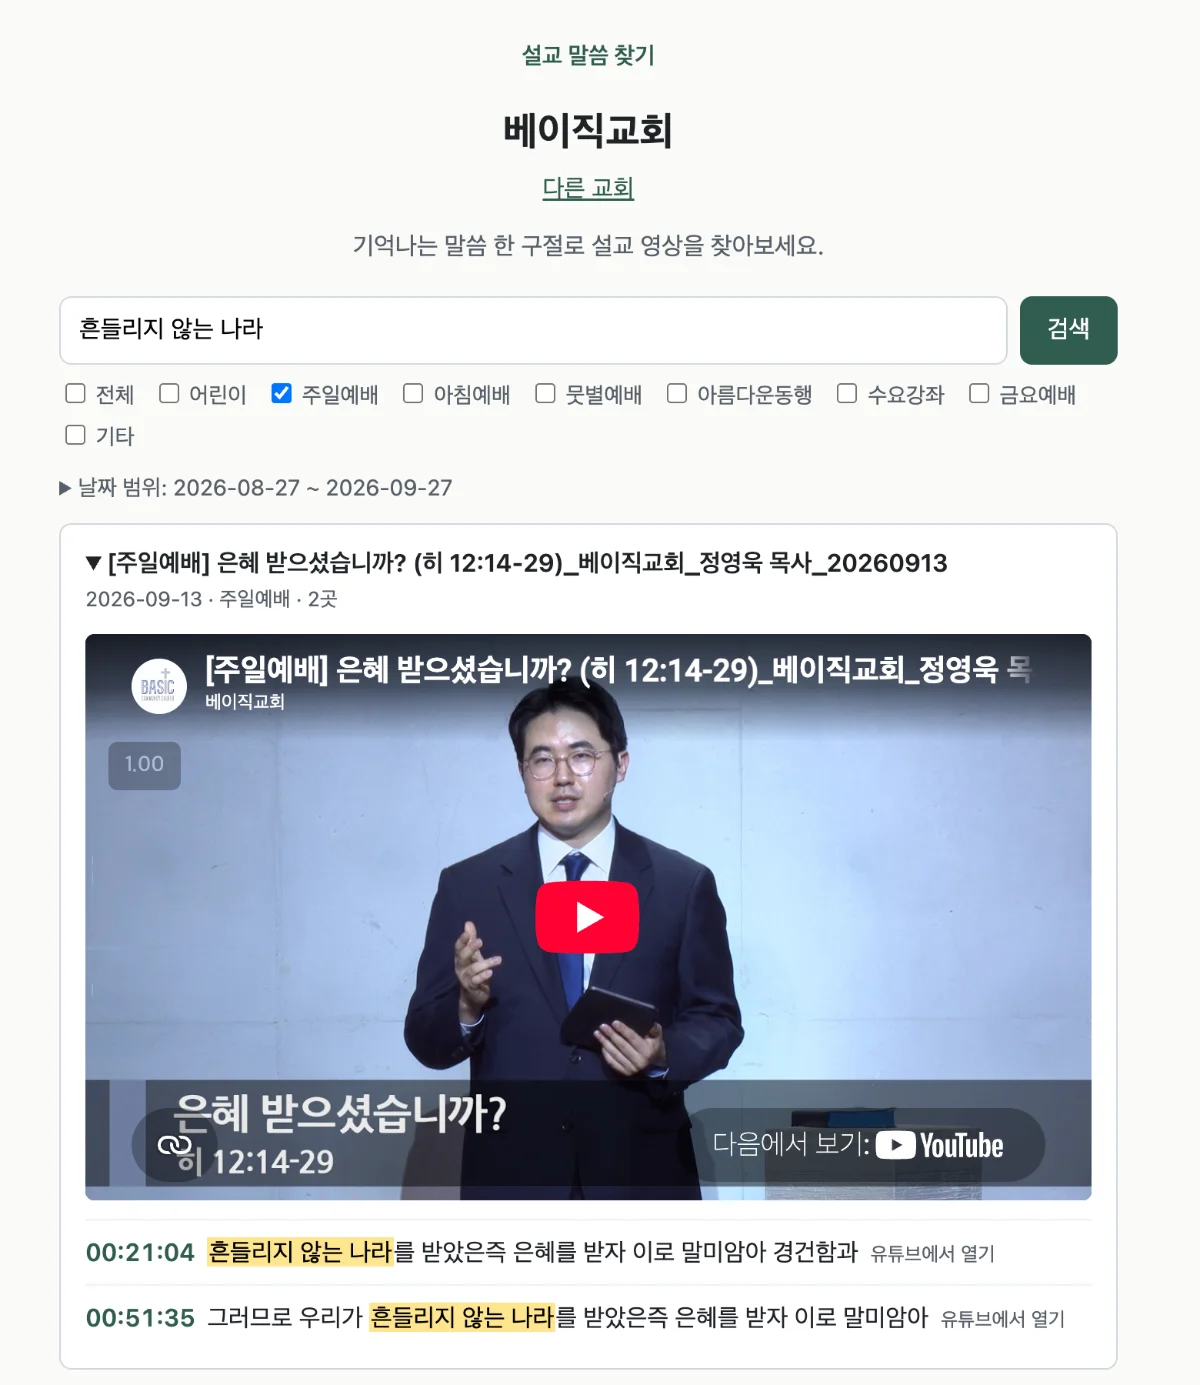
유튜브에 올라온 교회 설교의 자동 자막을 모아, "그 말씀 어느 설교에서 하셨더라?"를 한 구절로 찾게 해 주는 서비스 설교 말씀 찾기를 만들었습니다. 교회를 고르고 기억나는 말을 넣으면 그 말이 나온 설교 영상과 시각이 나오고, 시각을 누르면 그 자리부터 페이지 안에서 재생됩니다. 베이직교회 설교 3,101편을 색인했고, Cloudflare 무료 플랜 안에서 월 0원으로 돌아갑니다. 이 글은 왜 만들었는지, 어떻게 쓰는지, 그리고 이틀 동안 어떤 순서로 만들었고 어디서 막혔는지를 정리한 기록입니다.
왜 만들었나: 설교는 영상으로 남는데, 말로는 다시 찾을 수 없다
요즘 교회는 설교를 거의 다 유튜브에 올립니다. 베이직교회 채널에는 영상과 라이브 다시보기를 합쳐 5천 편이 넘게 쌓여 있습니다. 그런데 몇 주 전 설교에서 마음에 남았던 한 문장을 다시 들으려고 하면 방법이 마땅치 않습니다. 유튜브 검색은 제목과 설명만 보고, 설교 제목은 "은혜 받으셨습니까? (히 12:14-29)"처럼 본문과 주제만 알려줍니다. 결국 기억을 더듬어 날짜를 짐작하고, 40~50분짜리 영상을 앞뒤로 넘겨 가며 찾게 됩니다.
같은 문제를 이미 푼 서비스가 있었습니다. 침착맨 대사 찾기는 유튜브 자동 자막에서 원하는 말을 검색하면 그 말이 나온 영상과 시각을 보여줍니다. 방송인의 말투를 찾는 데 쓰이던 이 구조를 설교에 그대로 옮기면, "영상으로만 남던 설교"를 "말로 찾을 수 있는 설교"로 바꿀 수 있겠다고 생각했습니다.
누가 쓰면 좋은가
- 성도: 예배 때 들은 한 문장을 다시 듣고 싶을 때, 소그룹 나눔이나 큐티 전에 "지난달 목사님이 '흔들리지 않는 나라' 이야기하셨던 그 부분"을 찾을 때
- 목회자·교역자: 같은 본문이나 예화를 예전에 언제 어떻게 다뤘는지 확인하고 싶을 때
- 교회 미디어팀: 쌓여만 가는 설교 영상을 "검색되는 아카이브"로 바꾸고 싶을 때. 설정 파일에 채널 주소 한 줄을 넣으면 교회 하나가 추가됩니다
어떻게 쓰나
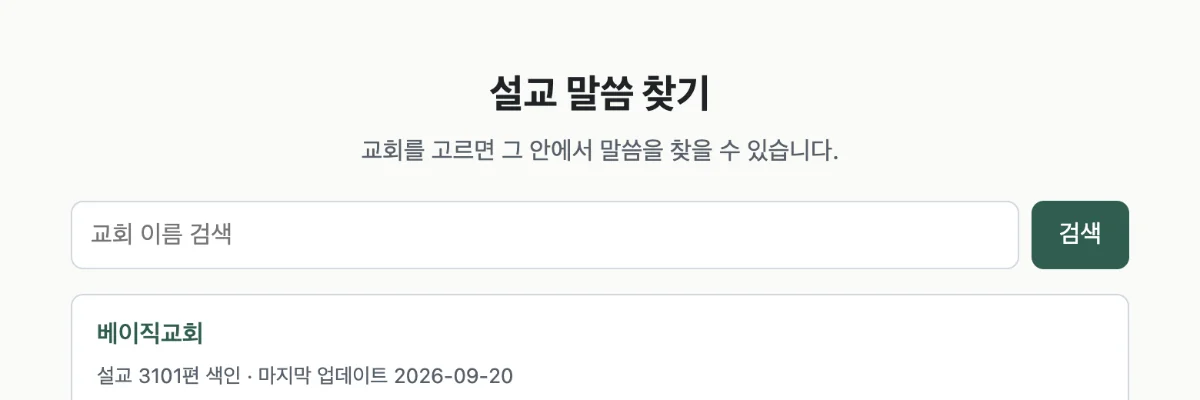
- 서비스 첫 화면에서 교회를 고릅니다. 지금은 베이직교회 한 곳이 등록돼 있습니다.
- 기억나는 말을 2~50자로 넣습니다. 띄어쓰기는 무시하므로 "흔들리지않는나라"로 넣어도 됩니다.
- 예배 종류(주일예배, 아침예배, 뭇별예배, 수요강좌 등)와 날짜 범위로 좁힙니다. 기본값은 주일예배, 최근 1개월입니다.
- 결과는 영상별로 묶여 나옵니다. 시각(예:
00:21:04)을 누르면 그 영상 블록 안의 플레이어가 해당 시점부터 재생되고, "유튜브에서 열기"를 누르면 유튜브로 이동합니다. - 검색 결과 주소를 그대로 공유하면 받는 사람도 같은 결과를 봅니다.
자막은 유튜브 자동 자막이라 성경 인명·지명이 틀리게 적혀 있는 경우가 있습니다. 찾는 말이 안 나오면 비슷한 발음으로 한 번 더 검색해 보는 것이 요령입니다.
만든 과정 1: 코드보다 먼저 자막 20편을 실측했다
작업은 Claude Code로 했습니다. 설계 문서를 먼저 쓰고, 그 문서로 태스크 단위 구현 계획을 만든 뒤, 태스크마다 구현과 리뷰를 반복하는 방식입니다. 그런데 설계 문서의 첫 결정은 "화면보다 자막부터 본다"였습니다. 설교는 길고, 오래된 영상이나 라이브 다시보기는 자막이 없는 경우가 많다고 알려져 있어서, 자막이 부족하면 컨셉 자체가 성립하지 않기 때문입니다. 기준은 "최근 3년 설교의 자막 보유율 70% 이상이면 진행, 미달이면 음성 인식 같은 대안을 따로 논의"로 정했습니다.
yt-dlp로 채널 전체를 열거한 뒤 연도별로 흩어 뽑은 20편의 자막을 받아 봤습니다.
| 측정 | 결과 | 설계에 준 영향 |
|---|---|---|
| 채널 영상 수 | 5,156편 (영상 탭 2,037 + 라이브 탭 3,119) | 두 탭을 모두 소스로 지정 |
| 한국어 자막 보유율 | 20편 중 20편, 2016~2026년 전 구간 | 진행(Go). 음성 인식은 범위에서 뺌 |
| 수동 자막 | 0편, 전부 자동 자막 | 오인식 안내 문구를 화면에 상시 노출 |
| 영상당 텍스트 | 공백 제거 후 평균 9,060자 | 전체 약 350MB로 추정, D1 한 개(500MB)에 들어감 |
| 수집 시간 | 영상당 평균 3.4초 | 영상 사이 5~10초 대기를 넣어도 1천 편당 약 3시간 |
실측은 제목 필터 기본값도 바로잡았습니다. 처음에는 제목에 "찬양", "광고"가 들어간 영상을 설교가 아니라고 보고 거르려 했는데, 5,156편 제목을 전부 확인해 보니 "찬양"은 "하나님을 찬양하라 (시편 46:1-9)" 같은 실제 설교 16편을 잘못 거르고, "광고"는 한 편에도 걸리지 않았습니다. 필터는 빈 배열로 두고, 10분 미만 영상만 길이로 걸렀습니다.
만든 과정 2: 무료 플랜의 한도가 구조를 정했다
처음 설계안은 Vercel에 SQLite 파일을 함께 올리는 방식이었지만, 데이터를 갱신할 때마다 재배포해야 하는 문제가 있었습니다. 그래서 Cloudflare Workers + D1 + Hono로 바꿨습니다. 수집은 로컬 PC에서 하고, D1은 배포용 사본으로만 씁니다.
- 수집은 로컬 PC에서만 합니다. GitHub Actions 같은 데이터센터 IP에서는
yt-dlp가 유튜브 봇 검사에 막히는 일이 흔합니다. 유튜브가 요청을 막으면(429) 재시도로 두드리지 않고 즉시 멈추고, 다음 실행 때 이어서 진행합니다. 스로틀이 아닌 오류가 5건 연속 나면yt-dlp가 고장 난 것으로 보고 멈추게 했습니다. 이 장치가 없으면 고장 난 수집기가 5천 편을 전부 "실패"로 표시해 버립니다. - 화면은 클라이언트 자바스크립트 없이 서버에서 그립니다. 화면이 사실상 하나뿐이라 Next.js 같은 프레임워크는 무료 Worker의 크기·CPU 한도(요청당 10ms)에 비해 과했습니다.
- API 토큰을 코드나 설정에 두지 않습니다. D1 반영은
wrangler의 로그인 세션을 씁니다. 자막은 외부에서 온 신뢰할 수 없는 데이터라서, 반영용 SQL을 만드는 함수는 하나로 몰고'); DROP TABLE chunks;--같은 악의적 자막으로 테스트했습니다.
만든 과정 3: 두 글자 검색어 때문에 인덱스를 포기했다
검색 설계에서 가장 중요한 숫자는 D1의 하루 500만 rows read(읽은 행 수) 한도였습니다. 자막을 한 줄씩 행으로 저장하면 설교 1천 편만 돼도 약 80만 행이 되고, 드문 단어 검색 한 번이 80만 행을 읽습니다. 하루 여섯 번이면 한도가 끝납니다.
그렇다면 전문 검색 인덱스(SQLite FTS5)를 쓰면 되지 않을까 싶었는데, 로컬에서 시험해 보니 트라이그램 인덱스는 "은혜" 같은 두 글자 검색어를 찾지 못했습니다. 교회에서 많이 찾을 말(은혜, 믿음, 사랑, 기도)은 두 글자가 많습니다. FTS5는 D1 내보내기(export)까지 막는다는 제약도 있었습니다.
그래서 방향을 반대로 잡았습니다. 인덱스로 빨리 찾는 대신, 설교 하나를 6,000자 안팎의 큰 덩어리(청크) 2~5개로 묶어 행 수 자체를 줄이고 그냥 훑습니다.
- 청크 경계에 걸친 문장도 찾을 수 있도록 각 청크 뒤에 다음 청크의 앞부분을 50자(검색어 최대 길이) 이상 겹쳐 붙입니다.
- 자동 자막은 띄어쓰기가 제멋대로라("하나님의" / "하나님 의") 색인과 검색어 모두 공백을 지우고 비교합니다. 수집기와 Worker가 같은 정규화 파일을 import하게 했습니다. 둘이 어긋나면 검색이 에러 없이 조용히 틀리기 때문입니다.
- SQL은 "어느 청크에 있나"까지만 답하고, 청크 안에서 몇 분 몇 초인지는 Worker의 순수 함수가 계산합니다. 이 함수가 단위 테스트의 중심입니다.
로컬 실측에서 1만 행 규모 전체 스캔은 0.25~0.36초였습니다. 채널 5천여 편을 모두 올려도 드문 단어 검색 한 번이 약 2.1만 행을 읽는 계산이라, 하루 약 240번의 "아무 데도 없는 단어" 검색까지 무료로 버팁니다. 흔한 단어는 최신 영상 몇 편에서 바로 끝나서 훨씬 적게 읽습니다. 검색 기본값을 "최근 1개월"로 둔 것도 같은 이유입니다. 날짜 범위를 좁히면 인덱스 범위 스캔이 되어 읽는 행이 기간에 비례해 줄어듭니다.
만든 과정 4: 한 교회에서 여러 교회로, 서비스를 멈추지 않고
첫날 저녁 베이직교회 하나로 배포한 뒤, 요구 사항이 세 가지 늘었습니다. 교회를 수십 곳으로 늘릴 것, 예배 종류로 거를 것, 검색 결과에서 영상을 바로 볼 것.
여러 교회. D1은 무료 플랜에서 계정당 10개, 개당 500MB입니다. 같은 구조의 D1을 여러 개(shard) 두고, 0번 D1의 churches 표에 "어느 교회가 몇 번 D1에 있는지"를 적었습니다. 이미 있는 D1에 교회를 추가할 때는 Worker를 다시 배포할 필요가 없습니다.
예배 종류 필터. 제목 규칙이 교회마다 달라서, 교회별 설정에 정규식 규칙을 위에서부터 첫 매칭 순으로 둡니다. 베이직교회는 어린이, 주일예배, 아침예배, 뭇별예배, 아름다운동행, 수요강좌, 금요예배 7개이고, 아무것도 안 맞으면 "기타"입니다.
페이지 안 재생. 자바스크립트 없이 만들기 위해 영상마다 주소가 빈 <iframe name="p-영상ID">를 두고, 시각 링크가 target으로 그 iframe만 겨냥하게 했습니다. 누르기 전에는 유튜브 플레이어를 전혀 불러오지 않아 결과가 많아도 페이지가 가볍습니다. 여기서 한 번 막혔습니다. 보안 헤더 Referrer-Policy: no-referrer 때문에 유튜브가 오류 153(플레이어 구성 오류)을 내며 재생을 거부한 것입니다. 경로와 쿼리는 보내지 않고 출처(origin)만 보내는 strict-origin-when-cross-origin으로 한 단계 낮춰 해결했습니다.
무중단 이전. 이미 돌고 있는 서비스의 DB 구조를 바꾸는 일이라, 옛 코드와 새 코드가 모두 문제없이 도는 "추가만 하는 변경"을 먼저 적용하고, 새 Worker를 배포·확인한 뒤에야 옛 표를 지우는 변경을 적용했습니다. 두 변경을 한 파일에 넣었다면 "DB 변경 ↔ 새 코드 배포" 사이의 몇 초 동안 누군가는 반드시 오류 화면을 봤을 것입니다.
결과
| 항목 | 값 |
|---|---|
| 제작 기간 | 2026년 9월 19일 오전 설계 시작 → 같은 날 저녁 첫 배포 → 20일 오전 여러 교회 구조로 전환 |
| 커밋 | 55개 (설계·실측·구현·리뷰 수정 포함) |
| 테스트 | Node 단위 테스트, 로컬 D1 위 Worker 테스트, Playwright E2E로 약 200개 케이스 |
| 색인 | 베이직교회 설교 3,101편(2013년 11월 ~ 2026년 9월), 자막이 없어 빠진 영상 45편 |
| 운영 비용 | 0원 (Cloudflare Workers·D1 무료 플랜) |
| Worker CPU | 평상시 요청당 6 |
한계와 배운 점
- 자동 자막은 설교만 담지 않습니다. 예배 실황 영상에는 찬양 가사와
[음악]표시가 섞여 있어서, "은혜"로 검색하면 설교 본문보다 찬양 가사가 먼저 걸리기도 합니다. 설교 구간만 잘라 색인하는 기능은 아직 없습니다. - 수집이 끝나지 않았습니다. 채널 5,156편 중 3,101편만 올라갔고 약 2천 편은 대기열에 있습니다. 수집은 로컬 PC에서만 돌기 때문에, PC가 꺼져 있으면 새 설교도 들어오지 않습니다. 화면의 "마지막 업데이트 2026-09-20"이 그 상태를 그대로 보여줍니다.
- 무료 한도는 교회 수와 함께 나눠 씁니다. 검색 한 번의 비용은 그 교회 분량으로 고정되지만, 하루 500만 행은 계정 전체 합계입니다. 교회가 늘면 교회당 하루 검색 여유가 줄어듭니다. 월 5달러 유료 플랜으로 가면 두 한도가 모두 사라지고 코드는 그대로입니다.
- 설교는 교회의 콘텐츠입니다. 화면에는 검색어가 걸린 짧은 자막 조각과 원본 유튜브 영상만 보여주고, 교회를 늘릴 때는 해당 교회의 동의와 제외 요청 창구가 먼저 필요합니다.
- 배운 점 하나를 꼽자면, 실측이 설계를 바꿨습니다. 자막 보유율, 두 글자 검색어, 제목 필터, 오류 153은 모두 문서나 추측이 아니라 실제로 돌려 보고서야 알게 된 것들입니다.
다음 액션
- 전국 확장: 교회 수백 곳을 무료 한도 안에서 담는 설계를 마쳤습니다. 주일예배와 최근 1년 설교만 올리고, 1년이 지난 설교는 D1에서 빼는 방식입니다. 5곳 → 30곳 → 100곳 순서로 늘려 볼 계획입니다.
- 매주 새 설교를 자동으로 가져오는 주간 수집과, 교회가 직접 요청할 수 있는 "영상 삭제·제외 요청" 링크
- 커스텀 도메인을 붙여 같은 검색 결과를 캐시하고, 과도한 요청을 막는 규칙 추가
같은 설교 자막으로 "교회들이 성경의 어디를 설교하는지"를 한 줄 축 위에 쌓아 보는 형제 프로젝트도 있습니다. 과정은 교회들은 성경의 어디를 설교할까?에 정리했습니다.