TabPFN vs XGBoost, 튜닝 없는 AI 모델이 정말 이길까? 공개 데이터 8종으로 직접 비교하기
이 글과 연결된 글 보기
드래그로 이동 · 휠/두 손가락으로 확대 · 방향키로 글 선택 · 0으로 맞춤. 실선: 본문 링크, 점선: 시리즈·주제의 대표 연결.표시된 글 16편 목록
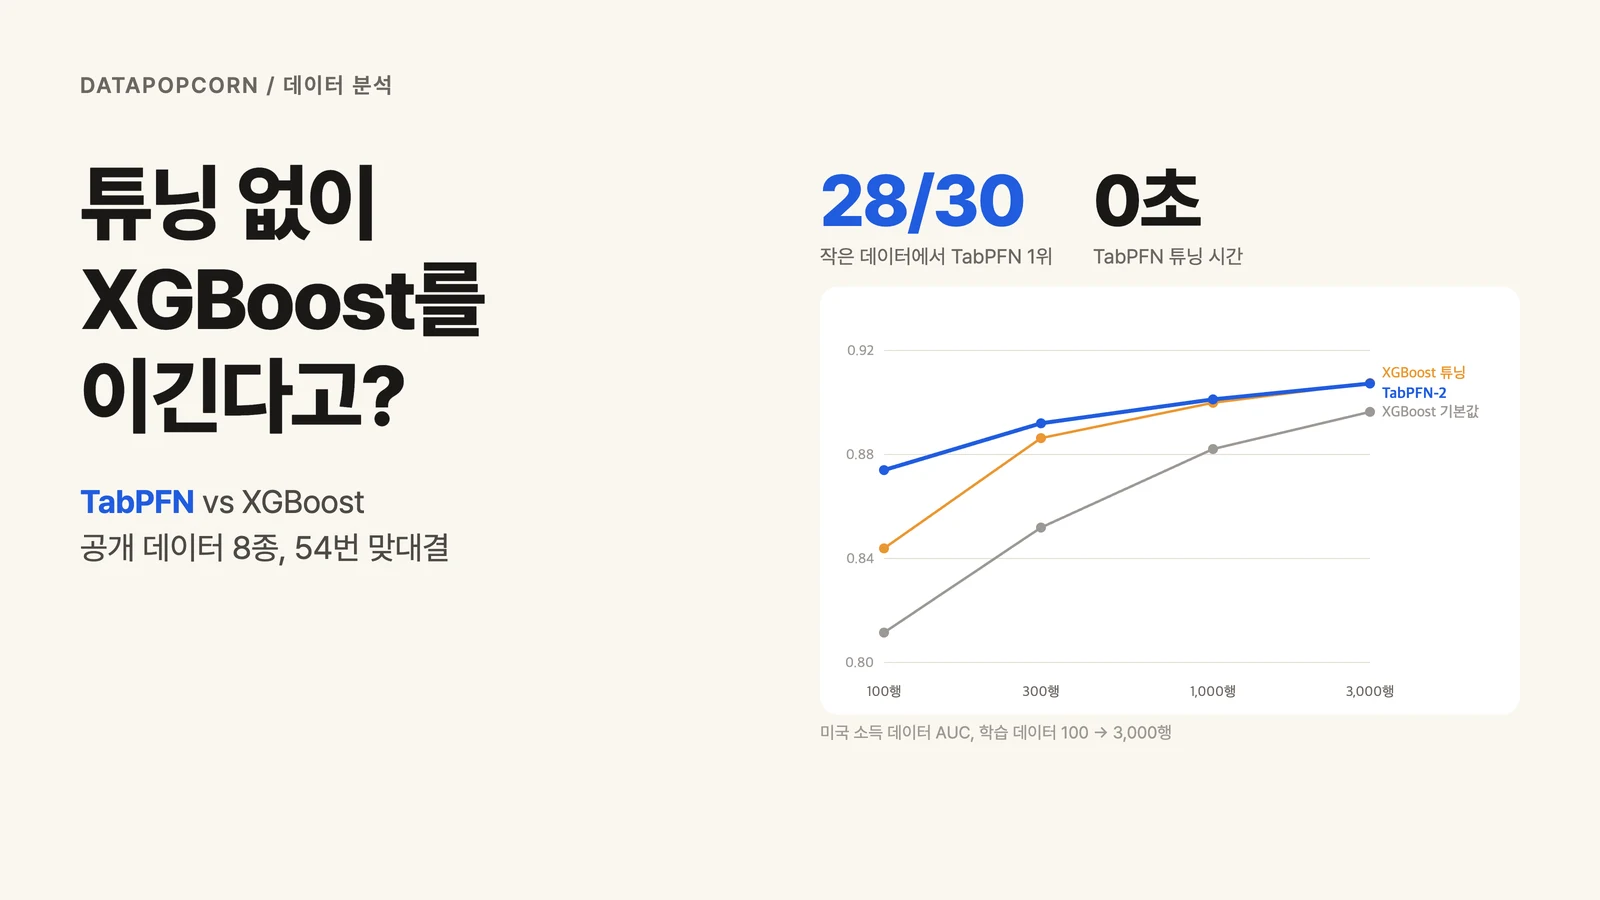
표 데이터 예측은 20년 가까이 XGBoost 같은 트리 모델의 무대였습니다. 그런데 표 데이터용 파운데이션 모델 TabPFN은 학습이나 튜닝 없이 표를 넣기만 하면 예측을 내놓습니다. 정말 튜닝한 XGBoost보다 나을까 싶어 공개 데이터 8종에서 직접 붙여 봤습니다. 1,000행 이하 작은 데이터에서는 Optuna로 30번 튜닝한 XGBoost를 30번 중 28번 이겼습니다. 학습 데이터가 3,000행으로 늘자 미국 소득 데이터에서는 AUC 0.9073 대 0.9075로 차이가 사라졌습니다. 이 글은 같은 비교를 Colab에서 그대로 재현하고, 내 데이터에는 어느 쪽을 먼저 쓸지 정하는 기준까지 8단계로 정리합니다.
- 작은 데이터는 TabPFN이 강합니다: 398~1,000행 데이터 6종을 5번씩 나눠 30번 비교했더니, 튜닝 없는 TabPFN-2가 28번 1위였습니다. 나머지 2번은 독일 신용평가 데이터에서 튜닝한 XGBoost가 근소하게 이겼습니다.
- 데이터가 적을수록 차이가 큽니다: 미국 소득 데이터를 100행만 써서 학습하면 AUC가 TabPFN 0.874, 튜닝한 XGBoost 0.844였습니다.
- 3,000행쯤에서 따라잡힙니다: 같은 데이터를 3,000행으로 학습하면 0.9073 대 0.9075로 사실상 같았습니다. 캘리포니아 집값은 3,000행에서도 TabPFN이 앞섰습니다.
- 대신 시간이 듭니다: GPU 없이 노트북 CPU로 돌리면 3,000행에서 TabPFN이 평균 47초, 튜닝을 포함한 XGBoost가 27초 걸렸습니다.
- 라이선스를 확인해야 합니다: 이 글은 출처 표기 조건이 붙은 Apache 2.0 라이선스라 상업적으로도 쓸 수 있는 TabPFN-2로 비교했습니다. 최신 2.5~3.5 버전 가중치는 비상업 라이선스입니다.
이 글은 이런 분께 필요합니다
사내 데이터로 예측 모델을 만들다 보면 행이 몇백 개뿐인 경우가 흔합니다. 이탈 고객 300명, 시범 매장 50곳, 설비 고장 기록 800건 같은 데이터입니다. 이런 데이터에서는 XGBoost를 아무리 튜닝해도 결과가 들쭉날쭉합니다.
- XGBoost·LightGBM으로 예측 모델을 만들어 봤고, 새로 나온 TabPFN이 실제로 나은지 궁금한 분
- 행 수가 적은 데이터로 예측 모델을 빨리 만들어야 하는 실무자
- 모델 비교 실험을 공정하게 설계하는 법을 연습하고 싶은 데이터 분석 입문자
코드를 직접 짤 필요는 없습니다. 아래 버튼으로 노트북을 열고 런타임 → 모두 실행을 누르면 이 글의 비교가 다시 돌아갑니다. API 키나 회원가입도 필요 없습니다.

Step 1. TabPFN이 무엇인지부터 잡고 갑니다
XGBoost는 데이터를 받을 때마다 처음부터 학습합니다. 나무를 수백 그루 키우면서 이 데이터의 패턴을 맞춰 가고, 나무 깊이나 학습률 같은 설정(하이퍼파라미터)을 잘 고를수록 성능이 올라갑니다. 실무에서는 Optuna 같은 도구로 설정을 수십~수백 번 바꿔 가며 튜닝합니다.
TabPFN은 반대로 이미 학습을 끝낸 모델입니다. 독일 프라이부르크 대학과 Prior Labs 연구진이 수백만 개의 가상 표 데이터로 "표를 보고 예측하는 방법" 자체를 미리 학습시켰습니다. 새 데이터를 넣으면 가중치를 다시 학습하지 않고, 학습용 행을 예시로 읽은 뒤 바로 예측합니다. ChatGPT에 예시 몇 개를 보여 주고 같은 형식으로 답하게 하는 방식과 비슷합니다.
2025년 1월 Nature에 실린 논문은 1만 행 이하 데이터에서 TabPFN이 기존 방법을 크게 앞선다고 밝혔습니다. 분류 문제에서는 2.8초 만에, 4시간 튜닝한 강한 모델들의 앙상블보다 나았다고 합니다. 이 글은 이 주장이 우리가 흔히 쓰는 공개 데이터에서도 맞는지 확인합니다.
Step 2. Colab에서 실습 환경을 준비합니다
노트북을 열면 먼저 런타임 → 런타임 유형 변경에서 T4 GPU를 고릅니다. GPU 없이도 돌아갑니다. 이 글의 시간 측정은 GPU 없는 CPU 기준입니다. 첫 셀은 TabPFN과 Optuna를 설치합니다. XGBoost와 scikit-learn은 Colab에 이미 있습니다.
!pip install -q "tabpfn==10.2.0" optuna
TabPFN 패키지는 기본값으로 최신 TabPFN-3.5 가중치를 받으려 합니다. 3.5는 Prior Labs 사이트에서 라이선스에 동의하고 API 키를 받아야 내려받아집니다. 이 글은 가입 없이 받을 수 있고 상업적으로도 쓸 수 있는 TabPFN-2를 명시해서 씁니다.
from tabpfn import TabPFNClassifier
from tabpfn.constants import ModelVersion

model = TabPFNClassifier.create_default_for_version(ModelVersion.V2, device="cuda")
Step 3. 비교 규칙을 먼저 정합니다
모델 비교는 규칙이 공정하지 않으면 의미가 없습니다. 이번 실험은 아래 규칙을 지켰습니다.
| 항목 | 규칙 |
|---|---|
| 비교 모델 | XGBoost 기본값 / XGBoost + Optuna 30회 튜닝 / TabPFN-2 튜닝 없음 |
| 튜닝 방식 | 학습 데이터 안에서만 3겹 교차검증. 테스트 데이터는 튜닝에 쓰지 않음 |
| 튜닝 범위 | 나무 수 50 |
| 평가 지표 | 분류는 AUC(높을수록 좋음), 회귀는 RMSE(낮을수록 좋음) |
| 반복 | 같은 분할을 세 모델에 똑같이 쓰고, 분할을 바꿔 여러 번 반복 |
데이터는 누구나 받을 수 있는 공개 데이터 8종입니다.
| 데이터 | 행 · 열 | 예측 대상 | 실험 |
|---|---|---|---|
| 유방암 진단 | 569 · 30 | 악성 여부 | ① |
| 독일 신용평가 | 1,000 · 20 | 신용 불량 여부 | ① |
| 피마 원주민 당뇨 | 768 · 8 | 당뇨 여부 | ① |
| 헌혈 재방문 | 748 · 4 | 다시 헌혈했는지 | ① |
| 당뇨 진행도 | 442 · 10 | 1년 뒤 진행 수치 | ① |
| 자동차 연비 | 398 · 7 | 연비(mpg) | ① |
| 미국 소득 (adult) | 48,842 · 14 | 연소득 5만 달러 초과 여부 | ② |
| 캘리포니아 집값 | 20,640 · 8 | 지역 집값 중앙값 | ② |
실험 ①은 작은 데이터를 70:30으로 5번 나눠 30번 비교합니다. 실험 ②는 큰 데이터에서 테스트 2,000행을 떼어 놓고, 학습 데이터를 100, 300, 1,000, 3,000행으로 늘려 가며 3번씩 비교합니다.
Step 4. 세 모델을 같은 분할로 돌립니다
노트북의 run_three() 함수가 한 번의 분할에서 세 모델을 차례로 학습하고 평가합니다. 코드 길이를 비교하면 두 모델의 차이가 바로 보입니다. XGBoost 튜닝은 탐색 범위를 정하고 교차검증을 30번 돌리는 코드가 필요합니다.
def objective(trial):
    params = dict(
        n_estimators=trial.suggest_int("n_estimators", 50, 800, log=True),
        learning_rate=trial.suggest_float("learning_rate", 0.005, 0.3, log=True),
        max_depth=trial.suggest_int("max_depth", 2, 10),
        # ... 나머지 4개 설정
    )
    return cross_val_score(xgb_model(task, **params), X_train, y_train, cv=cv, scoring=scoring).mean()

study = optuna.create_study(direction="maximize")
study.optimize(objective, n_trials=30)
TabPFN은 모델을 만들고 fit, predict만 부르면 끝입니다. 문자열로 된 범주형 열은 정수로 바꾼 뒤, 몇 번째 열이 범주형인지만 알려 줍니다.
model = TabPFNClassifier.create_default_for_version(
    ModelVersion.V2, device=DEVICE, categorical_features_indices=cat_idx
)
model.fit(X_train, y_train)
pred = model.predict_proba(X_test)[:, 1]
여기서 fit은 학습이 아니라 학습 데이터를 기억해 두는 단계라 거의 즉시 끝납니다. 실제 계산은 predict에서 일어납니다. 시간은 반드시 예측까지 포함해서 재야 합니다.
Step 5. 결과 ①: 작은 데이터에서는 TabPFN이 거의 다 이깁니다
5번 분할의 평균입니다. 굵은 글씨가 가장 좋은 값입니다.
| 데이터 | 지표 | XGBoost 기본값 | XGBoost 튜닝 | TabPFN-2 |
|---|---|---|---|---|
| 유방암 진단 | AUC ↑ | 0.989 | 0.986 | 0.994 |
| 독일 신용평가 | AUC ↑ | 0.783 | 0.800 | 0.813 |
| 피마 원주민 당뇨 | AUC ↑ | 0.785 | 0.823 | 0.834 |
| 헌혈 재방문 | AUC ↑ | 0.673 | 0.718 | 0.740 |
| 당뇨 진행도 | RMSE ↓ | 65.6 | 57.2 | 55.1 |
| 자동차 연비 | RMSE ↓ | 3.16 | 2.85 | 2.56 |
30번의 분할 하나하나를 따지면 TabPFN-2가 28번 1위였습니다. 진 2번은 모두 독일 신용평가 데이터였고, 차이는 AUC 0.003~0.014였습니다.
유방암 진단 데이터에서는 튜닝한 XGBoost가 기본값보다 오히려 낮았습니다(0.986 대 0.989). 약 400행인 학습 데이터를 다시 3등분해서 고른 설정이 테스트 데이터에서는 맞지 않았습니다. 작은 데이터에서 튜닝이 늘 이득은 아니라는 뜻이고, 튜닝이 필요 없는 TabPFN이 유리한 이유이기도 합니다.
Step 6. 결과 ②: 데이터가 늘면 XGBoost가 따라옵니다
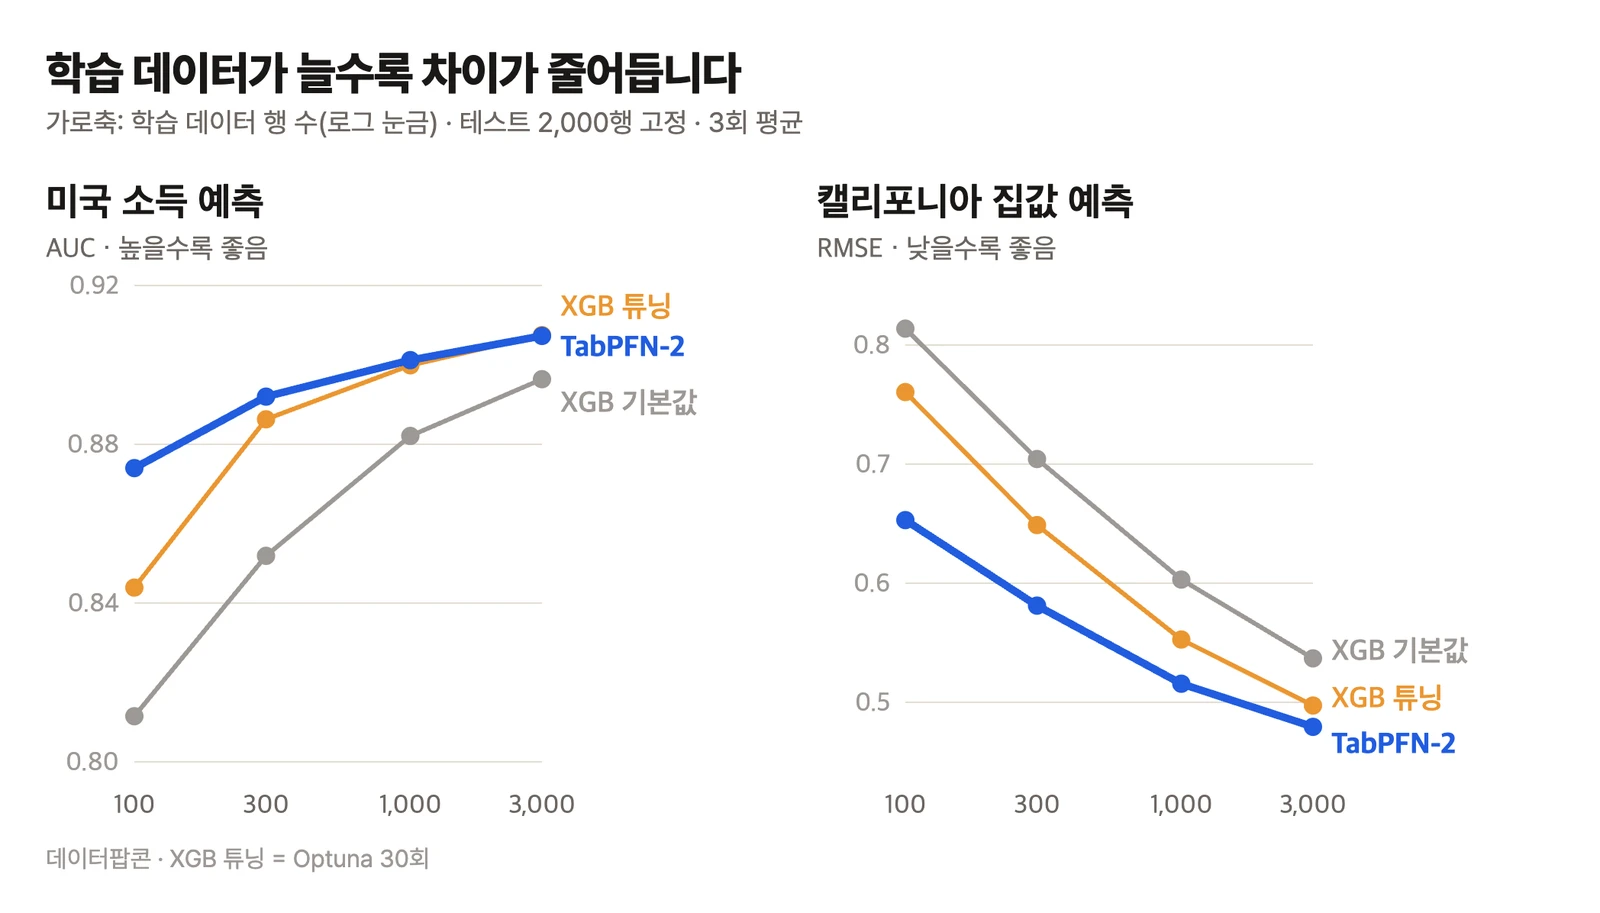
미국 소득 데이터는 100행일 때 TabPFN이 AUC 0.874로, 튜닝한 XGBoost(0.844)보다 0.03 높았습니다. 1,000행에서는 0.9012 대 0.8999로 차이가 줄었고, 3,000행에서는 0.9073 대 0.9075로 거의 같았습니다. 3번 반복 중 2번은 튜닝한 XGBoost가 이겼습니다.
캘리포니아 집값은 3,000행까지 12번 모두 TabPFN이 이겼습니다. 다만 RMSE 차이가 100행 0.11에서 3,000행 0.02로 줄었습니다. 두 데이터 모두 데이터가 많아질수록 XGBoost가 따라오는 흐름은 같았습니다.
Step 7. 걸린 시간까지 따져 봅니다
정확도만 보고 고르면 운영할 때 놓치는 부분이 있습니다. 아래는 학습과 예측을 합친 평균 시간입니다. 이 실험은 GPU 없이 Apple M4 노트북의 CPU로 돌렸습니다.
| 학습 데이터 | XGBoost 기본값 | XGBoost 튜닝(30회) | TabPFN-2 |
|---|---|---|---|
| 작은 데이터 6종 (278~700행) | 0.2초 | 14.6초 | 4.0초 |
| 100행 (테스트 2,000행) | 0.0초 | 7.3초 | 7.7초 |
| 1,000행 | 0.1초 | 18.9초 | 14.0초 |
| 3,000행 | 0.1초 | 27.2초 | 47.4초 |
튜닝까지 포함하면 작은 데이터에서는 TabPFN이 더 빨랐습니다. 3,000행에서는 TabPFN이 튜닝한 XGBoost보다 오래 걸렸습니다. 학습 데이터 전체를 예시로 읽으면서 예측하므로, 학습 행과 예측 행이 늘수록 계산량이 함께 늘어납니다.
한 번 만든 모델로 매일 수십만 건을 예측해야 하면 XGBoost가 훨씬 가볍습니다. 학습을 마친 XGBoost는 예측 비용이 거의 들지 않기 때문입니다. TabPFN은 CPU에서 돌리면 GPU를 쓰라는 경고를 띄웁니다. GPU 런타임에서의 시간은 노트북 마지막 셀에서 직접 확인해 보세요.
Step 8. 내 데이터에는 무엇을 먼저 쓸지 정합니다
이번 결과로 정리한 기준입니다.
| 상황 | 먼저 써 볼 모델 |
|---|---|
| 학습 데이터가 1,000행 이하 | TabPFN. 튜닝 없이 바로 기준선을 잡습니다 |
| 1,000~1만 행 | 둘 다 돌려 비교합니다. TabPFN 결과가 튜닝 목표치가 됩니다 |
| 1만 행 이상, 또는 매일 대량 예측 | XGBoost 튜닝. TabPFN-2의 권장 범위를 넘습니다 |
| 상업 서비스에 넣을 모델 | TabPFN-2 또는 Prior Labs 상업 라이선스 확인 |
가장 실용적인 사용법은 "XGBoost 튜닝 전에 TabPFN부터 한 번 돌려 보기"입니다. 코드 다섯 줄로 몇 초 만에 나온 점수가 튜닝으로 넘어야 할 기준선이 됩니다. 튜닝한 XGBoost가 그 점수를 못 넘으면, 그 데이터에서는 튜닝에 더 시간을 쓸 이유가 약합니다.
막힐 때
| 증상 | 원인 | 해결 |
|---|---|---|
TabPFNLicenseError: TabPFN requires a one-time license acceptance | 기본 모델(TabPFN-3.5)은 라이선스 동의가 필요함 | create_default_for_version(ModelVersion.V2)로 TabPFN-2를 명시하거나, Prior Labs에서 라이선스 동의 후 TABPFN_TOKEN 설정 |
| CPU에서 1,000행 넘는 데이터를 넣으면 경고나 오류 | TabPFN이 CPU에서 큰 데이터를 막아 둠 | GPU 런타임으로 바꾸거나 os.environ["TABPFN_ALLOW_CPU_LARGE_DATASET"] = "1" |
fetch_openml에서 TypeError: expected string or bytes-like object | 일부 OpenML 데이터를 pandas 파서가 못 읽음 | parser="liac-arff"로 다시 읽기 (노트북에 반영됨) |
맥에서 XGBoost Library (libxgboost.dylib) could not be loaded | OpenMP 라이브러리 없음 | 오류 메시지 안내대로 brew install libomp |
TabPFN 시간이 fit만 재면 0.1초로 나옴 | 실제 계산은 predict에서 일어남 | 시간 측정을 예측까지 포함하도록 묶기 |
이 비교의 한계
- TabPFN-2만 비교했습니다. 2026년 9월에 나온 TabPFN-3.5는 더 큰 데이터와 텍스트 열까지 다룬다고 발표됐지만, 이 글에서는 돌려 보지 않았습니다.
- XGBoost 튜닝은 30회입니다. 수백 회 튜닝하거나 LightGBM·CatBoost와 앙상블하면 결과가 달라질 여지가 있습니다.
- 데이터 8종, 이진 분류와 회귀만 봤습니다. 다중 분류, 시계열, 결측이 많은 데이터는 확인하지 않았습니다.
- 시간은 CPU 기준입니다. GPU에서는 TabPFN 시간이 크게 달라집니다. 정확도 숫자도 실행 환경에 따라 소수점 셋째 자리 정도 달라집니다.